[논문리뷰] Streaming Video Editing with Easy Adaptation
링크: 논문 PDF로 바로 열기
메타데이터
저자: Yujia Hu, Jiajun Li, Zihao He, Songhua Liu
1. Key Terms & Definitions (핵심 용어 및 정의)
- SVEET: Bidirectional video diffusion 모델의 지식을 streaming autoregressive 환경으로 직접 이전(transfer)하여 실시간 비디오 편집을 가능하게 하는 프레임워크입니다.
- Backbone Feature Disentanglement: 제어(control) 메커니즘을 기본 모델(backbone)과 분리하여 학습함으로써 사전 학습된 지식을 보존하는 설계 원칙입니다.
- Conditional Frame Independence: 소스 비디오 인코딩 시 시간적 의존성(temporal dependency)을 배제하여 인과적(causal) 스트리밍 환경과 호환되도록 하는 설계 원칙입니다.
- Orthogonal Decoupled Training (ODT): Bidirectional 모델과 streaming 모델 간의 feature 공간 불일치를 해결하기 위해, 제어 학습을 feature 변화의 주요 불일치 방향(discrepancy subspace)과 직교(orthogonal)하도록 제약하는 학습 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Bidirectional Diffusion Transformers(DiTs) 기반의 비디오 편집 기능을 재학습 없이 어떻게 스트리밍 환경으로 이전할 수 있는지에 대한 핵심 문제를 다룹니다 [Figure 1]. 기존의 비디오 편집 모델들은 전체 시퀀스를 한 번에 처리하는 Bidirectional 방식을 사용하여, 실시간 스트리밍 시 필요한 인과적(causal) 생성 제약을 위배합니다. 스트리밍 편집을 위해 모델을 처음부터 재학습하거나 증류(distillation)하는 방식은 막대한 컴퓨팅 자원을 소모하는 한계가 있습니다. 저자들은 학습된 편집 능력을 스트리밍 설정으로 직접 이전하여 비용 효율적인 실시간 비디오 편집을 가능하게 하는 새로운 패러다임을 제안합니다.
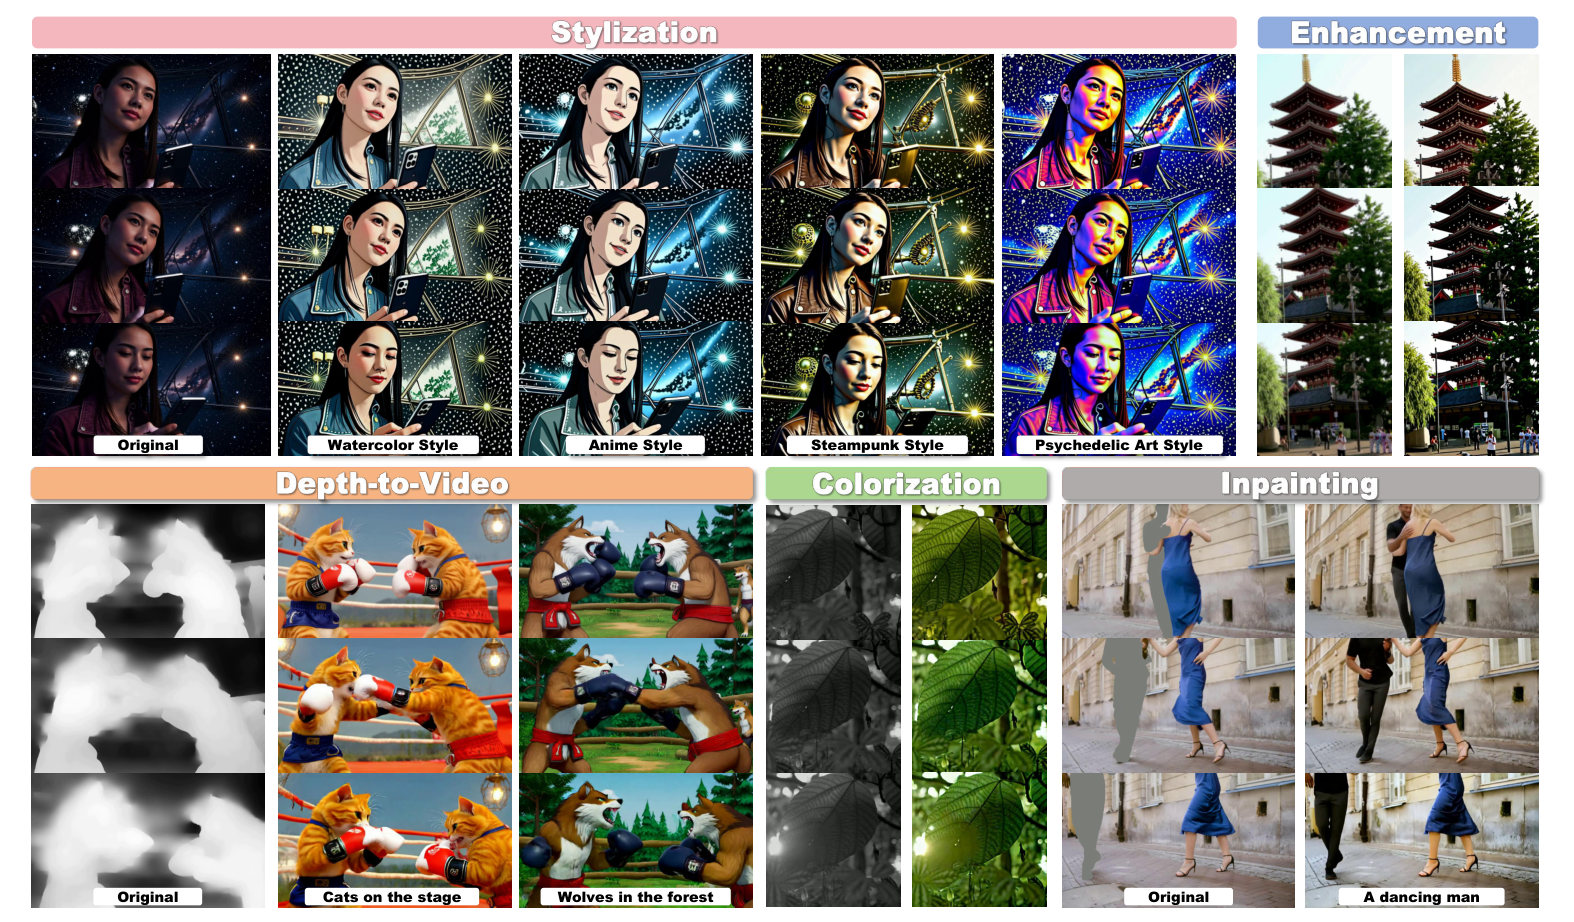
Figure 1 — SVEET 개요 및 편집 결과
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 학습된 Bidirectional 모델의 편집 능력을 스트리밍 backbone으로 효과적으로 전이하기 위해 SVEET 프레임워크를 제안합니다 [Figure 2]. SVEET는 Temporally Independent Control branch를 통해 프레임별 독립적인 인코딩을 수행하며, ODT를 통해 모델의 기능적 업데이트가 불일치 방향과 직교하도록 제약하여 feature 정렬 오류를 최소화합니다 [Figure 2]. 구체적으로, 제어 업데이트 방향이 Bidirectional과 Causal 모델 간의 가장 큰 변화(discrepancy)를 포착하는 subspace와 직교하게 설계함으로써 성능 손실을 방지합니다. 실험 결과, 제안 모델은 스타일 변환, 비디오 인painting, depth-to-video 편집 등에서 기존 방식 대비 높은 편집 정확도와 시간적 일관성을 보였습니다 [Table 1]. 특히 단일 H100 GPU 환경에서 별도의 가속 기술 없이 15 FPS의 실시간 성능을 달성하여, 기존 SDEdit+CF나 DayDream+CF 등의 베이스라인 모델보다 VLM 평가 및 VBench 지표에서 우월한 성능을 입증했습니다 [Table 1]. 또한 인간 평가 결과(User Study)에서도 제안 방법이 편집 정확도와 구조적 유지 측면에서 압도적인 선호도를 기록했습니다 [Table 3].
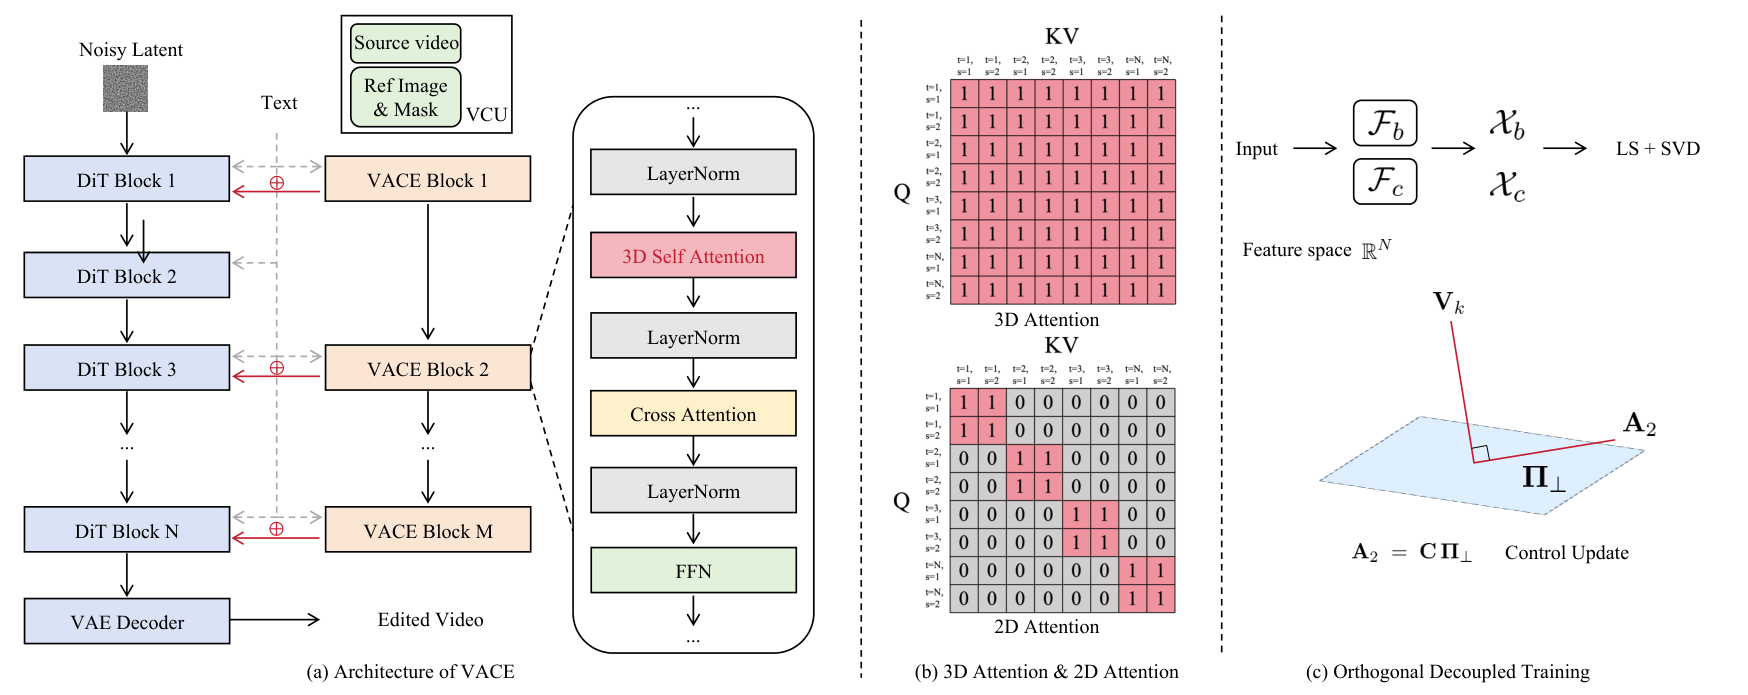
Figure 2 — SVEET 전체 아키텍처
4. Conclusion & Impact (결론 및 시사점)
본 논문은 사전 학습된 Bidirectional video diffusion 모델을 활용하여 별도의 추가 학습 없이 고품질 스트리밍 비디오 편집을 구현하는 SVEET를 제안합니다. 제안된 Temporally Independent Control과 ODT는 스트리밍 환경으로의 zero-shot transfer를 가능하게 하여, 실시간 비디오 콘텐츠 생성을 위한 효율적인 솔루션을 제공합니다. 본 연구는 막대한 컴퓨팅 비용이 드는 모델 재학습의 대안을 제시함으로써, 실시간 interactive 비디오 편집 분야의 학계 및 산업계 연구에 중요한 기틀을 마련했습니다.
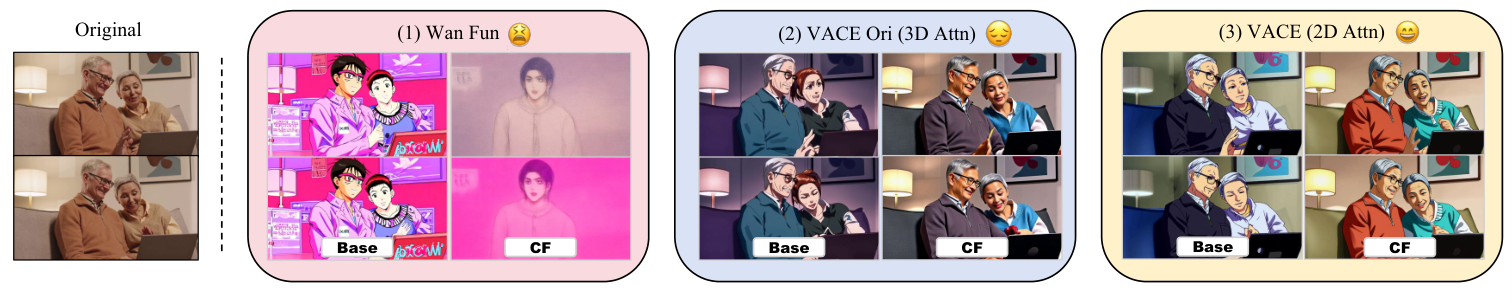
Figure 3 — 전이 전략 분석 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LiveEdit: Towards Real-Time Diffusion-Based Streaming Video Editing
- [논문리뷰] FlashWorld: High-quality 3D Scene Generation within Seconds
- [논문리뷰] AV-GRPO: Modality-Anchored Decoupling Diffusion Reinforcement Learning for Joint Audio-Video Generation
- [논문리뷰] VideoGen-Agent: Reinforcing Video Generation Agents
- [논문리뷰] Vidu S2: Real-Time Interactive, Editable, and Spatial Video Generation
Review 의 다른글
- 이전글 [논문리뷰] Realtime-Venus: A full-duplex interaction system with asynchronous delegation
- 현재글 : [논문리뷰] Streaming Video Editing with Easy Adaptation
- 다음글 [논문리뷰] The Functionalizer: Lossless Functional Decomposition for Subword Tokenization
댓글