[논문리뷰] The Functionalizer: Lossless Functional Decomposition for Subword Tokenization
링크: 논문 PDF로 바로 열기
저자: Connor Makowski, Willem Guter, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Functionalizer: orthographic(철자) 및 structural(구조적) 변이를 compositional한 opcode/operand 스트림으로 분해하는 lossless pre-tokenizer 프레임워크입니다.
- Opcode/Operand ISA: CPU의 명령어 세트 구조를 차용하여, 변환 연산(opcode)과 대상 토큰(operand)을 분리함으로써 토큰화 효율을 극대화하는 방식입니다.
- Unicode Private Use Area (PUA): 제안하는 opcode를 표준 tokenizer가 처리할 수 있도록 인코딩하는 영역으로, U+E000~U+EFFF 대역을 활용합니다.
- Merge Exhaustion: BPE tokenizer가 더 이상 병합할 수 있는 유효한 후보 쌍이 없을 때까지 수행하는 학습 과정입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 subword tokenizer가 겪는 vocabulary expansion(어휘 확장) 문제와 이로 인한 embedding space의 파편화를 해결하는 것을 목적으로 합니다. 기존의 subword tokenizer는 hello, Hello, Héllo와 같은 orthographic 변이들을 독립적인 어휘로 처리하거나, 이를 무시하기 위해 lossy normalization을 수행하여 모델의 downstream 성능을 저하시키는 딜레마에 직면해 있습니다. [Table 2]에서 볼 수 있듯, 이러한 surface form의 중복은 vocabulary slot을 비효율적으로 점유하며, 이는 거대 모델 학습 시 심각한 자원 낭비와 학습 효율 저하를 초래합니다. 본 논문은 이러한 surface form의 변이를 canonical base와 transformation operator로 분리하여 저장함으로써, 기존의 무차별적인 어휘 학습 방식을 개선해야 할 필요성을 제기합니다.
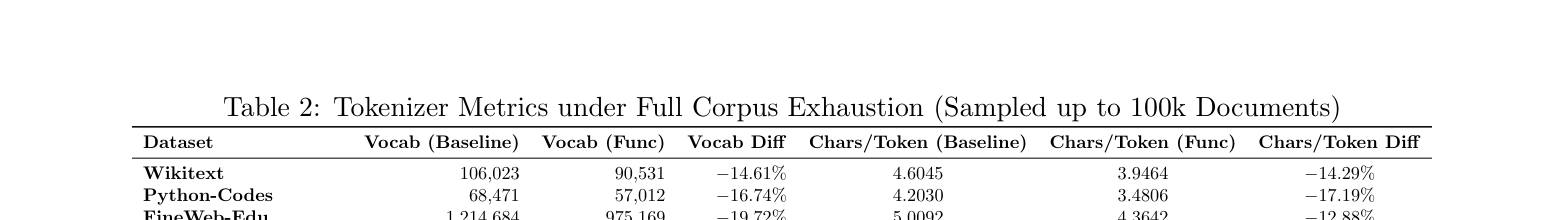
Table 2 — 어휘 절감 효과를 보여주는 핵심 정량 결과 테이블
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
Functionalizer는 orthographic 변이를 PUA 기반의 opcode 스트림으로 사전 분해함으로써, downsteam 모델이 canonical base에 대한 임베딩을 공유하도록 설계되었습니다. 이 프레임워크는 casing, diacritics, 그리고 character repetition을 표현하는 특화된 opcode를 사용하여 원본 텍스트를 완전히 복원할 수 있는 lossless 성능을 보장합니다. [Table 1]에 정의된 바와 같이, CAPITALIZE, DIACRITICS, REPEAT 등 4가지 범주의 연산자가 사용되며, 이는 tokenizer가 처리하는 vocabulary 크기를 크게 줄여줍니다. 실제 실험 결과, Unconstrained merge exhaustion 조건에서 기존 Baseline 대비 vocabulary slot 점유율을 최대 19.72%까지 감소시키는 성과를 거두었습니다. 특히 [Table 4]에서 확인할 수 있듯이, source code 도메인인 GitHub-Code-Python에서 Python syntax validity를 7.70%에서 9.12%로 향상시켰으며, FineWeb-Edu prose 데이터셋에서는 duplicate n-gram repetition을 66.0%에서 55.8%로 유의미하게 낮추었습니다.
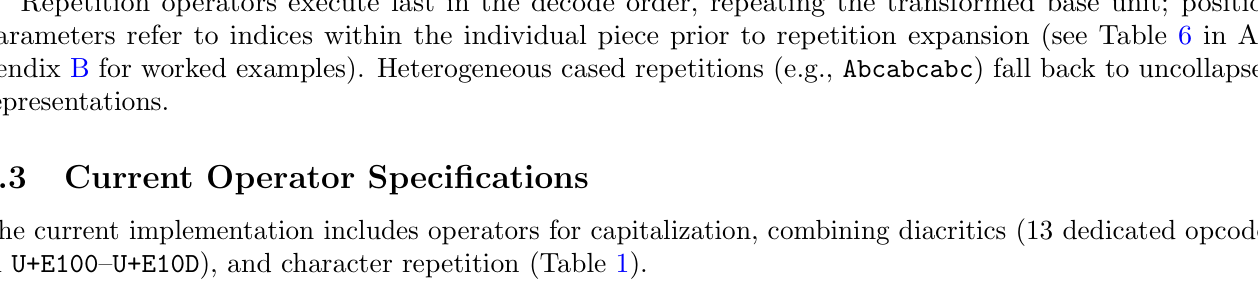
Table 1 — 제안하는 opcode 프레임워크의 연산자와 기능을 정의한 핵심 테이블
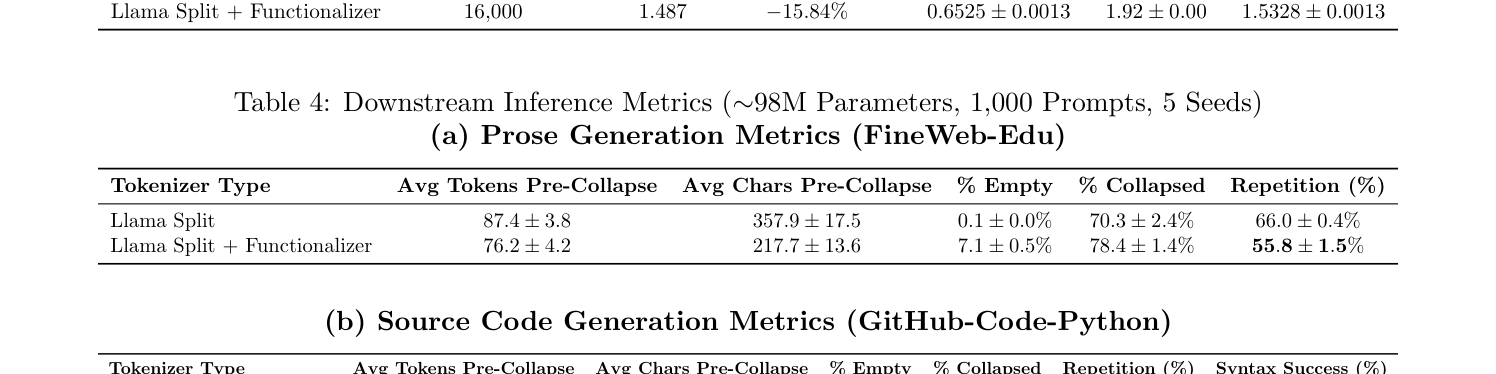
Table 4 — 생성 품질 및 문법 적합성 향상을 보여주는 downstream 평가 지표
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 lossy한 normalization 없이도 orthographic 및 structural 변이를 효과적으로 처리할 수 있는 lossless functional decomposition 프레임워크를 성공적으로 구축하였습니다. 제안된 방식은 vocabulary 효율성을 높이는 동시에 downstream 모델의 syntactic fidelity를 강화함으로써, language modeling의 성능을 비약적으로 개선할 수 있음을 입증했습니다. 이 연구는 고성능 LLM 학습 시 어휘 최적화와 sequence 효율성 간의 Pareto-optimal 지점을 제시하며, 향후 더 큰 규모의 production-scale 모델로의 확장 가능성을 열어두었다는 점에서 중요한 학술적·산업적 가치를 가집니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Complex KDA: Understanding and Enhancing the Expressivity of Kimi Delta Attention
- [논문리뷰] NCP-ArchPreview Technical Report: Moving towards Latent Space Language Models through Next Concept Prediction
- [논문리뷰] Massive Activations in Hybrid Linear Attention Large Language Models: Pre-Attention Spikes and Inter-Spike Plateaus
- [논문리뷰] Memory Decoder at Scale: A Pretrained, Parametric Long-Term Memory
- [논문리뷰] KletterMix: Climbing Toward High-Quality German Pretraining Data
Review 의 다른글
- 이전글 [논문리뷰] Streaming Video Editing with Easy Adaptation
- 현재글 : [논문리뷰] The Functionalizer: Lossless Functional Decomposition for Subword Tokenization
- 다음글 [논문리뷰] Think Like a World Model, Act Like a VLA: Distilling World-Model Representations into Compact Robot Policies
댓글