[논문리뷰] Think Like a World Model, Act Like a VLA: Distilling World-Model Representations into Compact Robot Policies
링크: 논문 PDF로 바로 열기
저자: Trung Dao, Sankalp Yamsani, Jaden Park, Joohyung Kim, Yong Jae Lee
1. Key Terms & Definitions
본 섹션에서는 논문의 핵심 용어와 그 정의를 설명한다.
- VLA (Vision-Language-Action) Models: Vision 및 Language Observation을 Robot Action으로 매핑하는 모델을 지칭하며, World Model과 달리 환경의 반응을 모델링하는 명시적인 Objective가 없어 Robustness가 주로 Data Coverage에 의존한다.
- World Models: 미래 환경의 변화(Future Frames, States, Actions)를 예측하도록 학습되어 Temporal Structure 및 Causal Consequence를 내재화하며, Physically Grounded Representation을 생성한다.
- Representation Alignment: Teacher Model의 Internal Features (Representations)를 Student Model이 학습하도록 하는 Distillation Technique의 일종으로, 주로 Cosine Loss를 활용한다.
- Knowledge Distillation: 더 크고 복잡한 Teacher Model의 Knowledge를 더 작고 효율적인 Student Model로 Transfer하는 과정으로, Teacher의 Output Distribution이나 Intermediate Features를 Student가 모방하도록 한다.
- Flow-matching action expert: Student VLA (QwenGR00T)의 구성 요소로, Backbone에서 얻은 Hidden States를 기반으로 Flow Path를 따라 Velocity Regression을 통해 미래 Action Chunks를 예측한다.
2. Motivation & Problem Statement
본 논문은 Vision-Language-Action (VLA) 모델이 지닌 Robustness 한계를 극복하고자 한다. VLA 모델은 광범위한 Semantic Understanding을 바탕으로 범용적인 로봇 제어에 유망하지만, 학습 데이터에 충분히 반영되지 않은 Viewpoint Shift, Lighting Changes, Clutter와 같은 환경적 Perturbation에 취약하다. 이는 VLA의 Standard Training이 세계가 Actions에 어떻게 반응하는지를 모델링하는 Explicit Pressure 없이 Observation을 Action에 직접 매핑하기 때문에, Temporally Grounded 또는 Causally Consistent Representation을 학습하지 못하는 구조적인 문제에서 기인한다. 결과적으로 VLA의 Robustness는 Data Coverage에 크게 의존하게 되며, 이는 Data 수집의 높은 비용과 궁극적인 한계로 이어진다.
반면, World Models는 미래 환경을 예측하도록 학습되어 Temporal Structure와 Causal Consequence를 Internalize함으로써 더욱 Physically Grounded Representation을 생성한다. 이러한 World Model 기반 정책들은 새로운 Task로의 Transfer 및 Perturbation 상황에서의 Graceful Degradation 측면에서 우수한 성능을 보인다. 그러나 World Model의 핵심 단점은 높은 Inference Cost이다. 예를 들어, DreamZero는 H100 GPU에서 추론당 3초가 소요되는 반면, VLA인 π0.5는 RTX 5090에서 65ms만에 실행된다. 이러한 높은 Inference Cost는 World Models를 Control Loop에 직접 적용하기 어렵게 만든다. 따라서 본 연구는 경량 VLA가 큰 World Model의 Grounded Representation을 Inference Cost 증가 없이 상속받을 수 있는지에 대한 질문에 답하고자 한다.
3. Method & Key Results
본 논문은 일반적인 VLA Training에 하나의 Term을 추가하여 Student의 Pooled Image-token Features를 Frozen World Model의 Features에 Align하는 방법론을 제안한다. 제안하는 방법론의 개요는 [Figure 2]에서 확인할 수 있다. 이 Representation Alignment Objective는 Teacher Model이 Frozen되어 있어 Target Features를 Training Frames에서 한 번만 추출하여 Cache할 수 있고, Student는 Target을 정확히 Reproduce하는 대신 Direction에서 Agree하도록 학습하여 Teacher와 Student가 Feature Space나 Dimensionality를 공유할 필요가 없다는 두 가지 Design Choice로 인해 효율적이다. Training 시 Teacher Model이 Memory에 로드되지 않으며, Alignment Head는 Training 종료 후 Discard되기 때문에 Deployed Policy는 Undistilled Baseline과 아키텍처적으로 동일하여 Zero Inference Cost를 달성한다. Student Model로는 QwenGR00T 정책이 사용되며, 이는 Qwen3-VL-family Vision-Language Backbone과 GR00T-style flow-matching action expert로 구성된다.
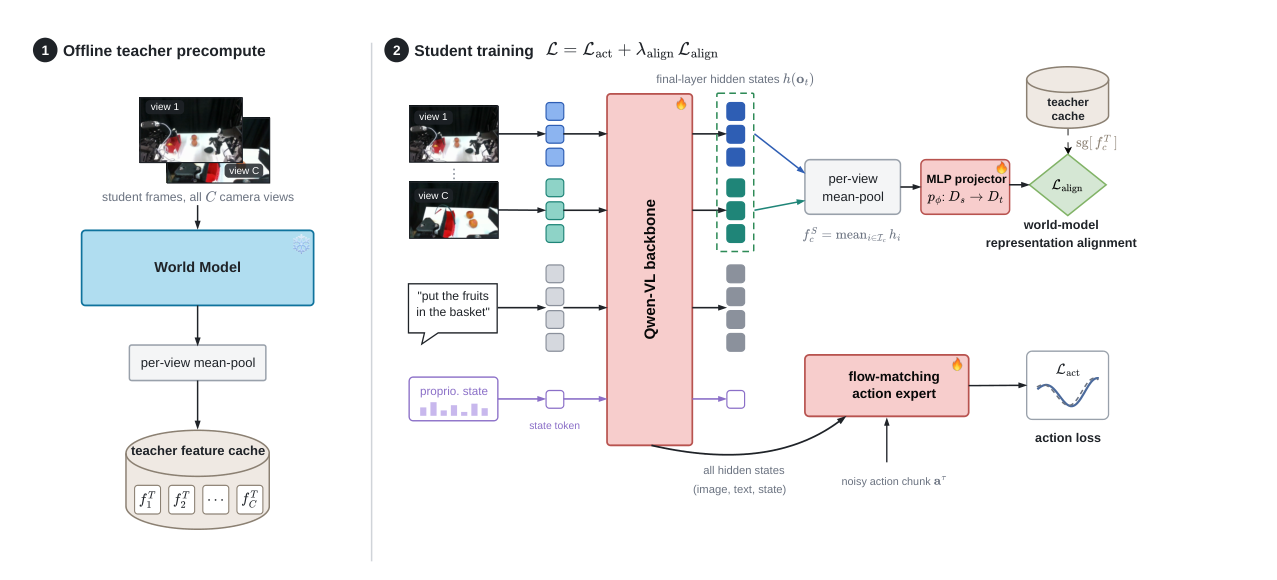
Figure 2 — 제안 방법론의 개요
제안 방법론의 핵심 정량적 결과는 다음과 같다.
- LIBERO Benchmark: 0.8B Student Model은 평균 성공률(SRavg) 97.9%를 달성하여, 동일한 Undistilled Student 대비 2.6%p의 상당한 성능 향상을 보였다. 이는 기존 4B 미만 VLA 정책들의 성능 범위인 78.7%에서 95.3%를 크게 상회하는 결과이다.
- RoboCasa-GR1 Benchmark: RoboCasa-GR1 humanoid manipulation Task에서 0.8B Student Model의 성공률은 48.2%에서 50.5%로 2.3%p 증가했다. 이는 4B QwenGR00T 모델의 54.8%에 4.3%p 이내로 근접하는 성능으로, 작은 모델이 훨씬 큰 모델에 버금가는 결과를 보여주었다.
- Real-Robot Manipulation: 실제 로봇 실험에서도 일관된 성능 향상이 관찰되었다. Single-arm Fruit Pick-and-Place Task에서 Distilled 0.8B Policy는 93.3%의 성공률을 기록하여 4B π-style policy와 동일한 성능을 달성했으며, Undistilled Control 대비 3 Trial 더 성공했다. Egg Task와 Bimanual Fruit Handover Task에서는 전반적인 성공률이 낮아지지만, Distilled Policy는 Undistilled Control 대비 Robustness와 Performance 측면에서 우위를 유지했다. 특히, 세 가지 실제 로봇 Task에서 Distilled 0.8B Student의 성공적인 Rollout은 [Figure 3]에 시각화되어 있다.
- Ablation Study: Student Scale, Backbone, Alignment Layer, Teacher Family의 변화에도 불구하고 Distillation 기법의 효과가 일관되게 나타나, 제안된 Recipe가 특정 네트워크 간의 Delicate Alignment보다는 Broad Representational Prior를 전이시킨 결과임을 입증했다.
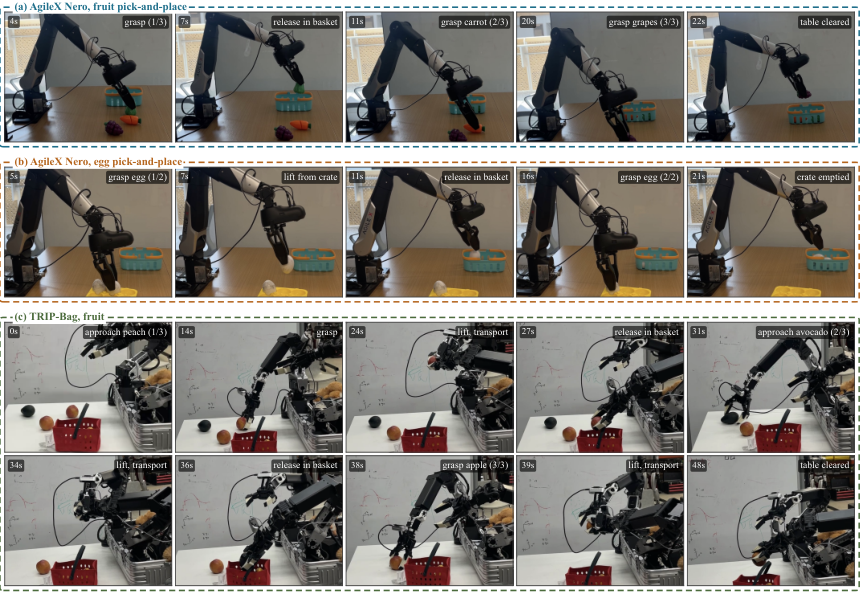
Figure 3 — 실제 로봇 작업 성공 Rollout
4. Conclusion & Impact
본 논문은 World Model의 Grounded Representation을 Inference Cost 없이 Compact Robot Policies로 Distill하는 효과적인 방법론을 성공적으로 제시한다. Frozen World Model의 Visual Features에 Student Policy를 Offline에서 단 한 번 Alignment함으로써, Deployed Policy는 Latency나 Memory Cost의 증가 없이 World Model의 가치 있는 Grounding을 상속받는다. 이러한 접근 방식은 World Model이 미래 예측을 통해 얻는 심층적인 이해를 실시간 로봇 제어 시스템에 통합하는 실용적인 해법을 제공한다.
본 연구의 영향은 학계 및 산업계 전반에 걸쳐 중요하다. 첫째, LIBERO 및 RoboCasa-GR1과 같은 시뮬레이션 환경뿐만 아니라 실제 로봇 실험에서도 일관되고 측정 가능한 성능 향상을 달성함으로써, 소형 VLA 모델의 Capabilities를 크게 확장할 수 있음을 입증했다. 둘째, 제안된 기법이 Student Scale, Backbone, Alignment Layer, Teacher 등 다양한 Design Choice에 대해 Robust하다는 Ablation Study 결과는 특정 아키텍처나 설정에 국한되지 않는 General Representational Prior가 전이되었음을 시사한다. 이는 미래 로봇 공학 연구 및 개발에서 더 효율적이고 범용적인 로봇 정책을 개발하는 데 중요한 기반이 될 것이다.
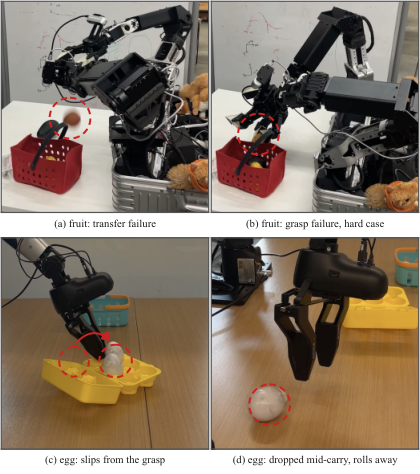
Figure 4 — 실제 로봇 작업 실패 모드
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Distilling Human-Aligned Privacy Sensitivity Assessment from Large Language Models
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] ZooWork-ShopRanker: An Open, Preference-Aligned E-Commerce Reranker
- [논문리뷰] VLA-Precision: Asymmetric Co-Bootstrapping for Efficient Real-World Online RL of Vision-Language-Action Models
- [논문리뷰] TrackEverything: Long Horizon Dense Tracking via De-Duplicating 3D Scene Representations
Review 의 다른글
- 이전글 [논문리뷰] The Functionalizer: Lossless Functional Decomposition for Subword Tokenization
- 현재글 : [논문리뷰] Think Like a World Model, Act Like a VLA: Distilling World-Model Representations into Compact Robot Policies
- 다음글 [논문리뷰] Transferring the Intelligence of VLMs to Robotic Control
댓글