[논문리뷰] Transferring the Intelligence of VLMs to Robotic Control
링크: 논문 PDF로 바로 열기
저자: Meng-Hao Guo, Zhe-Han Mo, Jia-Jun Wang, Yi Zhang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- VLMs (Vision-Language Models): Digital 세계의 방대한 데이터로 훈련되어 이미지 및 텍스트를 이해하고 추론하는 능력을 갖춘 모델입니다.
- Intelligence Transfer: Embodiment, Environment, Task의 차이에도 불구하고, 인지, 지식, 학습, 추론, 의사결정 등 일반적인 능력을 재사용하여 새로운 문제에 적용하는 능력입니다.
- Semantic Action Interface: 로봇 제어를 위해 Translation, Rotation, Gripper 등 간결하고 의미론적인 이산적(discrete) 모션 프리미티브로 구성된 인간 친화적인(human-intuitive) 인터페이스입니다.
- In-Context Learning (ICL): 모델의 파라미터를 업데이트하지 않고, 소수의 데모를 통해 인터페이스 사용법 및 태스크 해결 전략을 학습시키는 방식입니다.
- GIP (Gripper Interaction Point): 그리퍼의 두 손가락 사이 중간 지점을 의미하며, 로봇이 객체와 실제로 상호작용하는 지점을 일관되게 나타냅니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 VLM(Vision-Language Model)의 지능을 로봇 제어로 전이할 때 발생하는 핵심 문제를 해결하고자 합니다. 기존의 VLM 기반 로봇 제어 접근 방식들은 일반적으로 로봇 데이터에 대한 명시적인 훈련을 요구하는데, 이는 데이터 수집 비용이 높고, 특정 로봇 embodiment에 한정되며, VLM의 일반적인 추론 능력을 저하시킬 수 있는 한계점을 가집니다. Vision-Language-Action (VLA) 및 World-Action Models (WAMs)와 같은 모델들은 시각 및 언어적 관측으로부터 로봇 액션으로의 매핑을 학습하기 위해 대규모의 쌍을 이루는 데이터를 필요로 하지만, 이러한 데이터는 수집 비용이 높고 embodiment에 특화되어 있습니다. 더욱이, 로봇 액션 예측을 위한 VLM 훈련은 명령 추종(instruction following) 및 추론(reasoning)과 같은 일반 목적 능력의 저하를 야기할 수 있습니다. 따라서, 본 연구는 대규모 로봇 훈련 데이터 없이도 경량 인터페이스와 소수의 In-Context Learning 데모를 통해 VLM의 지능을 물리적 로봇 제어로 효과적으로 전이할 수 있는지 탐구합니다. 이러한 접근 방식은 로봇 데이터 부족 문제를 완화하고, 사전 훈련된 VLM의 광범위한 일반화 능력을 훼손하지 않으면서 로봇 제어에 활용하는 새로운 패러다임을 제시합니다 [Figure 1].
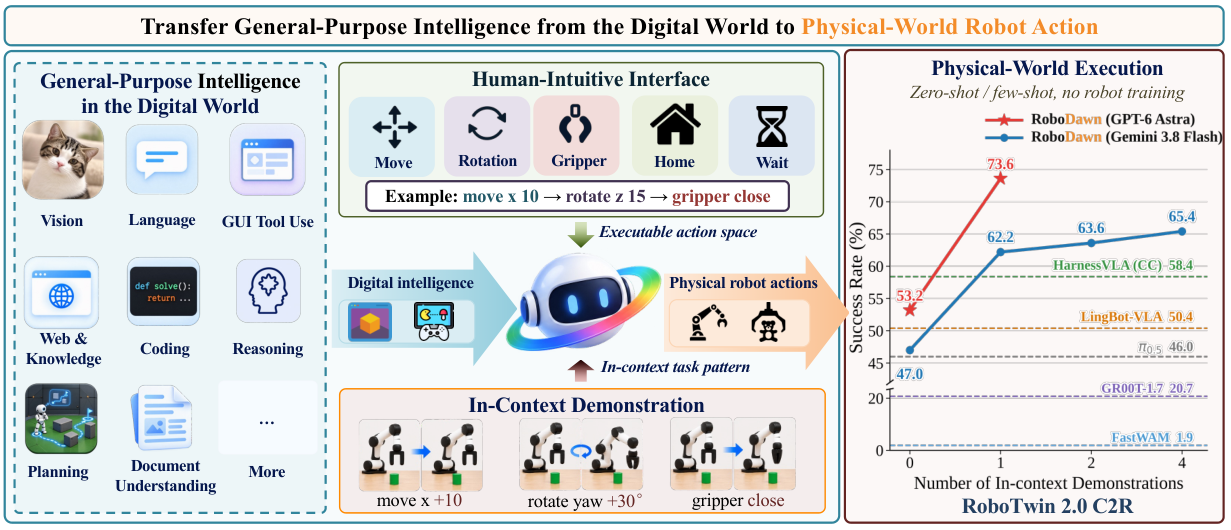
Figure 1 — RoboDawn 개념 설명
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 사전 훈련된 VLM의 일반 지능을 로봇 제어로 전이하기 위한 프레임워크인 RoboDawn을 제안합니다. RoboDawn은 (a) 인간 친화적인(human-intuitive) Semantic Action Interface와 (b) In-Context Learning (ICL) 디자인을 핵심 구성 요소로 하여, 태스크별 로봇 훈련 없이 VLM이 닫힌 루프(closed-loop) 방식으로 로봇을 제어할 수 있도록 합니다 [Figure 2]. Semantic Action Interface는 GIP(Gripper Interaction Point)를 기준으로 move, rotate, point, gripper, home, wait, done과 같은 이산적 모션 프리미티브를 제공하여, VLM이 저수준(low-level) 연속 제어 대신 의미론적으로 해석 가능한 액션을 통해 로봇과 상호작용하게 합니다. ICL 스킴은 Dprim(command primer)과 Dtask(task-level demonstrations)로 구성되며, VLM이 개별 명령의 의미와 환경 변화를 이해하고 태스크 해결 전략을 학습하는 데 도움을 줍니다.
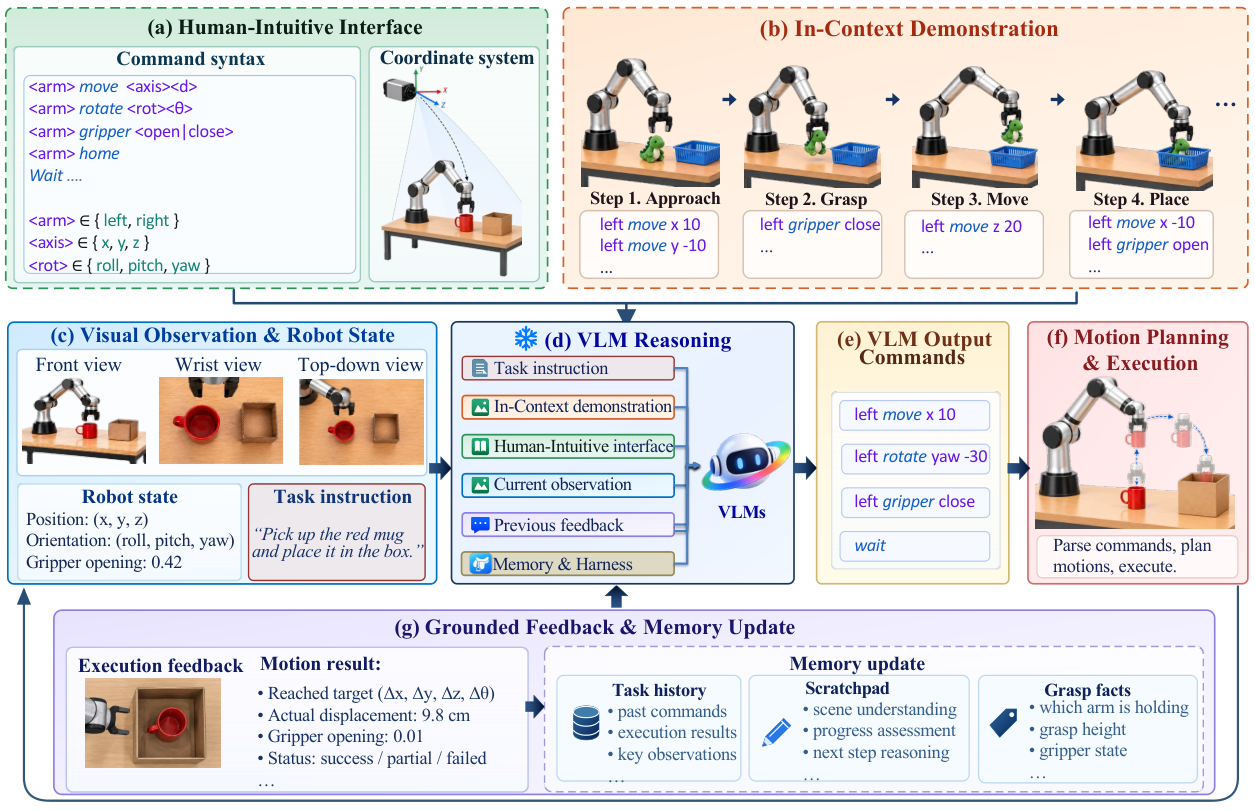
Figure 2 — RoboDawn 전체 프레임워크
실험 결과, RoboDawn은 다양한 벤치마크에서 뛰어난 성능을 보였습니다. RoboTwin 2.0 C2R 벤치마크에서, GPT-6 Astra 기반의 RoboDawn은 Zero-shot 설정에서 53.2%의 성공률을 달성하여, 기존의 로봇 훈련 정책인 π0.5 (46.0%) 및 LingBot-VLA (50.4%)를 능가했습니다. 더욱이, 단 하나의 In-context demonstration을 제공했을 때 성공률은 73.6%로 크게 향상되어, SOTA agentic VLA 방식인 HarnessVLA (Claude Code)의 58.4%를 15.2%p 초과했습니다. RoboDojo 벤치마크에서도 RoboDawn은 Zero-shot 시 35.67%의 성공률을 기록했으며, One-shot에서는 47.17%로 향상되어, 기존의 DM0.5 (19.34%)보다 월등한 성능을 보였습니다. 특히, RoboDawn은 명령 예산(command budget)이 증가함에 따라 성공률이 일관되게 향상되는 Test-time scaling 특성을 보여, 실패 복구(failure-recovery) 능력과 메모리 메커니즘을 통해 적응력을 입증했습니다 [Figure 3]. 또한, 실제 Franka 로봇을 사용한 Block-in-Basket 태스크에서 90%의 성공률, Block Stacking 태스크에서 50%의 성공률을 Zero-shot 설정으로 달성하여, 시뮬레이션 환경 외 실제 로봇으로의 Intelligence Transfer 가능성을 성공적으로 입증했습니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 RoboDawn이라는 프레임워크를 통해 사전 훈련된 VLM의 지능을 로봇 제어로 효과적으로 전이시키는 방법을 성공적으로 제시했습니다. 이 연구는 로봇 제어를 위한 지능 획득의 핵심이 대규모 로봇 데이터 셋 구축 및 특정 액션 모델 훈련에만 있는 것이 아니라, 적절한 인터페이스 설계와 In-Context Learning을 통해 기존 파운데이션 모델의 내재된 능력을 활용하는 새로운 방향을 제시합니다. RoboDawn은 태스크별 로봇 훈련 없이도 강력한 Zero-shot 성능과 단일 데모만으로 상당한 성능 향상을 달성함으로써, 로봇 공학 분야에서 비용 효율적이고 일반화 가능한 embodied intelligence 구현의 잠재력을 시사합니다. 이러한 접근 방식은 VLM이 고수준 의사결정 엔진으로서 로봇 제어에서 더 큰 역할을 수행할 수 있음을 보여주며, 향후 로봇 시스템의 개발 방향에 중요한 영향을 미칠 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Vote-in-Context: Turning VLMs into Zero-Shot Rank Fusers
- [논문리뷰] Adapting Vision-Language Models Without Labels: A Comprehensive Survey
- [논문리뷰] In-Context Robot Learning with VLM Agents
- [논문리뷰] ActionPiece: Rethinking Action Tokenization for Autoregressive Vision-Language-Action Models
- [논문리뷰] Show-Harness: Just a VLM Agent Can Play Robots
Review 의 다른글
- 이전글 [논문리뷰] Think Like a World Model, Act Like a VLA: Distilling World-Model Representations into Compact Robot Policies
- 현재글 : [논문리뷰] Transferring the Intelligence of VLMs to Robotic Control
- 다음글 [논문리뷰] UltraTex: Unleashing 2K Multi-View Diffusion for 3D Texturing
댓글