[논문리뷰] DeltaWAM: Delta World Action Models for Bimanual Manipulation
링크: 논문 PDF로 바로 열기
메타데이터
저자: Han Yan, Zishang Xiang, Haokai Jiang, Zeyu Zhang, Qilin Wang, Weiyu Guo, Yandong Guo, Boxin Shi, Hao Tang
1. Key Terms & Definitions (핵심 용어 및 정의)
- WAM (World-Action Model): 로봇 제어를 위해 시각적 역학(Visual Dynamics)과 제어 액션(Action)을 공동으로 모델링하는 프레임워크입니다.
- Visual Deltas: 연속된 프레임 간의 시각적 변화만을 압축하여 표현하는 토큰으로, 정적인 배경 정보를 제외하고 동작과 관련된 핵심 정보에 집중합니다.
- SDM (Streaming Delta Memory): dense한 전체 observation 대신, 기준이 되는 Anchor와 연속적인 Visual Delta를 기반으로 정보를 점진적으로 캐싱하고 업데이트하는 기법입니다.
- Flow Matching: 데이터 분포를 생성하기 위한 생성 모델링 기법으로, 논문에서는 Visual Delta와 Action Chunk 생성을 위해 사용됩니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 WAM이 매 관측 단계마다 고차원 비디오를 생성하거나 dense한 비디오 표현을 반복적으로 처리함으로써 발생하는 계산 비효율성과 비효율적 추론 문제를 해결하고자 합니다. 기존 연구인 Fast-WAM은 미래 비디오 생성 문제를 학습 목표로 전환하여 추론 효율을 개선했으나, 여전히 매 제어 주기마다 전체 observation을 무거운 Video DiT에 입력해야 하는 병목 현상을 겪습니다. 이러한 방식은 조명이나 배경과 같은 부차적인 시각적 변수(Nuisance appearance variations)까지 모델링하게 하여 모델의 강건성을 저해할 수 있습니다. 따라서 저자들은 정적인 배경과 변화하는 동작을 분리하고, compact한 변화량만을 이용하여 효율적인 추론이 가능한 새로운 모델링 방식이 필요하다고 지적합니다. [Figure 1]
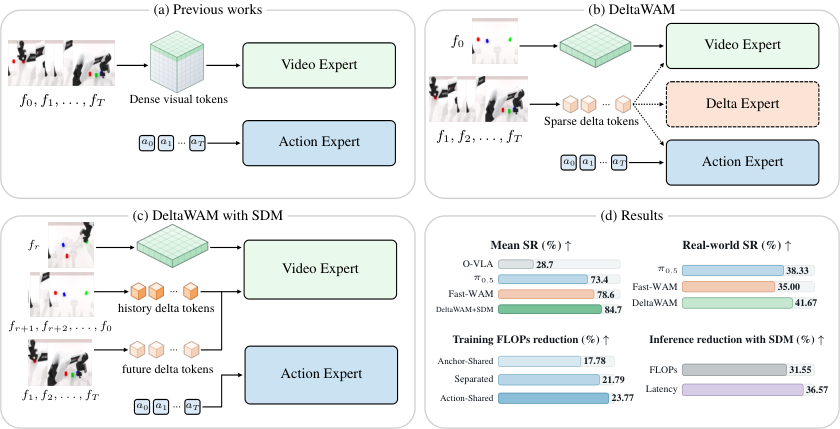
Figure 1 — DeltaWAM의 핵심 개념
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 dense한 Anchor stream, 희소한 Delta stream, 그리고 Action stream으로 구성된 DeltaWAM을 제안하며, 특히 Streaming Delta Memory (SDM)를 통해 추론 시 완전한 observation 처리 빈도를 획기적으로 줄였습니다. DeltaWAM은 사전 학습된 비디오 생성 모델을 기반으로 하며, 세 가지 아키텍처(Anchor-Shared, Separated, Action-Shared)를 통해 시각적 전환과 액션 학습 간의 효율적인 상호작용을 구현합니다. [Figure 2] SDM은 기준 Anchor의 context를 캐싱하고 새로운 Visual Delta를 점진적으로 업데이트함으로써 제어 성능을 유지하면서도 연산 비용을 절감합니다. [Figure 3]
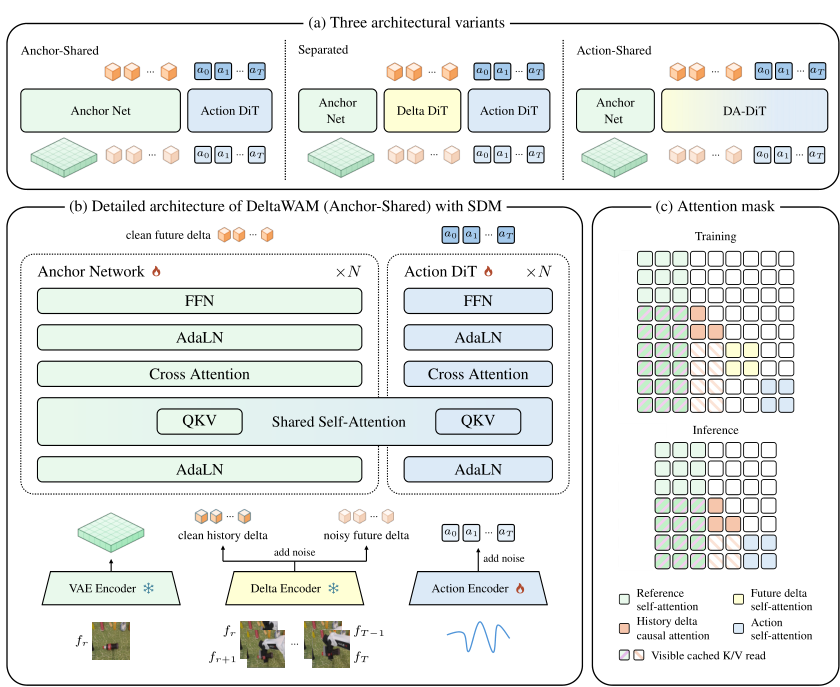
Figure 2 — DeltaWAM 모델 아키텍처
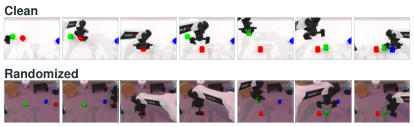
Figure 3 — SDM의 메모리 업데이트 방식
실험 결과, DeltaWAM과 SDM을 결합한 모델은 RoboTwin 벤치마크에서 기존 Fast-WAM 대비 평균 성공률을 clean 환경에서는 81.3%에서 85.4%로, visual randomization 환경에서는 75.8%에서 83.9%로 향상시켰습니다. 연산 효율성 측면에서, 제안된 3가지 아키텍처는 학습 FLOPs를 17.78%에서 23.77%까지 감소시켰으며, SDM을 활용할 경우 추론 레이턴시와 FLOPs를 각각 36.57%, 31.55% 낮추는 성과를 거두었습니다. [Table II]
4. Conclusion & Impact (결론 및 시사점)
본 논문은 DeltaWAM과 SDM을 통해 시각적 역학 모델링에서 dense한 정보 대신 희소한 변화량을 활용하는 새로운 패러다임을 제시합니다. 이러한 접근 방식은 로봇 조작 작업에서 계산 비용을 획기적으로 줄이면서도 복잡한 환경에서의 성공률과 강건성을 동시에 확보할 수 있음을 입증하였습니다. 해당 연구는 향후 컴퓨팅 자원이 제한적인 로봇 제어 시스템에서 효율적인 고성능 정책을 배포하기 위한 핵심 기술로 기여할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Modality-Autoregressive World-Action Models
- [논문리뷰] SimWAM: A Simple World Action Model for End-to-End Autonomous Driving
- [논문리뷰] GigaWorld-Policy-0.5: A Faster and Stronger WAM Empowered by AutoResearch
- [논문리뷰] Flash-WAM: Modality-Aware Distillation for World Action Models
- [논문리뷰] SimVLA: A Simple VLA Baseline for Robotic Manipulation
Review 의 다른글
- 이전글 [논문리뷰] Coding Agents for Generalized Task and Motion Planning Problems
- 현재글 : [논문리뷰] DeltaWAM: Delta World Action Models for Bimanual Manipulation
- 다음글 [논문리뷰] ExplorationBench: Measuring AI Systems' Exploration in Verifiable Alien Worlds
댓글