[논문리뷰] Fewer Tokens, More Self-Teaching: On-Policy Self-Distillation for Extreme Visual Token Reduction
링크: 논문 PDF로 바로 열기
메타데이터
저자: Junxian Li, Ruixuan Yang, Tianao Zhang, Tiange Xu, Weisheng Dong, Yulun Zhang
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- LT-OPD: Low-Token On-Policy Distillation의 약자로, 극한의 visual token 압축 환경에서 모델 성능을 복구하기 위해 제안된 온-폴리시 자기 증류 프레임워크입니다.
- On-Policy Self-Distillation: 고정된 학습 데이터가 아닌, 압축된 student 모델이 생성한 실제 추론 시의 trajectory를 바탕으로 Frozen 된 full-token teacher 모델의 지식을 증류하는 기법입니다.
- Budget-level Curriculum: 학습 초기에는 비교적 많은 visual token을 사용하다가 점진적으로 목표 budget까지 줄여나감으로써 압축된 모델의 학습 안정성을 높이는 전략입니다.
- Visual Token Reduction: 모델의 추론 속도 향상과 자원 효율성을 위해 visual encoder에서 생성된 token 수를 임계치 이하로 줄이는 최적화 방식입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 극한의 visual token 압축(예: 5% 보존) 상황에서 발생하는 예측 분포 불일치 문제를 해결하고자 합니다. 기존의 visual token reduction 기법들은 training-free 방식이나 고정된 prefix를 사용한 학습에 의존하여, 모델이 실제 추론 환경에서 마주하게 되는 생성 상태를 충분히 반영하지 못하는 한계가 있습니다. 이러한 불일치는 압축된 모델이 낮은 token budget 하에서 성능이 급격히 저하되는 원인이 됩니다. [Figure 1]에서 볼 수 있듯이, 기존 방식들은 극한의 budget 환경에서 성능 개선에 한계가 뚜렷하며, 이를 극복하기 위해 모델의 실제 생성 trajectory에 직접 적응하는 새로운 학습 프레임워크가 필요합니다.
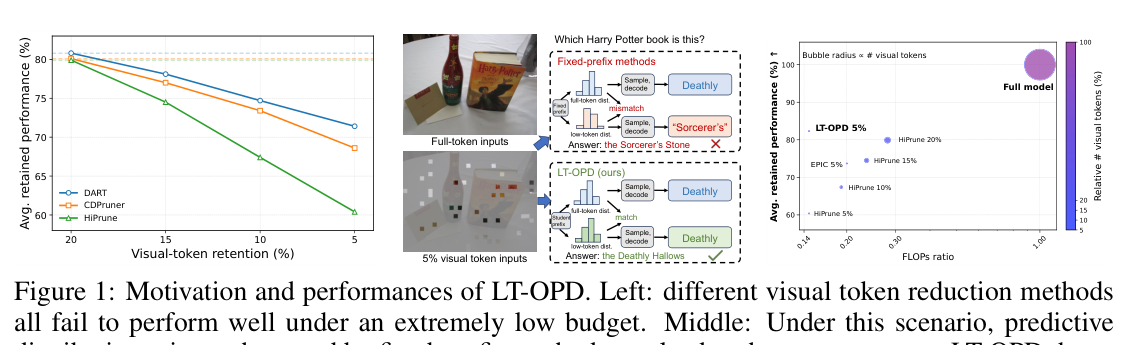
Figure 1 — 다양한 visual token reduction 방법론들의 극한 budget 환경에서의 성능 한계와 LT-OPD의 효율성을 보여주는 핵심 비교 그래프
## 3. Method & Key Results (제안 방법론 및 핵심 결과) LT-OPD는 student 모델이 생성한 응답에 대해 full-token teacher가 distributional supervision을 제공하는 on-policy self-distillation 구조를 도입하여 모델 성능을 극적으로 복구합니다. 학습 과정에서 student 모델은 스스로 trajectory를 생성하고, Frozen 된 teacher 모델은 student가 생성한 prefix를 기반으로 정보를 풍부하게 제공함으로써 JSD(Jensen-Shannon Divergence) loss를 최소화합니다. [Figure 2]는 이 프레임워크의 상세 구조를 보여줍니다. 또한, 학습 난이도를 조절하는 budget-level curriculum을 통해 초기 학습의 불안정성을 완화하였습니다. 실험 결과, Qwen3.5-4B 모델 기준 5% visual token 보존 조건에서 average retain ratio를 68.6%에서 82.3%로 대폭 향상시켰습니다. 이는 [Table 2]에 명시된 바와 같이, 학습 기반 및 강화학습 기반의 타 방법론 대비 압도적인 성능 우위를 점함을 의미합니다. 또한, KV-cache 사용량을 85.2%, prefill FLOPs를 85.4% 절감하면서도 추론 효율성을 유지하는 결과를 보여주었습니다.
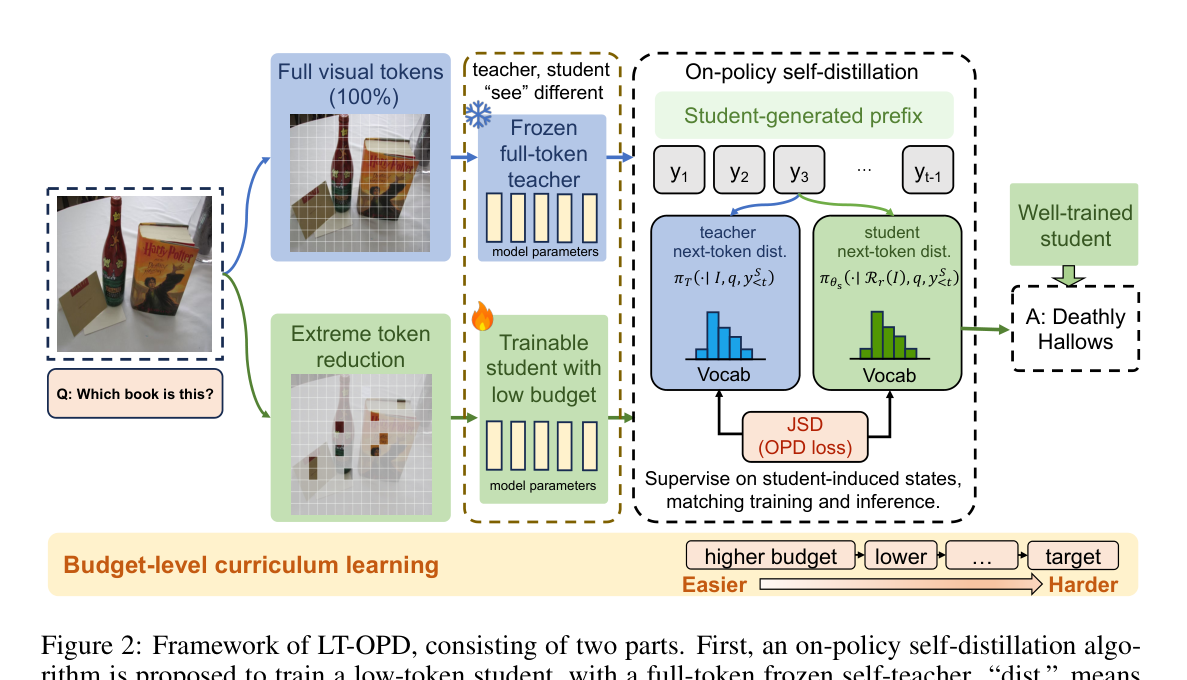
Figure 2 — 본 논문에서 제안하는 온-폴리시 자기 증류 및 커리큘럼 학습 구조를 설명하는 핵심 다이어그램
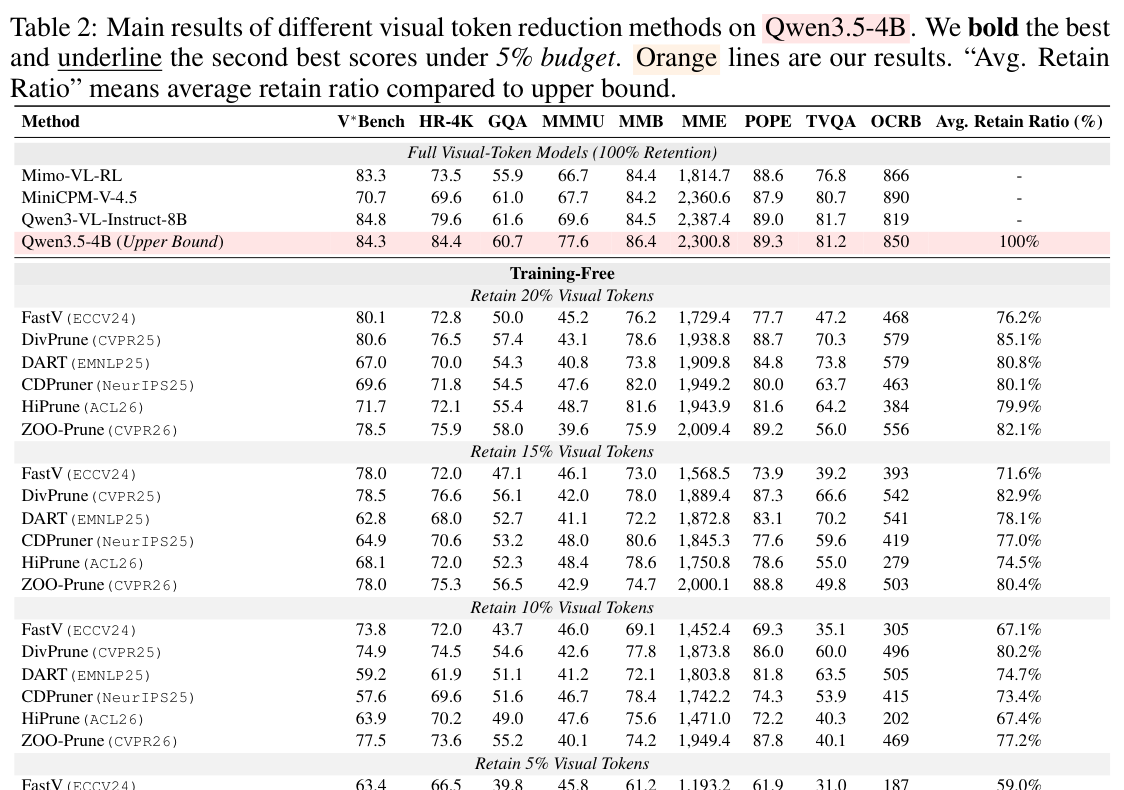
Table 2 — 제안하는 LT-OPD와 기존 baselines 간의 벤치마크 성능 비교 결과를 담은 핵심 데이터 테이블
## 4. Conclusion & Impact (결론 및 시사점) 본 연구는 극한의 visual token 압축 환경에서 모델의 적응 과정이 성능 복구의 핵심임을 입증하였습니다. LT-OPD 프레임워크를 통해 MLLM은 추론 시 마주하는 생성 상태에 최적화될 수 있으며, 이는 다양한 모델 스케일 및 구조에서도 일관된 성능 향상을 보입니다. 본 연구는 효율적인 MLLM 배포를 위해 token 선택 기법과 학습 방식이 통합적으로 고려되어야 함을 강조하며, 자원이 제한된 환경에서 고성능 멀티모달 모델을 운용할 수 있는 실무적 가이드라인을 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] ZGCM-1: A Fully Open and Extremely Efficient Foundation Model for Math and Agentic Search
- [논문리뷰] OPD-V: Visual On-Policy Self-Distillation with Modality Balance
- [논문리뷰] ViQ: Text-Aligned Visual Quantized Representations at Any Resolution
- [논문리뷰] Eliciting Complex Spatial Reasoning in MLLMs through Wide-Baseline Matching
- [논문리뷰] TRON: Targeted Rule-Verifiable Online Environments for Visual Reasoning RL
Review 의 다른글
- 이전글 [논문리뷰] EmbodiedMemory-Bench: Benchmarking Embodied Memory for Long-Horizon Embodied Tasks
- 현재글 : [논문리뷰] Fewer Tokens, More Self-Teaching: On-Policy Self-Distillation for Extreme Visual Token Reduction
- 다음글 [논문리뷰] FlowTool: Controlling Tool Parameter in Image Retouching via Flow Matching
댓글