[논문리뷰] How Far Are We from Removing the Visual Encoder? Scaling Laws for Encoder-Free Multimodal Pretraining
링크: 논문 PDF로 바로 열기
메타데이터
저자: Lin Chen, Bolin Ni, Qi Yang, Lan Jiang, Kun Ding, Xiaoran Fan, Hower Yang, Ying Wang, Shiming Xiang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Encoder-Free MLLM: 별도의 Visual Encoder(예: ViT) 없이, 이미지 패치를 직접 디코더에 투영하여 픽셀 수준에서 시각적 정보를 학습하는 모델 아키텍처입니다.
- IsoFLOP Profile: 고정된 전체 학습 예산(FLOPs) 하에서 모델 파라미터 크기($M$)와 토큰 수($D$)의 조합을 변화시키며 손실(Loss)을 측정하여 컴퓨팅 최적 지점을 찾는 분석 기법입니다.
- Compute-Optimal Allocation: 주어진 학습 예산 $C$에서 손실을 최소화하는 최적의 모델 크기와 토큰 수의 배분 비율을 지칭합니다.
- MaxVio: Sparse MoE(Mixture-of-Experts) 모델에서 특정 전문가(Expert)의 부하가 평균 대비 얼마나 치우쳐 있는지를 나타내는 부하 불균형 지표입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Visual Encoder 유무에 따른 MLLM의 스케일링 거동 차이를 체계적으로 규명하고, Encoder-Free 아키텍처가 거대 모델 스케일에서 실질적인 대안이 될 수 있는지 분석합니다 [Figure 2]. 기존 연구들은 Encoder-Free 모델의 타당성을 입증해 왔으나, 이들이 Encoder-Based 모델과 비교했을 때 컴퓨팅 자원을 얼마나 효율적으로 사용하는지에 대한 정량적 Scaling Laws 연구가 부족했습니다. 저자들은 두 아키텍처 간의 효율성 격차가 모델 스케일 증가에 따라 어떻게 변화하는지를 밝히고자 합니다. 이를 위해 동일한 디코더 Ladder, 데이터 혼합, 최적화 설정을 갖춘 통제된 환경에서 비교를 수행합니다 [Figure 1].
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 두 아키텍처를 비교하기 위해 대규모 IsoFLOP 분석을 수행하고, 모델 내부의 시각 정보 처리 메커니즘을 탐색하는 프로빙(Probing) 기법을 제안합니다. 실험 결과, Encoder-Free 모델은 텍스트 목표에 대해서는 Encoder-Based 모델과 거의 동일한 Loss-Compute Frontier를 보였습니다. 그러나 멀티모달 목표에서는 소규모 스케일에서 성능 격차가 존재하며, Compute-Optimal Allocation을 적용했을 때 Encoder-Free 모델이 더 큰 디코더 용량을 선호하는 경향(Allocation exponent $a$가 0.464에서 0.570으로 증가)을 확인했습니다 [Table 1, Figure 3]. 결과적으로, Encoder-Free 모델은 약 $10^{22}$ FLOPs의 스케일에서 성능 교차점(Crossover)에 도달할 것으로 예측되며, 이는 최신 플래그십 모델의 학습 예산($10^{25}$ FLOPs) 대비 충분히 도달 가능한 수준입니다 [Figure 4]. 또한, 디코더는 시각 정보 처리를 위해 Bidirectional Attention, 얕은 레이어에서의 시각적 변환, 그리고 특정 전문가에게 집중된 Expert Routing 등 고유의 적응 기법을 발달시키는 것으로 나타났습니다 [Figure 7, Figure 10].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Visual Encoder를 제거하더라도 적절한 모델 스케일 확장을 통해 기존 아키텍처를 따라잡을 수 있음을 이론적·경험적으로 증명했습니다. Encoder-Free 아키텍처는 모델을 단순화하고 통합적인 학습 프레임워크를 제공한다는 점에서 멀티모달 모델 설계의 유망한 방향성을 제시합니다. 특히 특정 작업군(STEM 등)에서는 이미 빠른 효율성 개선을 보이고 있어, 향후 멀티모달 파운데이션 모델의 효율적 설계와 배포에 중요한 가이드라인이 될 것으로 기대됩니다.
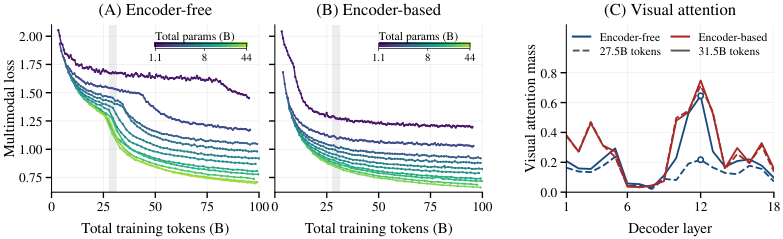
Figure 7 — 학습 과정 중 시각적 인코딩 변화
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Beyond Language Modeling: An Exploration of Multimodal Pretraining
- [논문리뷰] SMELT: Scaling Laws for Compute-Matched MoE Looped Transformers
- [논문리뷰] LAION-BVD: A 10-Million-Hour Open Video Dataset for Multimodal Pre-training
- [논문리뷰] Let's Scale Step by Step: Compute-Efficient Hyperparameter Transfer for Large-Scale Mixture-of-Experts
- [논문리뷰] Abra: Scaling Diffusion Image Training
Review 의 다른글
- 이전글 [논문리뷰] Hard Vision, Easy Vision: What GPT-6 Astra Reveals Across Computer Vision
- 현재글 : [논문리뷰] How Far Are We from Removing the Visual Encoder? Scaling Laws for Encoder-Free Multimodal Pretraining
- 다음글 [논문리뷰] Imprint Reader: From Weight-Update Readout to Behavioral Intervention
댓글