[논문리뷰] Imprint Reader: From Weight-Update Readout to Behavioral Intervention
링크: 논문 PDF로 바로 열기
저자: Guanxu Chen, Qihao Lin, Jing Shao
키워: Weight Update Readout, Behavioral Intervention, Language Models, Self-Improvement, Meta-Learning, Parameter Pruning, Vibe Alignment
1. Key Terms & Definitions
- Imprint Reader: Frozen weight updates를 자연어 설명으로 디코딩하도록 Semantic Mount-and-Read Tuning (SMART)을 통해 훈련된 모델.
- Semantic Mount-and-Read Tuning (SMART): Imprint Reader를 훈련하는 에피소드 기반 절차로, knowledge-bearing weight update를 Reader에 temporary mount하고 anchor-free meta-query를 통해 natural-language description을 eliciting하는 방식.
- Anchor-free Meta-query: 학습 target과 독립적으로 샘플링되며, target learning content에 대한 item-specific cue를 제공하지 않는 meta-query.
- Delta Weight (Δθk): 특정 학습 target
k를 주입하기 위해 original modelθ0를 temporary modelθk(T)로 fine-tuning하여 얻는 parameter 변화량 (θk(T) – θ0). - MetaEdit: Imprint Reader의 coordinate-aligned gradients를 original model에 transfer하여 특정 target behavior를 유도하는 intervention operator.
2. Motivation & Problem Statement
본 논문은 현재 Large Language Models (LLMs)이 자신들의 학습 과정을 인간처럼 성찰하거나, parameter level에 남아있는 learning trace를 직접적으로 해석할 수 없다는 문제점을 제기합니다. 기존 weight-space method들은 모델의 accuracy나 fine-tuning task 같은 coarse attributes만 예측할 수 있었고, weight difference를 verbalize하는 시도 또한 특정 도메인에 국한되거나 신뢰성이 부족했습니다. 이러한 한계로 인해 모델이 학습한 내용을 명시적으로 파악하고 이를 기반으로 self-improvement cycle을 닫는 것이 어려웠습니다. 즉, 모델이 weight update 내에 인코딩된 factual knowledge나 behavioral change를 직접 decoding하여 설명할 수 있는 능력이 부재했습니다.
3. Method & Key Results
저자들은 frozen weight update를 natural-language description으로 디코딩하는 Imprint Reader를 제안합니다. 이 Reader는 Semantic Mount-and-Read Tuning (SMART)이라는 에피소드 기반 절차를 통해 훈련됩니다 [Figure 1]. SMART는 knowledge-bearing weight update (Δθk)를 임시적으로 Reader에 mount하고, anchor-free meta-query를 사용하여 해당 update와 관련된 factual knowledge나 behavioral change를 자연어로 설명하도록 학습시킵니다. 이 과정에서 no-change 및 random-perturbation control episode를 통해 모델이 unsupported claim을 자제하도록 유도합니다.
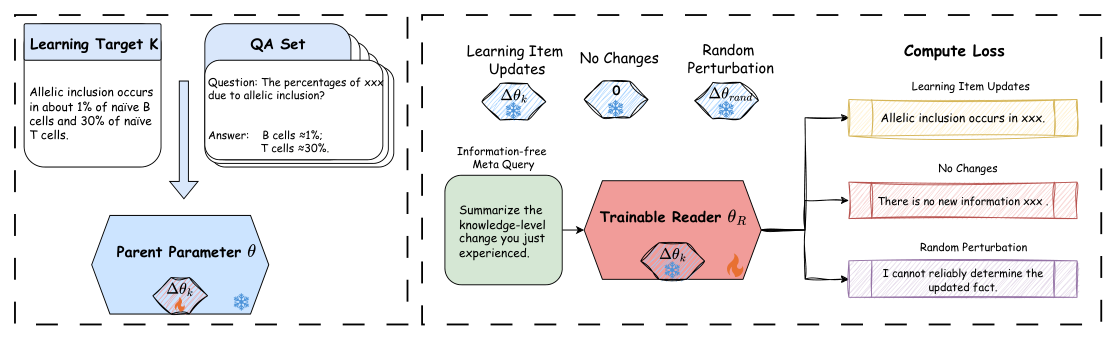
Figure 1 — 본 논문의 핵심 방법론인 SMART의 전체적인 프레임워크와 동작 방식을 시각적으로 설명하는 다이어그램
Imprint Reader의 주요 결과는 다음과 같습니다.
- Readout Performance: Held-out update에 대해 judge-based Pass@100 기준, knowledge readout에서는 2%, behavior readout에서는 16%의 성능을 달성했습니다 [Figure 2b]. 이는 자연어 readout의 가능성을 시사하지만, update 간 reliability는 개선이 필요함을 보여줍니다.
- Behavioral Intervention via MetaEdit: Reader는 특정 target behavior와 candidate weight update 사이의 gap에 대한 differentiable proxy를 제공하며, 그 coordinate-aligned gradients는 original model Qwen3-14B에 대한 MetaEdit intervention을 가능하게 합니다.
- Safety Pruning: 0.5% pruning rate에서 MetaEdit (Reader)는 harmful-prompt refusal rate를 57.9%에서 64.1%로 증가시켜 safety maintenance target을 달성했습니다. refusal-relaxation target의 경우 55.4%로 감소시켰습니다 [Figure 5]. 이는 대부분의 baseline들이 두 target을 구분하지 못하거나 유사한 방향으로 움직인 것과 대조적입니다.
- Vibe Alignment: Target task training data 없이 behavior description만을 사용하여, MetaEdit는 수학적 추론 (GSM8K, MATH-500) 및 agentic tool-use (BFCL) task에서 성능을 향상시켰습니다. GSM8K accuracy는 94.77%에서 95.00%로, MATH-500 accuracy는 82.8%에서 83.0%로 상승했습니다 [Table 1]. BFCL Overall score는 41.69%에서 44.60%로 증가했으며, backtracking 및 sub-goal expression의 빈도도 높아졌습니다 [Table 2].
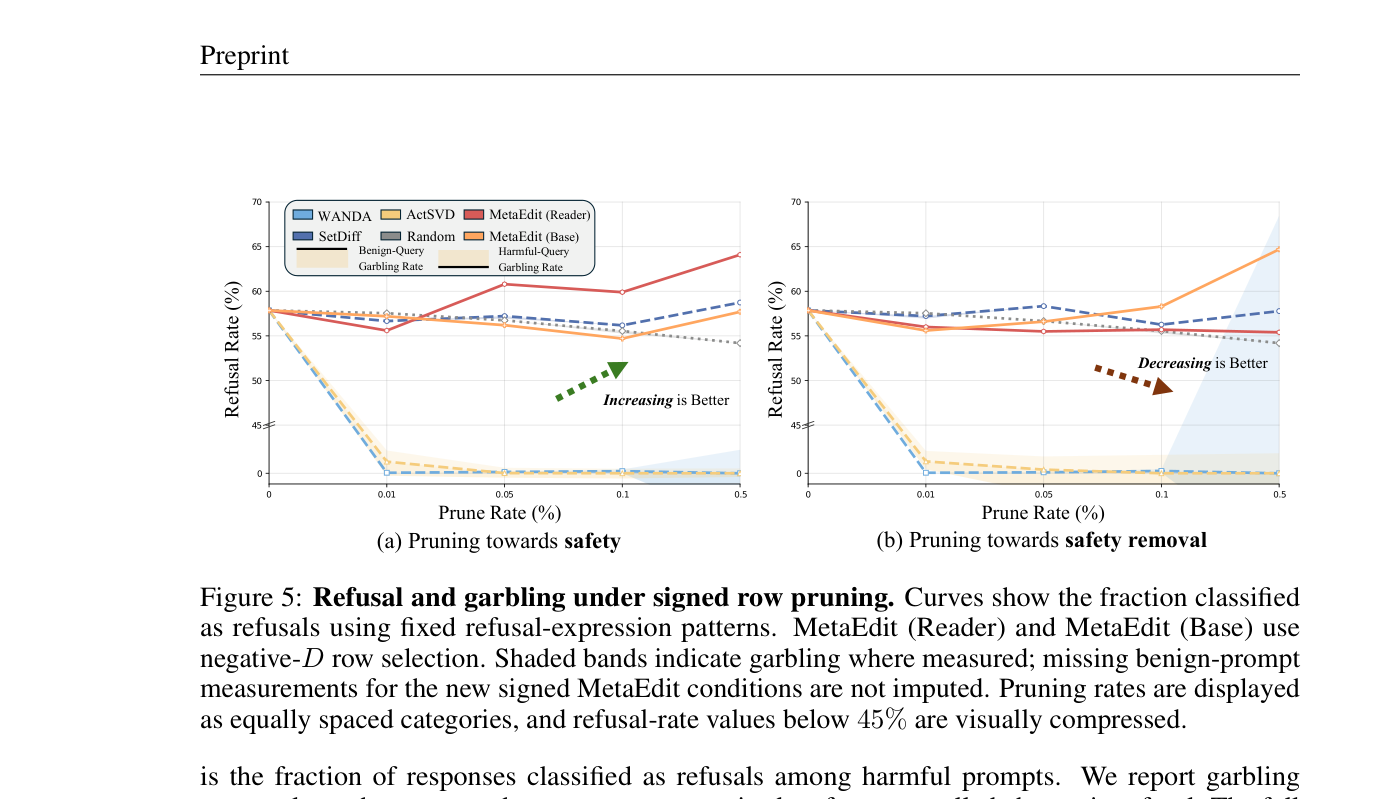
Figure 5 — MetaEdit를 통한 안전 관련 행동 조작(safety maintenance 및 refusal relaxation)의 정량적 결과를 Baseline들과 비교하여 보여주는 그래프
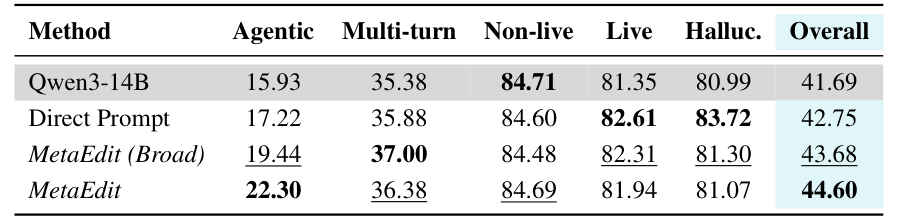
Table 2 — MetaEdit를 통한 BFCL 벤치마크에서의 agentic tool-use 성능 향상을 Direct Prompt 및 Baseline과 비교하여 보여주는 핵심 정량적 결과 테이블
4. Conclusion & Impact
본 연구는 weight update가 새로 습득된 knowledge 및 behavioral change에 대한 signal을 제공할 수 있음을 입증했습니다. Imprint Reader는 이 signal을 자연어로 해독할 수 있으며, 그 coordinate-aligned gradients는 MetaEdit를 통해 original model의 행동에 targeted intervention을 가할 수 있는 새로운 인터페이스를 제공합니다. 이는 모델이 자신의 학습 과정을 검사하고, 검증하며, 궁극적으로 조정할 수 있는 closed-loop AI-for-AI 시스템으로 나아가는 중요한 첫걸음을 제시합니다. 특히, target-task training data 없이도 behavior description만으로 원하는 reasoning style이나 interaction style을 유도할 수 있는 vibe alignment 가능성을 보여주며, LLM의 interpretablity 및 steerability 분야에 큰 시사점을 줍니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] YuE2: Unifying Symbolic and Audio Music Generation at Frontier Quality
- [논문리뷰] WorldPlay2: Extending Real-Time Interactive World Models in Control and Horizon
- [논문리뷰] WideSWE: Can Coding Agents Coordinate Changes Across Repositories?
- [논문리뷰] TraceDance: An Automated System for Building Agent Behavior Benchmarks from Real-World Agent Deployment Traces
Review 의 다른글
- 이전글 [논문리뷰] How Far Are We from Removing the Visual Encoder? Scaling Laws for Encoder-Free Multimodal Pretraining
- 현재글 : [논문리뷰] Imprint Reader: From Weight-Update Readout to Behavioral Intervention
- 다음글 [논문리뷰] Improving Test-Time Scaling with Adaptive Looped Transformers
댓글