[논문리뷰] Improving Test-Time Scaling with Adaptive Looped Transformers
링크: 논문 PDF로 바로 열기
메타데이터
저자: Yichen You, Tianyu Fu, Aosong Feng, Xingtai Lv, Xuefei Ning, Ning Ding, Yu Wang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Looped Transformers: 모델의 레이어를 재사용(reuse)하여 추가적인 latent computation을 수행함으로써, 모델 크기 증가 없이 연산 효율성을 높이는 아키텍처.
- Lookahead Depth Supervision: 토큰별로 추가 반복(iteration)이 예측 성능에 기여하는지 여부를 실시간으로 판별하고, 이를 통해 iteration decider를 학습시키는 지도 학습 기법.
- Accuracy–compute slope: 테스트 타임 디코딩 FLOPs가 두 배로 증가할 때 나타나는 정확도 이득(accuracy gain)을 측정하는 지표.
- Iteration Decider: 토큰의 특성에 따라 추가 반복이 필요한지 여부를 판단하여 동적으로 연산 깊이(depth)를 할당하는 경량 모듈.
- Test-Time Scaling: 추론 시 더 많은 연산 자원(compute)을 투입하여 모델의 추론 성능을 향상시키는 전략.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 post-training을 통해 도입된 Looped Transformers가 테스트 타임 연산량 증가에 비례하여 정확도를 충분히 향상시키지 못하는 한계를 해결하고자 한다. 기존 연구들은 Looped 모델이 고정된 깊이(fixed-depth)로 반복 연산을 수행하게 설계되어, 실제로 연산 이득이 없는 토큰에도 불필요한 비용을 낭비하는 문제점이 있다 [Figure 3]. 이로 인해 기존 Looped 모델들은 Non-looped Baseline(Standard) 대비 steeper한 scaling slope를 보임에도 불구하고, 동일 연산량 조건에서는 오히려 정확도가 낮은 성능 정체 현상을 겪는다 [Figure 1(a)]. 저자들은 추가 반복이 실제로 성능 향상에 도움이 되는 토큰에만 연산 자원을 집중적으로 배분하는 최적화된 방법론의 필요성을 강조한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 토큰별 최적 깊이를 학습하기 위해 TaH2(Training Adaptive Looped Models) 프레임워크를 제안한다 [Figure 2]. TaH2는 backbone 모델과 iteration decider를 공동으로 학습시키며, 실시간(online)으로 측정된 손실 감소량(loss reduction)을 통해 연산 지속 여부를 결정하는 lookahead depth supervision을 사용한다 [Figure 2]. 또한, learned input-injection updater를 통해 반복 간의 정보 전달을 최적화하고, 예측된 stopping probabilities를 활용하여 가중 평균된 출력 확률을 계산한다. 실험 결과, AIME 벤치마크에서 TaH2는 Baseline 대비 정확도-연산 기울기를 53% 향상시켰다(2.74 vs 1.79) [Table 1]. 특히, 최대 반복 깊이(M)가 증가함에 따라 Baseline 모델의 성능이 정체되는 반면, TaH2는 M=2에서 M=8로 갈수록 정확도 이득이 +2.8에서 +3.9 포인트로 지속적으로 커지는 강한 확장성을 입증하였다 [Figure 1(b), Figure 4].
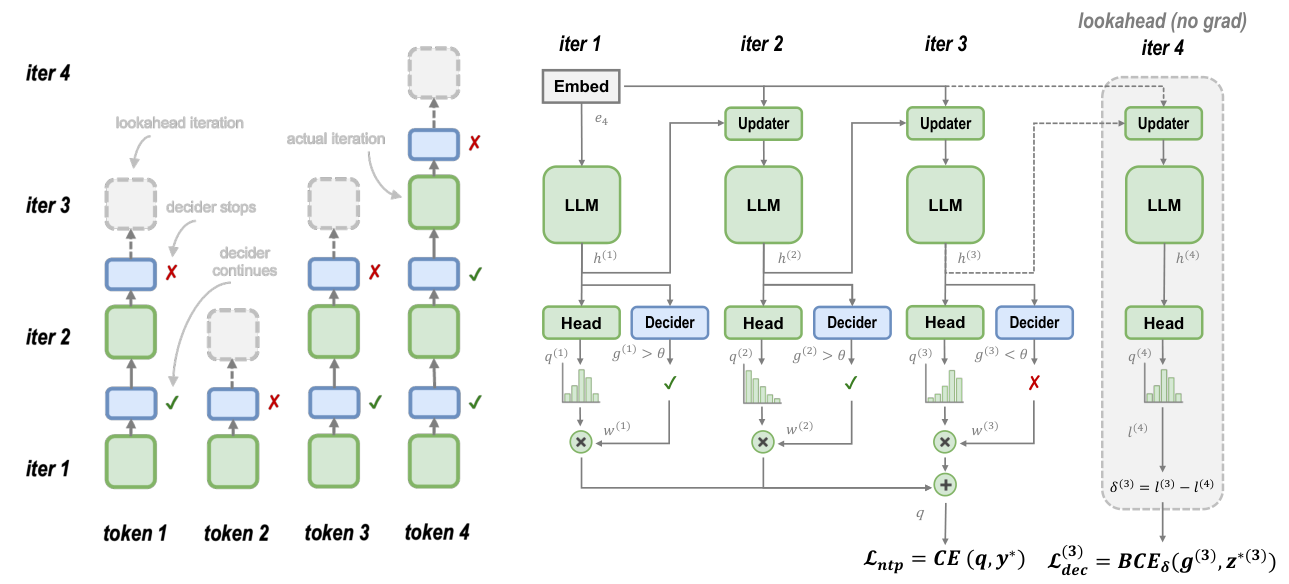
Figure 2 — TaH2 아키텍처 및 학습 구조
4. Conclusion & Impact (결론 및 시사점)
본 연구는 TaH2를 통해 adaptive looping이 테스트 타임 scaling 효율을 극대화할 수 있음을 입증하며, 기존 고정 깊이 Looped Transformer의 한계를 극복하였다. 제안된 방법론은 수학, 코드, QA 등 다양한 도메인과 4B, 8B 규모의 모델에서도 일관된 성능 향상을 보여주며 학계와 산업계의 추론 효율화 연구에 중요한 기여를 한다. 이 연구는 대규모 언어 모델의 post-training 과정에서 적응형 연산(adaptive computation)을 도입하는 것이 실제 서비스 환경에서의 추론 품질 및 비용 효율성을 높이는 데 핵심적임을 시사한다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Small RL Controller, Large Language Model: RL-Guided Adaptive Sampling for Test-Time Scaling
- [논문리뷰] Parallel Loop Transformer for Efficient Test-Time Computation Scaling
- [논문리뷰] Sample Count Is Not Enough: Candidate-Generation Strategy Shapes the Energy and Performance of LLM Test-Time Scaling
- [논문리뷰] EM^2Mem: Event-Centric Multimodal Memory for Large Language Models
- [논문리뷰] ParaTempo: Efficient Parallel Reasoning via Temporal Confidence
Review 의 다른글
- 이전글 [논문리뷰] Imprint Reader: From Weight-Update Readout to Behavioral Intervention
- 현재글 : [논문리뷰] Improving Test-Time Scaling with Adaptive Looped Transformers
- 다음글 [논문리뷰] In-Flight KV Cache with Clean Anchors for Faster Autoregressive Video Diffusion
댓글