[논문리뷰] Program-Verified Self-Evolution for Vision-Language Models
링크: 논문 PDF로 바로 열기
저자: Ahmed Heakl, Sungik Choi, Moontae Lee, Salman Khan
1. Key Terms & Definitions (핵심 용어 및 정의)
- VQS (Verifiable QA Generation): 외부 주석 없이 deterministic programs를 통해 질문과 정답을 생성하고, visual facts를 검증하여 모델을 개선하는 프레임워크입니다.
- Structured Parse: 사진, 차트, 다이어그램 등 입력 이미지를 탐색 가능한 JSON 구조(Scene Graph, Table, Directed Graph 등)로 변환한 형태입니다.
- GRPO (Group Relative Policy Optimization): 정답과 일치하는지 여부에 따라 rollouts의 보상을 정규화하여 학습하는 강화학습 알고리즘입니다.
- Fact-Check: parser가 생성한 structured parse의 각 atomic claim이 이미지와 일치하는지 visual checker를 통해 개별적으로 검증하는 프로세스입니다.
- Blind Gate: 이미지를 보지 않고 질문만으로 정답을 맞힐 수 있는지 테스트하여, 이미지 의존도가 낮은 질문을 필터링하는 메커니즘입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 self-evolving vision-language models가 의존하던 proxy labels(Majority voting 또는 Model-judge)의 낮은 정확도와 점진적인 성능 저하 문제를 해결합니다. 이전 연구들은 생성된 질문에 대해 금본위제(Gold label)가 없는 환경에서 다수결 투표나 다른 모델의 판단에 의존했으나, 이는 18~24%의 오답을 포함하는 등 신뢰성 부족을 야기했습니다. 특히 학습이 진행될수록 잘못된 신호를 강화하여 모델의 성능이 정체되거나 붕괴하는 현상이 관찰되었습니다. 따라서 저자들은 검증 가능한 시각적 사실(Verified visual facts)을 기반으로 학습 데이터를 구축하는 새로운 접근 방식이 필요하다고 보았습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 구조화된 파싱과 프로그래밍 기반의 자동 질문 생성을 결합하여 라벨 없는 환경에서의 자가 학습 체계를 구축합니다. Parser는 입력을 domain-specific JSON 구조로 변환하며, 이후 Fixed templates를 통해 deterministic하게 질문과 정답을 생성합니다. 특히 생성된 질문은 Fact-check, Blind gate, Difficulty band의 3단계 필터를 거쳐 정제되며, 정제된 데이터는 GRPO를 통해 모델을 학습시키는 데 사용됩니다. 실험 결과, VQS는 Qwen3-VL 모델의 2B, 4B, 8B 모든 규모에서 기존 self-evolving baseline을 압도하는 성능을 보였습니다. 2B 모델 기준 평균 성능은 +3.18 포인트 상승했으며, 3회 학습 라운드를 거치며 최종적으로 +3.84 포인트까지 성능 개선이 지속되었습니다. 특히 MMMU 및 ScienceQA와 같은 복합적인 추론이 필요한 벤치마크에서 기존 방식 대비 월등한 정확도 향상을 기록했습니다 [Table 1]. 또한, human evaluation 결과, VQS가 생성한 답안의 정확도는 94.4%로, majority voting(76.4%)이나 model-judge(82.2%) 대비 현저히 높음이 입증되었습니다 [Table 2].
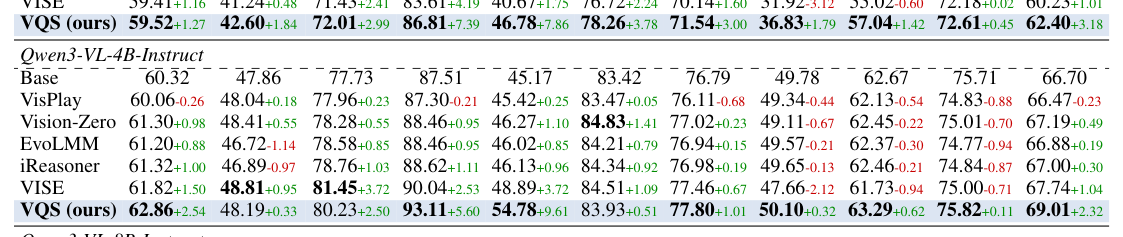
Table 1 — 3개 모델 규모에서의 벤치마크 성능 개선 결과 비교 테이블
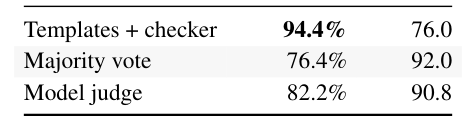
Table 2 — 생성된 질문에 대한 인간 평가 기반 정확도 비교
4. Conclusion & Impact (결론 및 시사점)
본 연구는 모델이 스스로 생성한 데이터의 오류를 deterministic하게 검증하고 제거할 수 있는 구조화된 self-evolution 프레임워크를 정립하였습니다. 이는 vision-language model 학습에서 인간의 라벨링 데이터에 대한 의존도를 근본적으로 줄이고, 장기적인 학습 과정에서도 안정적으로 성능 향상을 도모할 수 있음을 보여줍니다. 제시된 검증 기법은 다양한 시각적 도메인에 적용 가능하며, 특히 대규모 언어 모델의 추론 및 지식 관련 벤치마크 점수를 극적으로 향상시킴으로써 향후 자가 학습 모델 연구의 중요한 이정표가 될 것으로 기대됩니다.
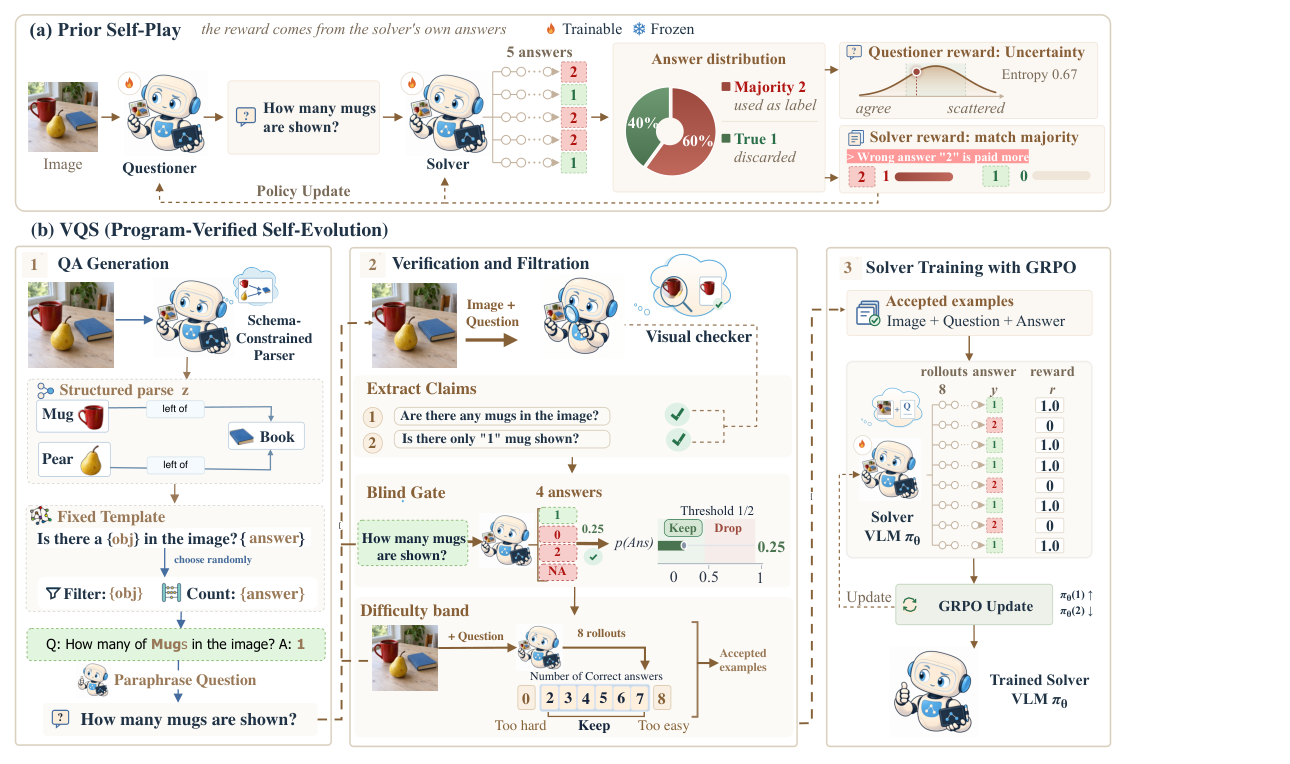
Figure 2 — 기존 방식과 VQS의 방법론적 차이를 보여주는 핵심 프레임워크 다이어그램
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Rubrics as Visual-Repair Context for Self-Evolving UI-to-Code Generation
- [논문리뷰] VaseMuseum: Digital Intelligent Museum for Ancient Greek Pottery
- [논문리뷰] Rank-Then-Act: Reward-Free Control from Frame-Order Progress
- [논문리뷰] Agent Explorative Policy Optimization for Multimodal Agentic Reasoning
- [논문리뷰] SpatialEvo: Self-Evolving Spatial Intelligence via Deterministic Geometric Environments
Review 의 다른글
- 이전글 [논문리뷰] Precise Editing and Flexible Referencing for Interactable Worlds
- 현재글 : [논문리뷰] Program-Verified Self-Evolution for Vision-Language Models
- 다음글 [논문리뷰] QwenGyre: An Elastic Reinforcement Learning Framework for Training xLong-Horizon Agents
댓글