[논문리뷰] Periodic Weak Spots: Phase Sensitivity from Chunked KV-Cache Compression
링크: 논문 PDF로 바로 열기
저자: Xingyu Zhu, Pu (Luke) Yi, Ziheng Cheng, et al.
키워: KV-cache compression, phase sensitivity, phase specialization, long-context inference, retrieval accuracy, causal intervention, gradient flow
1. Key Terms & Definitions (핵심 용어 및 정의)
- Chunked KV-cache compression: Transformer의 long-context inference 시 메모리 및 attention 비용을 줄이기 위해 연속적인 token window를 더 적은 cache entry로 압축하는 기법입니다.
- Phase: Compression-window 경계에 대한 token의 상대적 위치, 즉
position modulo S로 정의되는 새로운 positional coordinate입니다. - Phase sensitivity: Source 정보의
phase에 따라 retrieval 성능이 급격하고 주기적으로 변동하는 체계적인 비대칭 현상으로, 특정phase에서는 정보 검색이 용이하고 다른phase에서는 어려운 현상을 말합니다. - Phase specialization: Retrieval에 기여하는 attention head 구성 요소들이 다른 source
phase에서 비대칭적으로 작동하는 현상입니다. - Needle-in-a-Haystack (NIAH) retrieval: 긴 context 내에서 특정 key-value 쌍을 검색하는 모델의 능력을 체계적으로 측정하기 위해 고안된 제어된 retrieval task입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
Long-context inference는 KV cache의 메모리 및 attention 비용으로 인해 bottleneck 현상을 겪으며, chunked KV-cache compression은 DeepSeek-V4 모델 등에서 사용되는 실용적인 해결책입니다. 본 논문은 이러한 압축 방식이 phase라는 새로운 positional coordinate를 도입하고, 이 phase에 따라 retrieval 성능이 체계적으로 비대칭적으로 변동하는 phase sensitivity를 유발함을 밝힙니다. 이 phase sensitivity는 average benchmark scores로는 숨겨질 수 있는 주기적인 weak spots을 형성하여 모델의 신뢰성에 문제를 제기합니다. 예를 들어, DeepSeek-V4 모델에서 장식용 주석의 길이를 조절하여 code snippet의 phase를 변경하면, 모델의 next-token 예측이 주기적으로 반전되는 현상이 관찰되었습니다 [Figure 1]. 이러한 문제점은 chunked KV-cache compression을 사용하는 모델의 실제 배포 및 평가에 중요한 영향을 미칩니다.
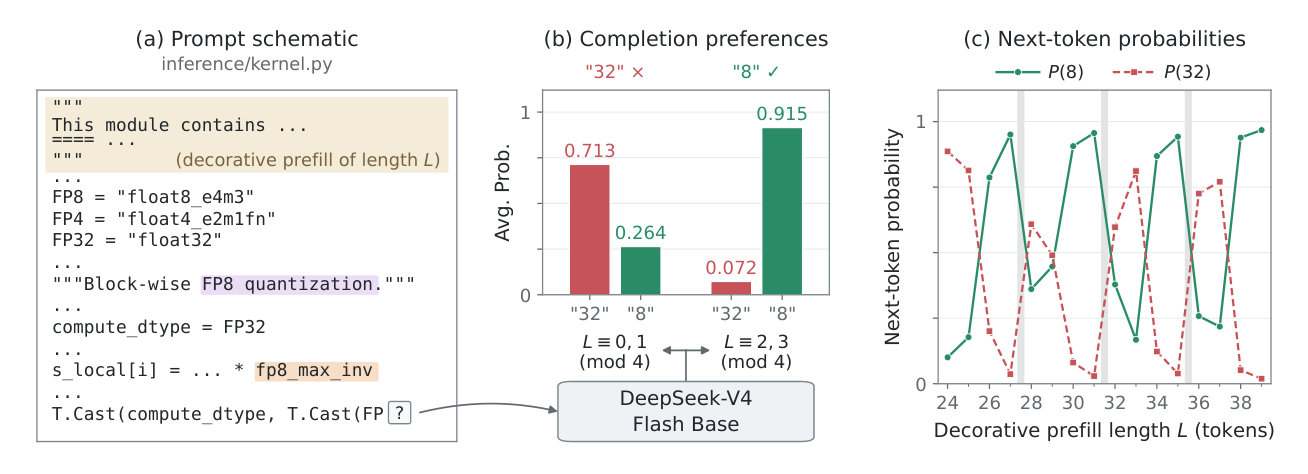
Figure 1 — 모델의 phase sensitivity 현상을 코드 완성 예시를 통해 직접적으로 보여주는 핵심 그림
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 chunked KV-cache compression이 phase sensitivity의 원인임을 체계적으로 조사하기 위해, Qwen3-0.6B 아키텍처를 기반으로 하는 transformer 모델들을 처음부터 pretrain하고 다양한 KV-compression 디자인을 실험했습니다. 주요 방법론은 NIAH retrieval task를 사용하여 source-key phase에 따른 retrieval accuracy를 측정하고 [Figure 2, Figure 3], causal interventions (KV-head knockouts)을 통해 각 phase에서 어떤 attention component가 정보 retrieval에 기여하는지 분석하는 것입니다 [Figure 4]. 또한 compression gates의 pretraining dynamics 및 이상적인 retrieval models의 gradient flow를 분석하여 phase specialization의 발생 메커니즘을 이론적으로 설명했습니다 [Figure 5].
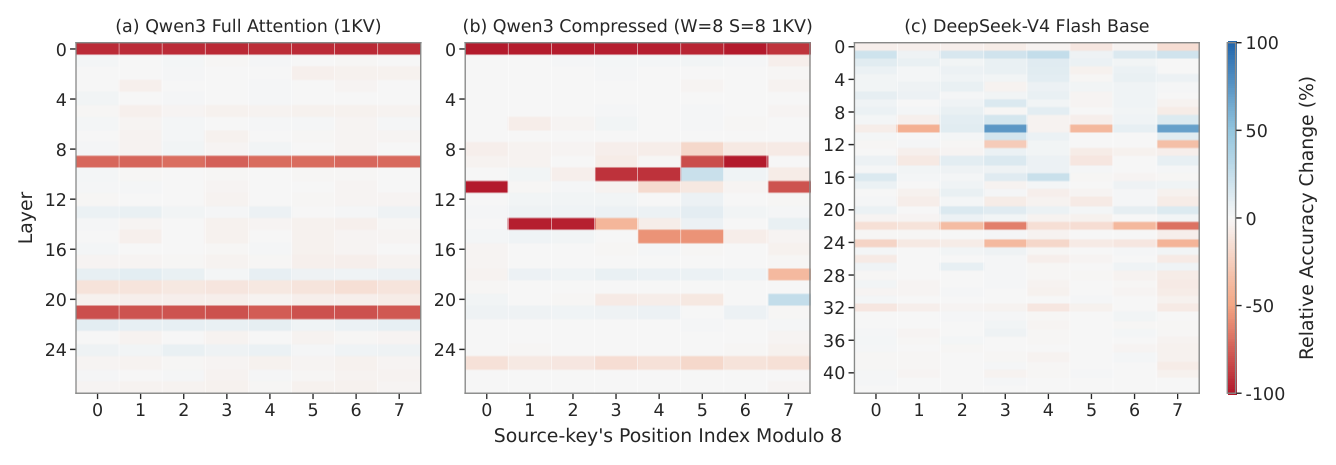
Figure 4 — KV-head knockout을 통해 attention head들의 phase specialization을 보여주는 메커니즘 분석의 핵심 시각화 자료
핵심 결과는 다음과 같습니다. 첫째, DeepSeek-V4 계열 모델은 128K context에서 retrieval accuracy가 phase에 따라 최대 40.2 percentage points까지 차이 나는 phase sensitivity를 보였습니다 [Figure 2]. 이는 평균 벤치마크 점수로는 숨겨질 수 있는 주기적인 weak spots이 존재함을 의미합니다. 둘째, 새롭게 pretrain된 모든 압축 모델에서 compression stride와 일치하는 주기적인 phase sensitivity가 재현되었으며, full-attention baseline 모델에서는 이러한 주기성이 관찰되지 않았습니다 [Figure 3]. 셋째, KV-head knockouts을 통한 mechanistic analysis는 phase specialization을 밝혔습니다. 즉, 특정 attention head들이 특정 source phase의 정보 retrieval에 비대칭적으로 기여하며, relative accuracy change는 최대 100%에 달했습니다 [Figure 4]. 마지막으로, 이론적 분석에 따르면 gradient flow dynamic은 compression gates가 sharp phase specialization을 선호하도록 유도하여, 향후 query가 불확실하더라도 head들이 특정 offset (phase)을 지속적으로 선호하는 static concentration이 발생할 수 있음을 보여주었습니다 [Figure 5].
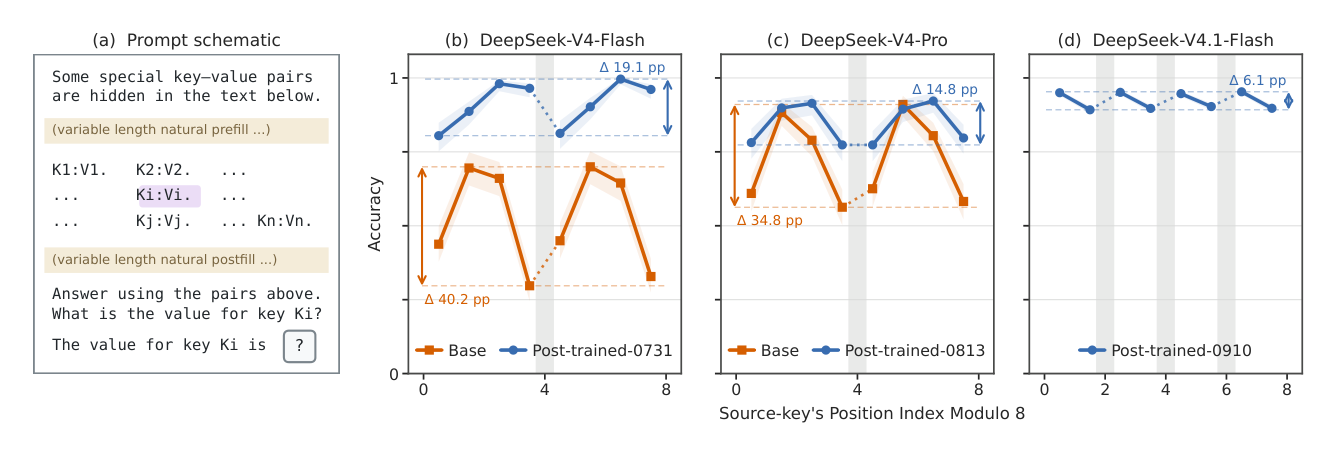
Figure 2 — DeepSeek-V4 모델에서 NIAH retrieval task를 통해 phase sensitivity의 정량적 증거를 보여주는 핵심 결과 그래프
4. Conclusion & Impact (결론 및 시사점)
본 연구는 chunked KV-cache compression이 transformer 모델에 phase sensitivity라는 체계적인 실패 모드를 도입하여 retrieval accuracy에 주기적인 weak spots을 발생시킨다는 것을 확인했습니다. 이러한 현상은 DeepSeek-V4 및 본 연구에서 pretrain된 모든 압축 모델에서 compression stride와 일치하는 주기로 나타났습니다. KV-head knockouts 및 compression gate 분석을 통해, attention head들이 phase에 따라 specialization되고 static concentration을 보이는 것이 이러한 phase sensitivity의 주요 원인임을 밝혀냈습니다.
이 연구는 chunked KV-cache compression을 사용하는 모델을 평가할 때 average accuracy만으로는 충분하지 않으며, compression phases 전반에 걸쳐 retrieval accuracy를 측정하여 체계적인 positional failures를 식별해야 함을 시사합니다. 이는 모델의 robustness-relevant behavior와 신뢰성 평가에 새로운 기준을 제시하며, 향후 연구에서는 retrieval quality를 희생하지 않으면서 phase 전반에 걸쳐 더 균일한 성능을 달성하는 방법과 phase sensitivity가 모델의 refusal 또는 compliance와 같은 robustness 특성에 미치는 영향을 탐구할 필요성을 제기합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] WorldLine: Action-Driven Visual Simulation for Robotic Manipulation
- [논문리뷰] WorldAttention: An Efficient Attention Architecture for Interactive Video World Models
- [논문리뷰] When Does Dense Retrieval Need Asymmetric Geometry? A Bias-Variance Theory of Shared and Dual Projections
- [논문리뷰] What Makes World Action Models Generalize? An Empirical Study of Test-Time Future Modeling
Review 의 다른글
- 이전글 [논문리뷰] PanoVLN: Towards Effective Panoramic Vision-and-Language Navigation
- 현재글 : [논문리뷰] Periodic Weak Spots: Phase Sensitivity from Chunked KV-Cache Compression
- 다음글 [논문리뷰] ROSS: Relearning from Self-Generated Rollouts through Selective Supervision
댓글