[논문리뷰] Reasoning with Image Generation
링크: 논문 PDF로 바로 열기
저자: Nishad Singhi, Hector Garcia Rodriguez, et al.
1. Key Terms & Definitions
- ReImaGin: Large Language Models (LLMs)에 instruction-tuned image generation model을 유연한 visual reasoning 메커니즘으로 활용하는 multimodal agent framework이다.
- Chain-of-Thought (CoT): LLMs가 복잡한 문제를 중간 추론 단계로 분해하여 답변하도록 돕는 자연어 처리 패러다임이다.
- Multimodal LLMs (MLLMs): 텍스트뿐만 아니라 이미지와 같은 다양한 양식의 입력을 이해하고 처리할 수 있는 대규모 언어 모델을 지칭한다.
- Generative Tools: 자연어 명령을 받아 개방형 시각 작업을 수행할 수 있는 이미지 생성 모델로, 기존의 고정 기능
visual expert tools와 달리 유연한 변환이 가능하다. - Test-Time Scaling: 이미지 생성 모델의 확률적 특성을 활용하여, 동일한 프롬프트로 여러 후보 이미지를 생성한 후 MLLM이 가장 충실한 이미지를 선택함으로써 생성 이미지의 품질을 향상시키는 기법이다.
2. Motivation & Problem Statement
본 논문은 Chain-of-Thought (CoT) 추론이 주로 텍스트 도메인에 국한되어, 시각적 표현의 직접적인 조작이나 공간적/물리적 직관을 요구하는 태스크에서 한계를 보이는 문제를 해결하고자 한다. 기존의 Multimodal LLMs (MLLMs)는 depth estimation이나 object detection과 같은 external visual expert tools를 활용하지만, 이러한 specialist tools는 고정되고 경직된 작업에 의존하여 유연한 generative 또는 복잡한 시각적 변환을 수행할 수 없다. 또한, 이러한 tools의 사용 방법을 handcrafted in-context examples를 통해 모델에 가르쳐야 하므로 수동적인 노력과 새로운 태스크로의 일반화가 어렵다는 한계가 있다. 따라서, 저자들은 MLLM이 다양한 시각적 추론 태스크를 처리할 수 있도록, 유연하고 개방형의 visual reasoning mechanism이 필요함을 지적한다.
3. Method & Key Results
저자들은 instruction-tuned image generation model을 유연한 visual reasoning mechanism으로 활용하는 ReImaGin이라는 multimodal agent framework를 제안한다. ReImaGin은 textual Chain-of-Thought와 image generation model 호출을 번갈아 사용하며, generate_image tool을 통해 자연어 명령으로 occlusion removal, depth map generation, floorplan synthesis 등 광범위한 시각적 변환을 수행할 수 있다 [Figure 1, 2]. 이 agent architecture는 ReAct framework를 기반으로 하며, generative tool과 함께 crop, overlay 등과 같은 programmatic image utilities도 활용한다. 특히, spatial reasoning과 같이 생성 이미지의 faithfulness가 중요한 태스크에서는 Test-Time Scaling 기법을 적용하여 여러 후보 이미지를 생성하고 MLLM을 통해 최적의 이미지를 선택함으로써 reasoning accuracy를 향상시킨다.
ReImaGin은 Depth Reasoning, Puzzle Completion, Occlusion Counting, Collision Prediction, Multi-View Spatial Reasoning, Path Tracing을 포함한 6가지 다양한 visual reasoning tasks에서 text-only reasoning 및 Visual Sketchpad와 같은 specialist vision-tool baselines보다 일관되게 우수한 성능을 보여주었다 [Table 1]. 구체적으로, Path Tracing 태스크에서는 최대 25%, Occlusion Counting 태스크에서는 40% 상대적인 성능 향상을 달성했다. 또한, Spatial Reasoning (MMSI) 태스크에서 Test-Time Scaling을 적용한 결과 Gemini-3.1-Pro 모델의 accuracy가 51.0%에서 59.0%로 크게 개선되었다. 또한, handcrafted strategies의 대부분의 이점을 재현하고 인간이 고안한 것과 유사한 visual reasoning strategies가 Automated Strategy Discovery를 통해 자동으로 발견될 수 있음을 입증하며, 이는 MLLMs가 특정 visual transformations이 태스크에 도움이 되는지에 대한 유용한 prior 지식을 가지고 있음을 시사한다 [Figure 5]. generate_image tool을 ablation한 실험에서는 모든 6가지 태스크에서 성능 저하가 발생하여, generative capability 자체가 성능 향상에 필수적임을 확인했다 [Table 7].
4. Conclusion & Impact
ReImaGin은 image generation을 multimodal reasoning의 유연한 메커니즘으로 활용하여, MLLMs가 텍스트나 고정된 specialist visual tools의 한계를 넘어 open-ended visual transformations을 수행할 수 있음을 입증한다. 이 연구는 image generation이 multimodal reasoning 내에서 일반적인 visual imagination mechanism으로 작용하여, 새로운 변환마다 개별적인 tool engineering의 필요성을 줄일 수 있음을 시사한다. 또한, Automated Strategy Discovery를 통해 효율적인 reasoning strategy를 자동으로 찾을 수 있음을 보여주며, human-authored task-specific strategies 없이도 모델이 시각적 변환에 대한 이해를 활용할 수 있음을 강조한다. 궁극적으로 이 연구는 시각적 장면을 단순히 설명하는 것을 넘어, 복잡한 문제를 해결하기 위해 시각적 콘텐츠를 능동적으로 생성하고 변환할 수 있는 multimodal systems 개발의 중요한 진전을 제시한다.
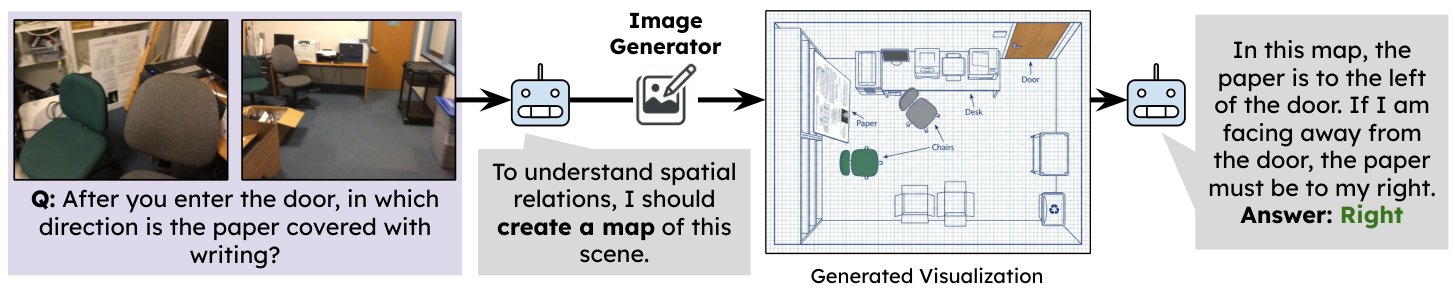
Figure 1 — 제안 모델 ReImaGin 개요 및 성능
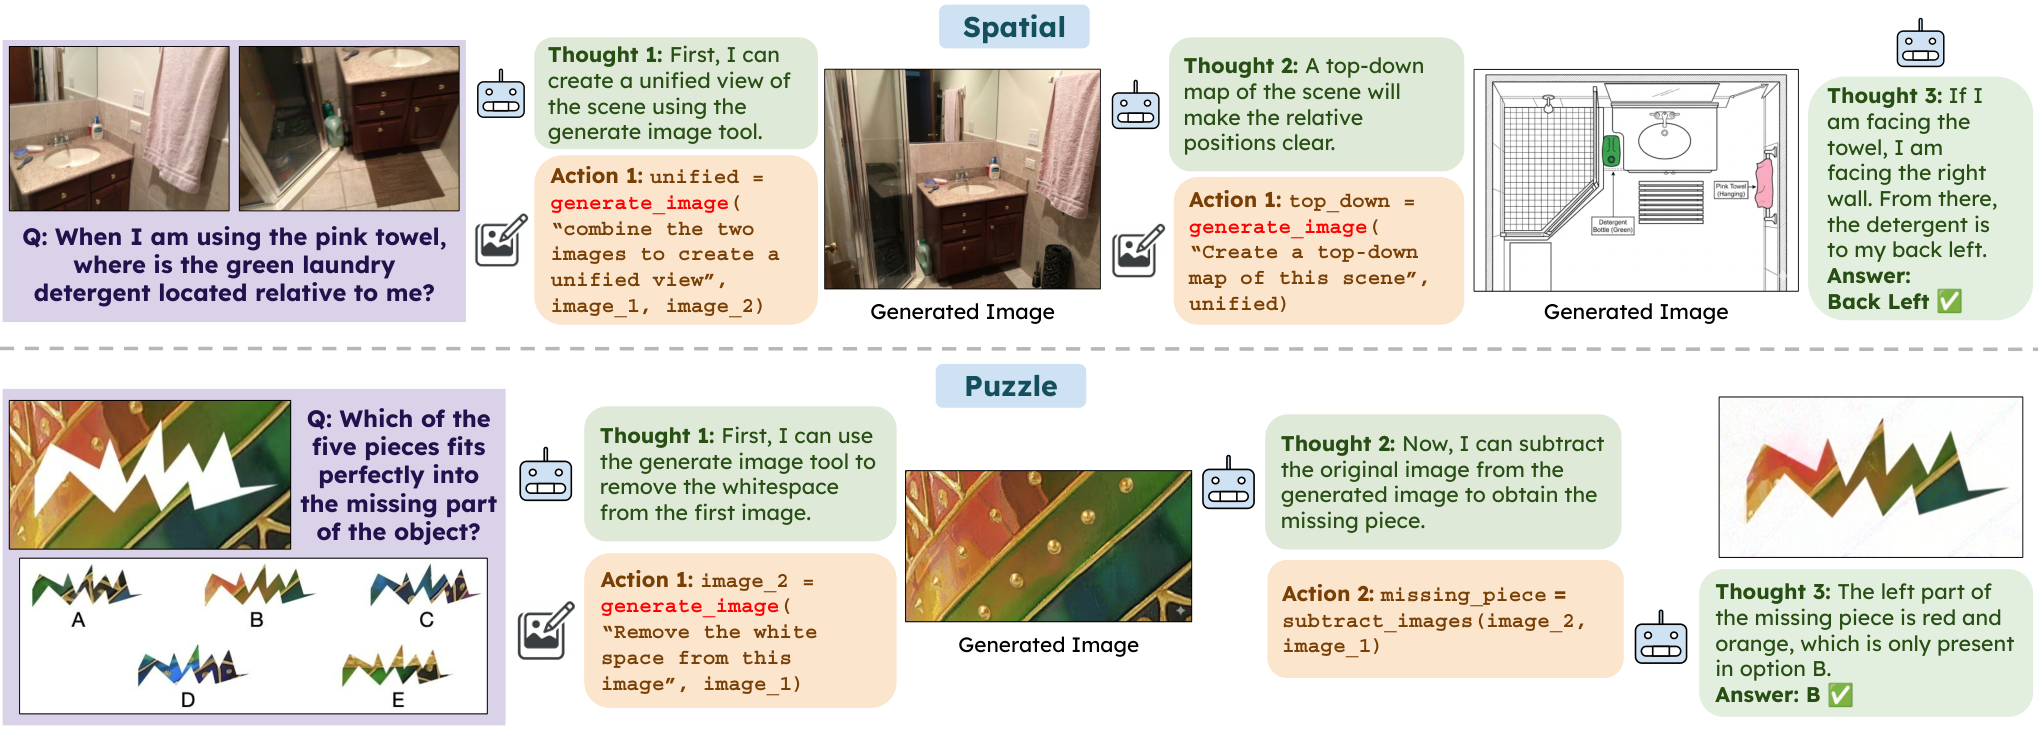
Figure 2 — ReImaGin 방법론 개요
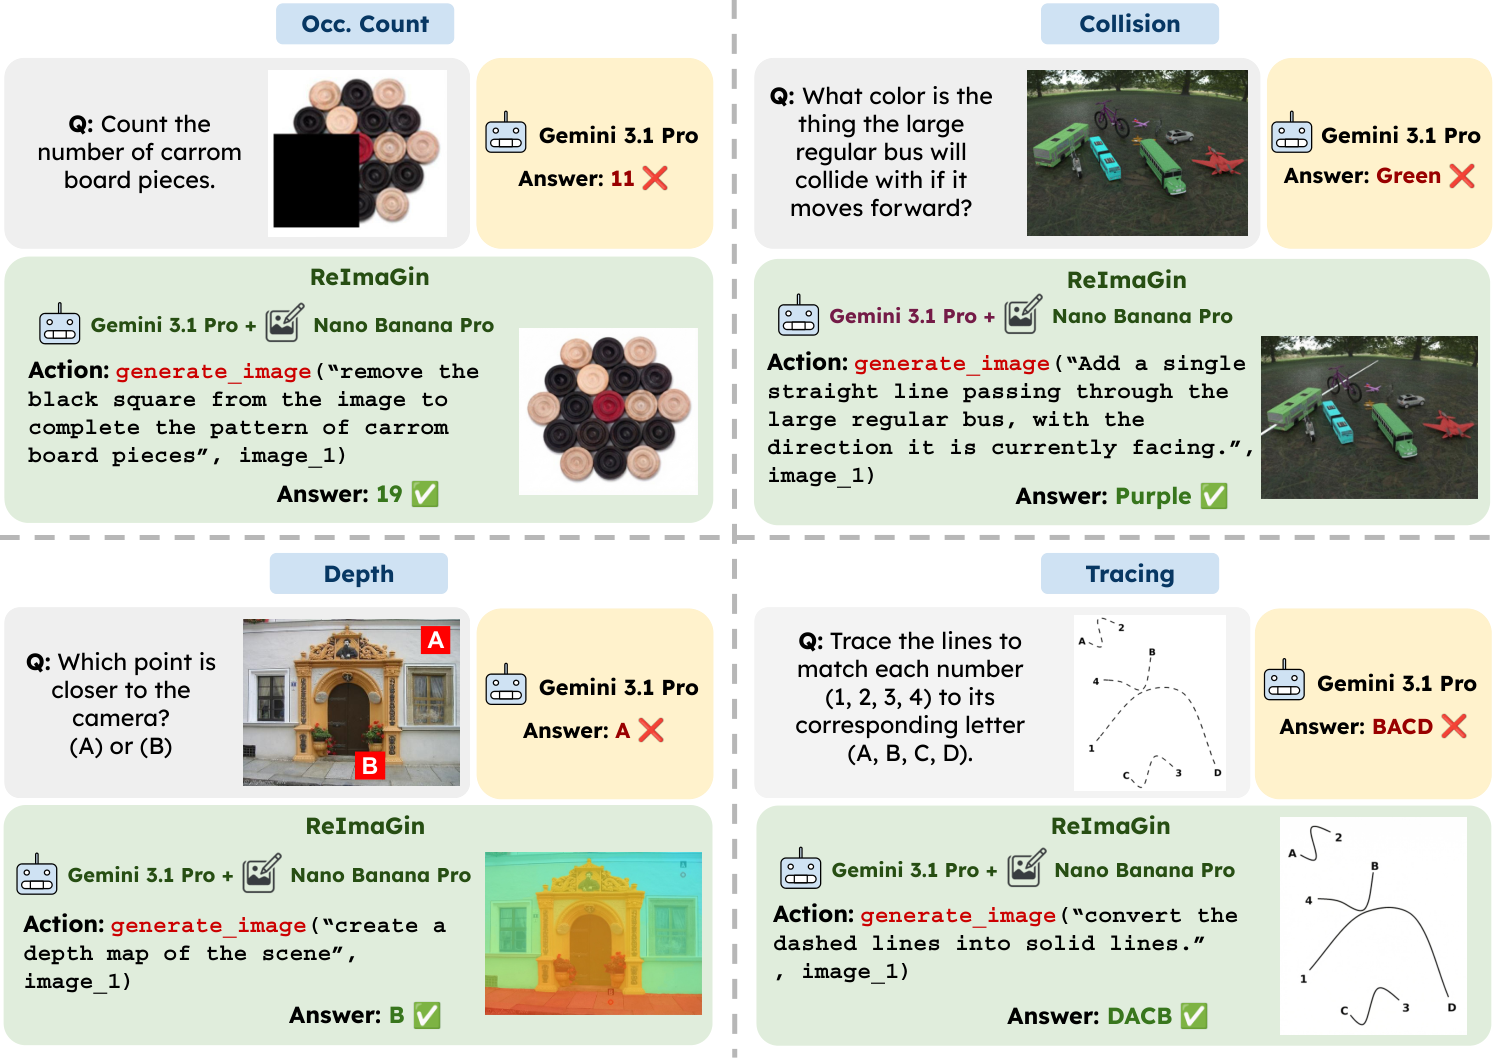
Figure 4 — ReImaGin의 정성적 추론 예시
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] UniT: Unified Multimodal Chain-of-Thought Test-time Scaling
- [논문리뷰] MME-CC: A Challenging Multi-Modal Evaluation Benchmark of Cognitive Capacity
- [논문리뷰] Hard Vision, Easy Vision: What GPT-6 Astra Reveals Across Computer Vision
- [논문리뷰] VBVR-Pro: A Scalable and Verifiable Suite for Native Visual Reasoning
- [논문리뷰] See2Think: Do Multimodal Models Really Use Intermediate Visual States?
Review 의 다른글
- 이전글 [논문리뷰] Raven: The Harness of Harnesses for Composable Agentic Intelligence
- 현재글 : [논문리뷰] Reasoning with Image Generation
- 다음글 [논문리뷰] Routing Should Pay for Itself: Sparse Supervision for Economical LLM Routing
댓글