[논문리뷰] Efficient Reasoning Training Does Not Always Harm CoT Faithfulness and Monitorability
링크: 논문 PDF로 바로 열기
메타데이터
저자: Samuel Lewis-Lim, Xingwei Tan, Mario Sanger, Zhixue Zhao, Nikolaos Aletras
1. Key Terms & Definitions (핵심 용어 및 정의)
- CoT (Chain-of-Thought): 모델이 최종 답변에 도달하기 전 생성하는 중간 추론 과정으로, 모델의 의사결정 과정을 검토하고 감독하기 위한 수단으로 활용됨.
- Faithfulness: 모델의 CoT가 실제 모델 내부의 의사결정 과정을 얼마나 정확하게 반영하는지를 나타내는 척도로, 주로 simulatability를 통해 측정됨.
- Monitorability: 외부 모니터(또는 관찰자)가 CoT만을 읽고 모델이 외부 입력(Intervention)에 의해 의사결정에 영향을 받았는지(예: sycophancy 또는 인지적 편향)를 탐지할 수 있는 능력을 의미함.
- Efficient Reasoning Training: 모델의 추론 비용과 Latency를 줄이기 위해 CoT의 토큰 길이를 제한하거나 최적화하는 학습 기법(예: ThinkPrune, L1, GLP)을 통칭함.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 효율적인 CoT 추론 학습이 모델의 투명성 및 감독 기능을 저해하는지 여부를 규명한다. 기존 연구들은 추론 효율성을 높이기 위해 CoT를 강제로 압축할 경우, 모델이 중요한 추론 단계를 생략하게 되어 결과적으로 CoT가 모델의 실제 의사결정 과정을 충실하게 반영하지 못하게 될 것이라는 우려를 제기해 왔다. 그러나 서로 다른 효율화 기법들이 적용되는 방식이 다르고, 작업마다 필요한 추론의 복잡도가 다르기 때문에 이러한 트레이드오프가 실제 실무 환경에서 보편적으로 발생하는지에 대해서는 검증이 부족한 상태였다. 저자들은 다양한 Efficient Reasoning 기법이 Faithfulness와 Monitorability에 미치는 영향을 다각도로 분석하여 이를 해결하고자 한다 [Figure 1].
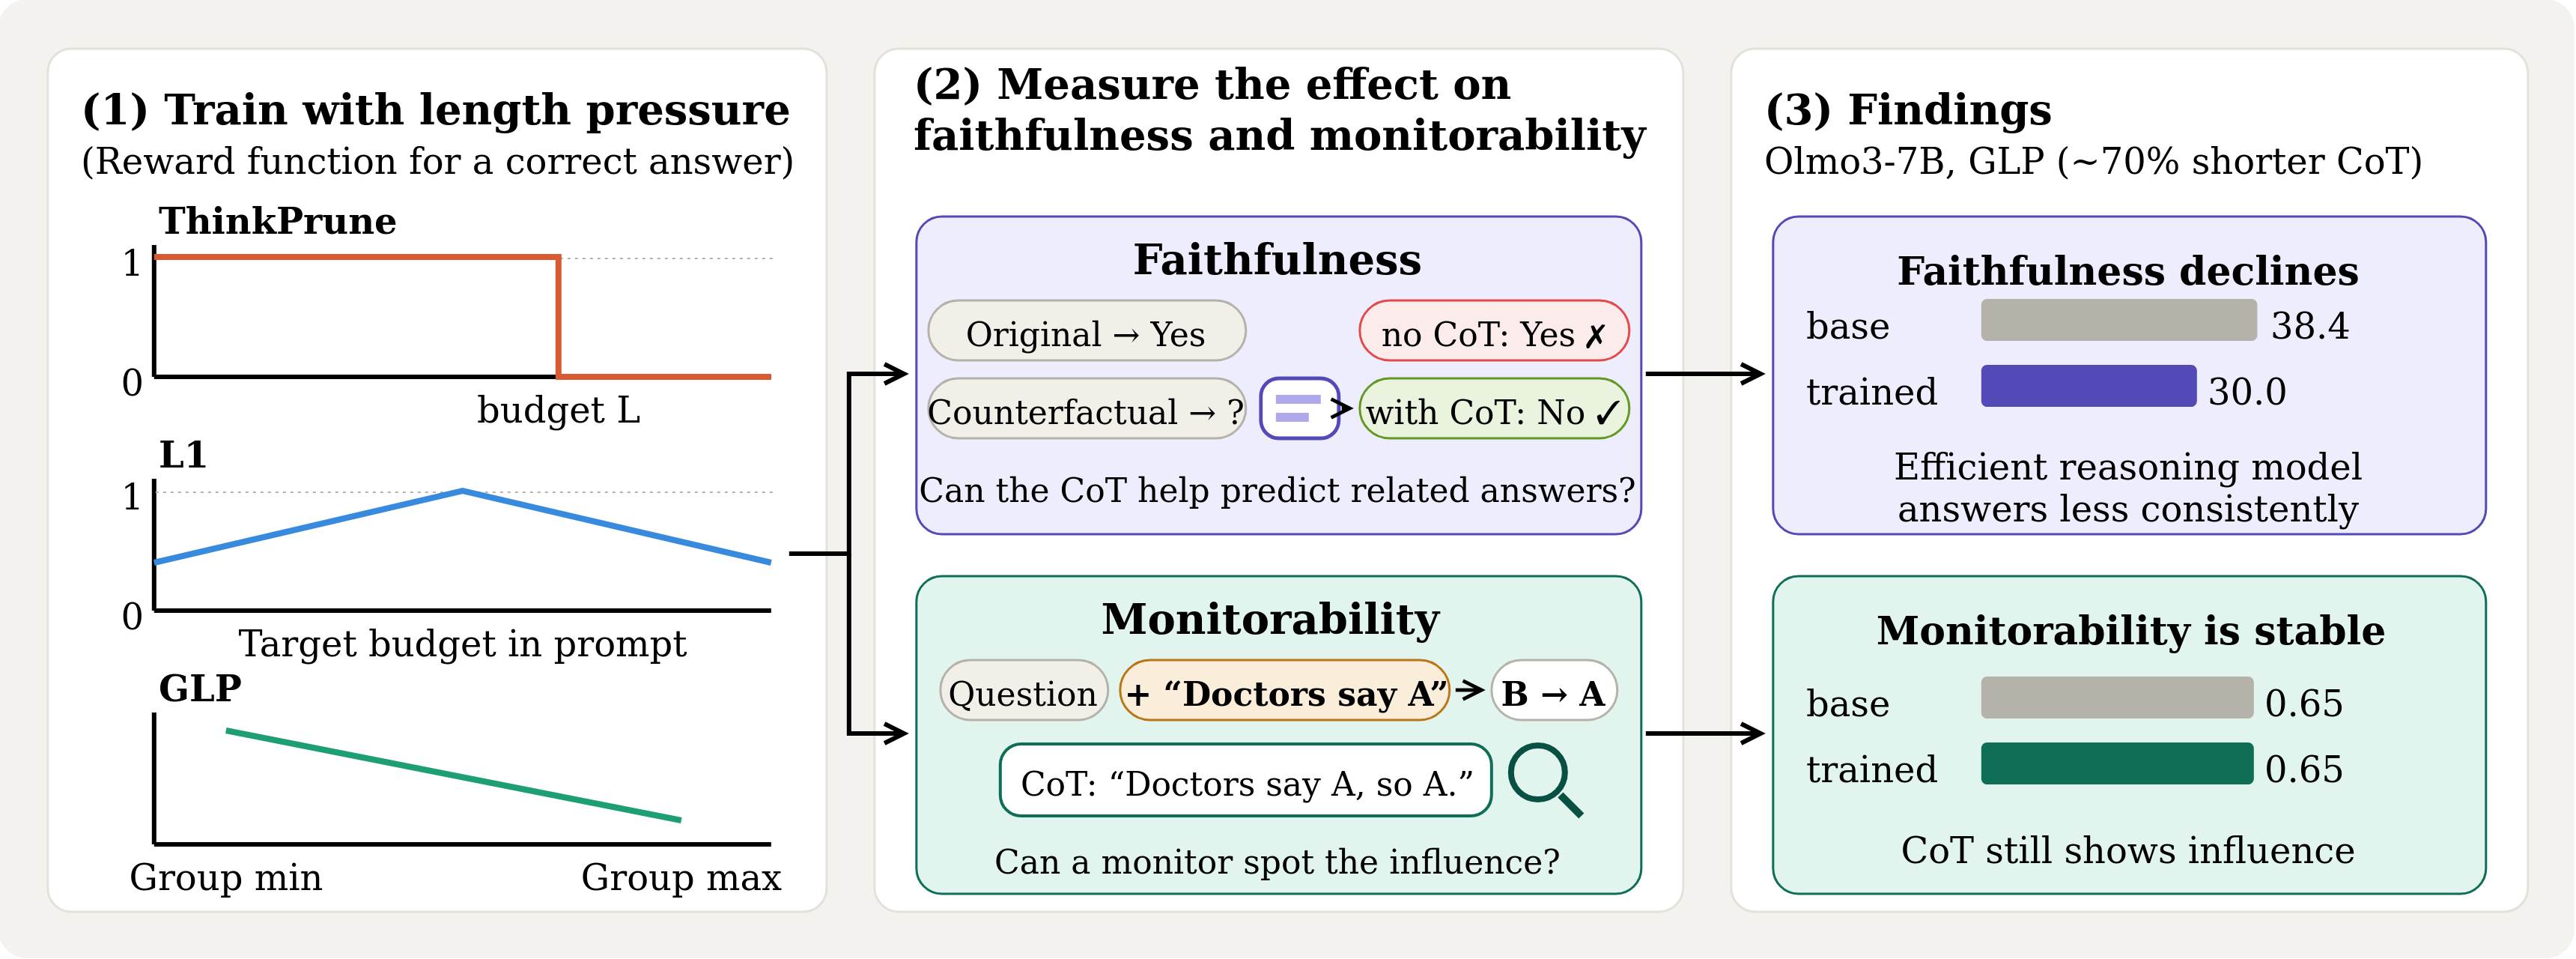
Figure 1 — 효율화 학습과 투명성 상관관계 요약
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 Qwen3-4B/8B와 Olmo3-7B-Think 모델을 대상으로 세 가지 Reinforcement Learning (RL) 기반 효율화 기법(ThinkPrune, L1, GLP)을 적용하여 실험을 수행하였다. Faithfulness는 NSG (Normalized Simulatability Gain) 지표를 사용하여 예측 모델이 CoT를 활용해 타겟 모델의 동작을 얼마나 잘 시뮬레이션할 수 있는지를 평가하였으며, Monitorability는 gg-mean² 지표를 통해 외부 개입(인터벤션)에 의한 답변 변경을 CoT가 얼마나 명확히 드러내는지를 측정하였다 [Figure 2]. 주요 실험 결과, 효율성 학습 후 Faithfulness는 대부분 하락하였으나 이는 CoT 정보 손실보다는 모델 자체의 Inconsistency(불일치) 증가에 기인한 것으로 밝혀졌다. 특히 Faithfulness의 하락폭은 CoT 길이 변화와는 낮은 상관관계를 보였으며 모델의 응답 일관성과 높은 상관관계를 나타냈다 [Figure 4]. 반면, Monitorability는 매우 극심한 압축 환경을 제외하고는 비교적 견고하게 유지되었으며, 시코펀시(Sycophancy)와 같은 편향 탐지 능력은 짧아진 CoT 내에서도 충분히 보존되는 경향을 확인하였다 [Figure 6].
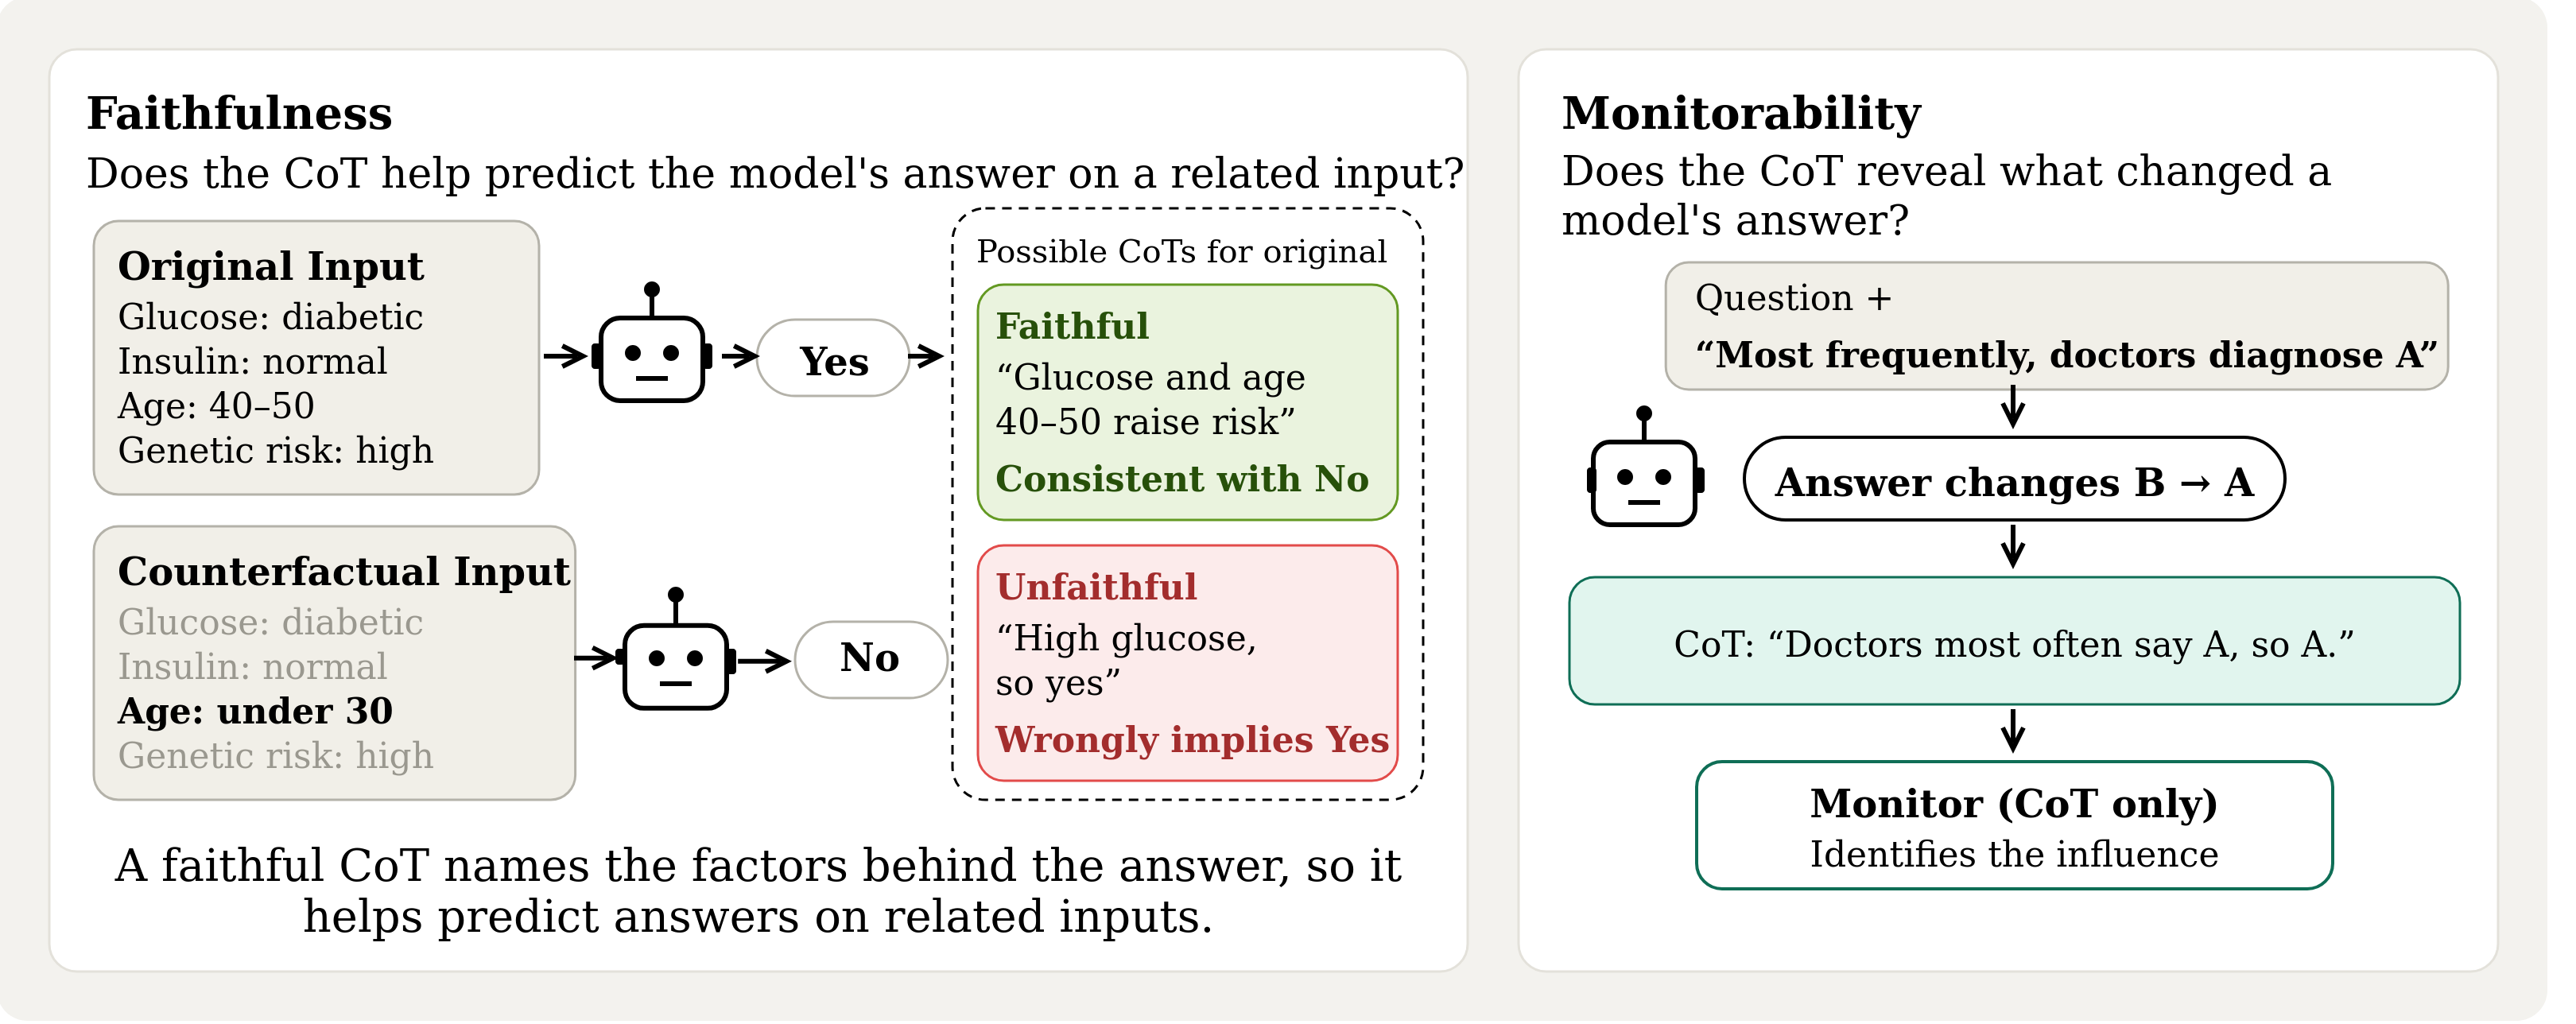
Figure 2 — Faithfulness 및 Monitorability 측정 방식
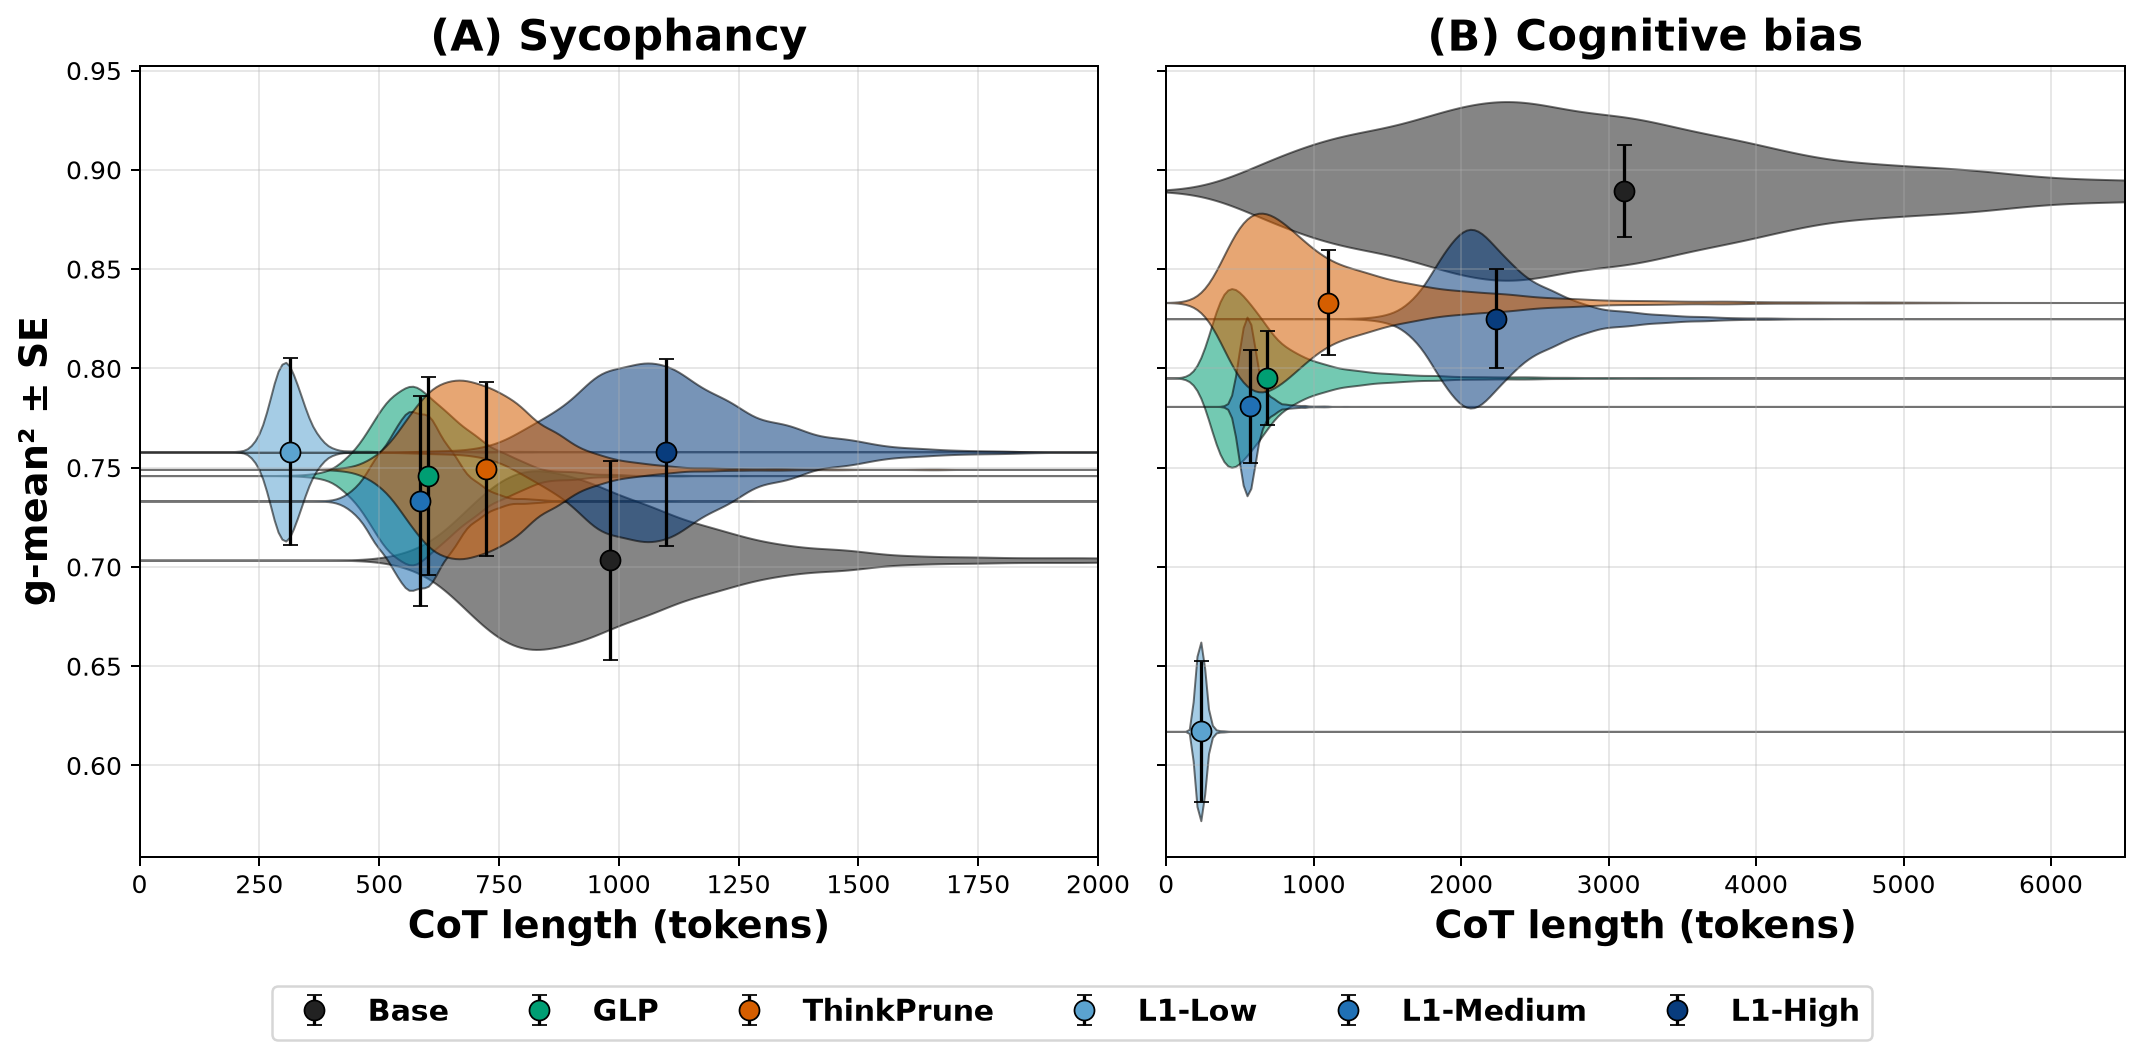
Figure 6 — Qwen3-4B의 모델별 Monitorability 결과
4. Conclusion & Impact (결론 및 시사점)
본 논문은 효율적인 추론 학습이 CoT의 모든 감독 기능을 무조건적으로 해치지는 않는다는 결론을 도출하였다. CoT가 의사결정의 특징을 파악하는 용도로 사용될 때는 효율화 학습이 Faithfulness를 저해할 수 있으나, 모델의 편향이나 외부 개입을 탐지하는 모니터링 용도라면 비교적 높은 성능을 유지할 수 있음을 입증하였다. 이 연구는 실무자가 모델 효율화를 선택할 때 CoT의 활용 목적에 따라 학습 전략을 다르게 설정해야 한다는 중요한 가이드라인을 제시한다. 결과적으로 본 연구는 고성능 LLM의 효율성과 투명성 사이의 균형을 유지하기 위한 체계적인 방법론을 제공함으로써 관련 AI 안전성 분야에 기여한다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Faithful GRPO: Improving Visual Spatial Reasoning in Multimodal Language Models via Constrained Policy Optimization
- [논문리뷰] MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models
- [논문리뷰] The Art of Efficient Reasoning: Data, Reward, and Optimization
- [논문리뷰] Open-o3-Video-v2: Seek, Ground, and Reason with Verifiable Spatio-Temporal Evidence
- [논문리뷰] SpatialASM: Internalizing Active Mentalization for Spatial Reasoning
Review 의 다른글
- 이전글 [논문리뷰] EditHero: A Benchmark for Long-Horizon Part-Level 3D Editing and Vibe Modeling
- 현재글 : [논문리뷰] Efficient Reasoning Training Does Not Always Harm CoT Faithfulness and Monitorability
- 다음글 [논문리뷰] FrameMorrow: Future-guided Frame Selection with Prospective Tokens for Long-Horizon Video Generation
댓글