[논문리뷰] FrameMorrow: Future-guided Frame Selection with Prospective Tokens for Long-Horizon Video Generation
링크: 논문 PDF로 바로 열기
저자: Bo Yin, Xiaobin Hu, Jiaqi Zhao, Shuicheng Yan, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Prospective Tokens: 미래의 정보 요구사항을 나타내는 소규모의 컴팩트한 표현으로, 생성되지 않은 미래 콘텐츠를 예측하는 대신 향후 생성에 필요한 정보를 미리 정의하고 선택하는 데 사용되는 토큰입니다.
- Future-Grounded Ranking Distillation: Frozen visual teacher를 사용하여 미래 정보와의 연관성을 바탕으로 historical frame의 중요도를 평가하고, 이를 prospective tokens의 학습에 반영하는 기법입니다.
- Plug-and-Play Integration: 제안하는 FrameMorrow가 특정 generator의 내부 상태를 수정하지 않고, 출력된 explicit historical frames를 기존 모델의 입력으로 그대로 활용하여 폭넓은 호환성을 제공하는 특징입니다.
- Long-Horizon Video Generation: 긴 생성 기간 동안 시간적 일관성(temporal consistency)을 유지하면서 subject, object, scene의 연속성을 보존해야 하는 영상 생성 작업입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Long-horizon video generation 과정에서 발생하는 누적된 역사적 정보의 비효율성과 일관성 저하 문제를 해결합니다. 기존 연구들은 주로 현재의 visual content를 기준으로 과거 정보를 선택(retrieval)했으나, 이는 미래 생성에 실질적으로 유용한 정보를 놓치거나 단순 시각적 유사성에만 의존한다는 한계가 있습니다. 저자들은 역설적으로 "현재 시점에서의 관련성보다 미래 생성에 대한 기여도가 훨씬 중요하다"는 점에 주목합니다. 이를 위해 미래 콘텐츠 전체를 생성하지 않고도 필요한 정보를 식별할 수 있는 프레임워크가 필요하며, 본 연구는 FrameMorrow를 통해 이 난제를 해결하고자 합니다 [Figure 1].
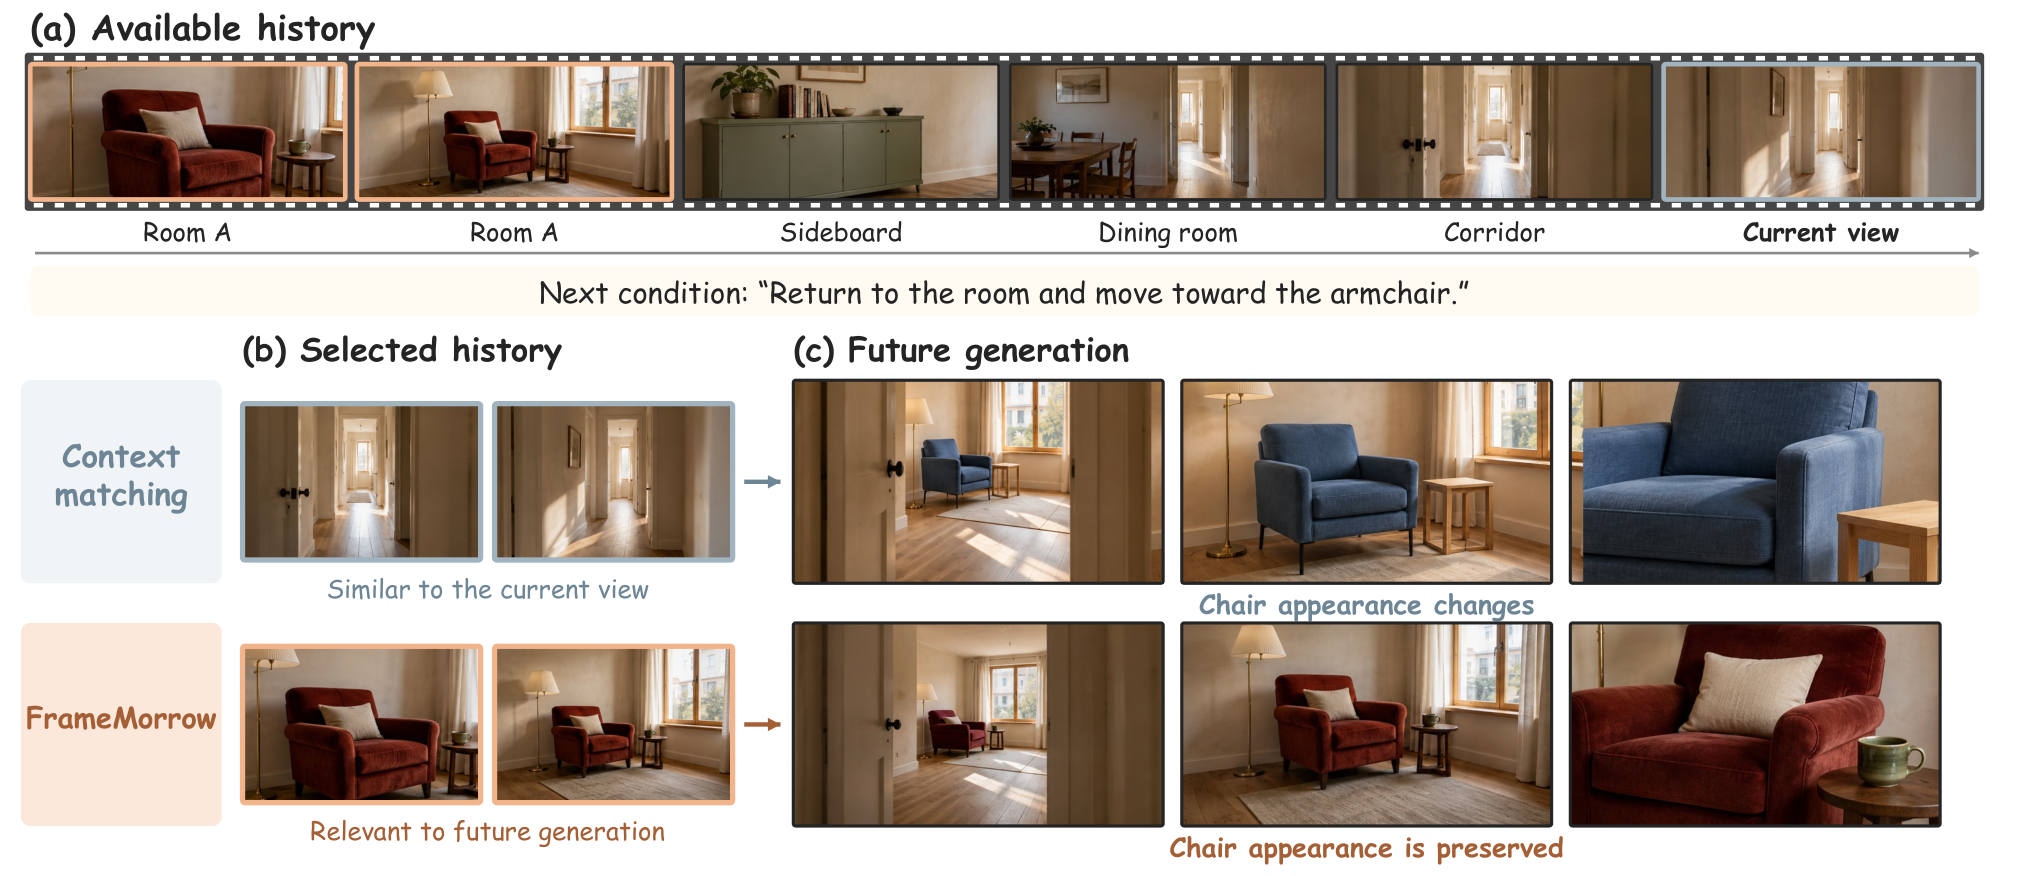
Figure 1 — 미래 관련성 기반 선택 동기
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Prospective Tokens를 활용하여 미래의 정보 요구사항을 예측하고 이를 바탕으로 관련 historical frame을 선택하는 FrameMorrow를 제안합니다. 제안 모델은 관측된 history, recent context, rollout condition을 입력받아 Prospective Tokens를 autoregressively 예측하며, 이를 통해 historical frame의 중요도를 scoring하여 Top-K 프레임을 선택합니다 [Figure 2]. 학습 시에는 frozen DINOv2 모델을 teacher로 활용하여 미래 콘텐츠와의 시각적 대응(correspondence)을 학습하는 Future-Grounded Ranking Distillation 방식을 도입했습니다. 실험 결과, FrameMorrow는 11개의 다양한 생성 모델(Self-Forcing, LongLive 1.0, Causal Forcing 등)에서 일관되게 성능을 향상했습니다 [Table 1]. 특히, 60초 길이의 생성 실험에서 Self-Forcing 베이스라인의 Imaging quality를 62.22에서 68.47로, Dynamic degree를 51.72에서 64.56으로 크게 개선했습니다 [Table 1]. 또한, closed-source 모델인 Seedance 2.0 및 Kling O3에서도 Consistency 지표를 각각 1.29 및 1.33 포인트 상승시키는 뛰어난 범용성을 입증했습니다 [Table 3].
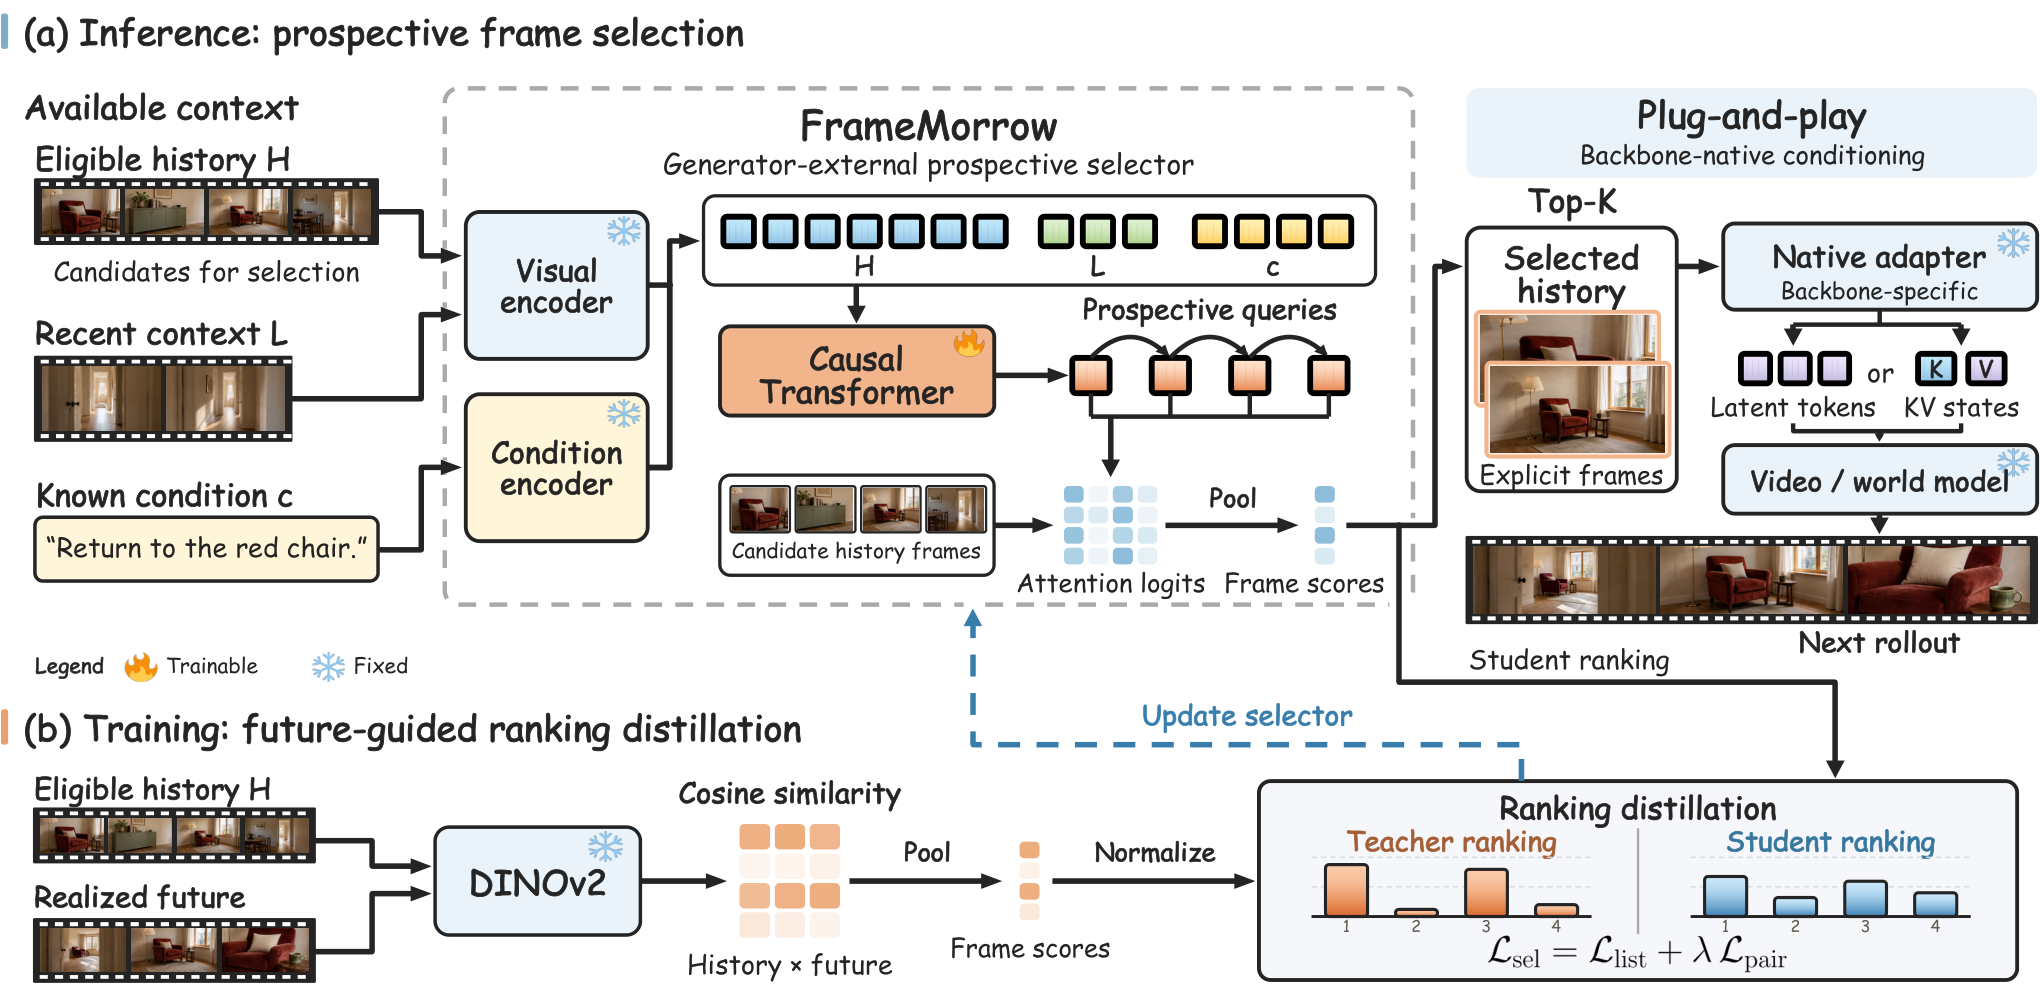
Figure 2 — FrameMorrow 전체 구조
4. Conclusion & Impact (결론 및 시사점)
본 논문은 미래 예측 기반의 프레임 선택이라는 새로운 패러다임을 통해 Long-horizon video generation의 핵심인 시간적 일관성과 정보의 효율성을 성공적으로 확보했습니다. FrameMorrow의 Plug-and-Play 특성은 폐쇄형 모델을 포함한 다양한 기존 생성기들에 쉽게 적용될 수 있다는 점에서 학계 및 산업계의 실용적 가치가 매우 큽니다. 본 연구는 향후 비디오 생성 모델이 메모리를 관리하고 과거 정보를 활용하는 방식에 있어 중요한 전환점을 마련할 것으로 기대됩니다.
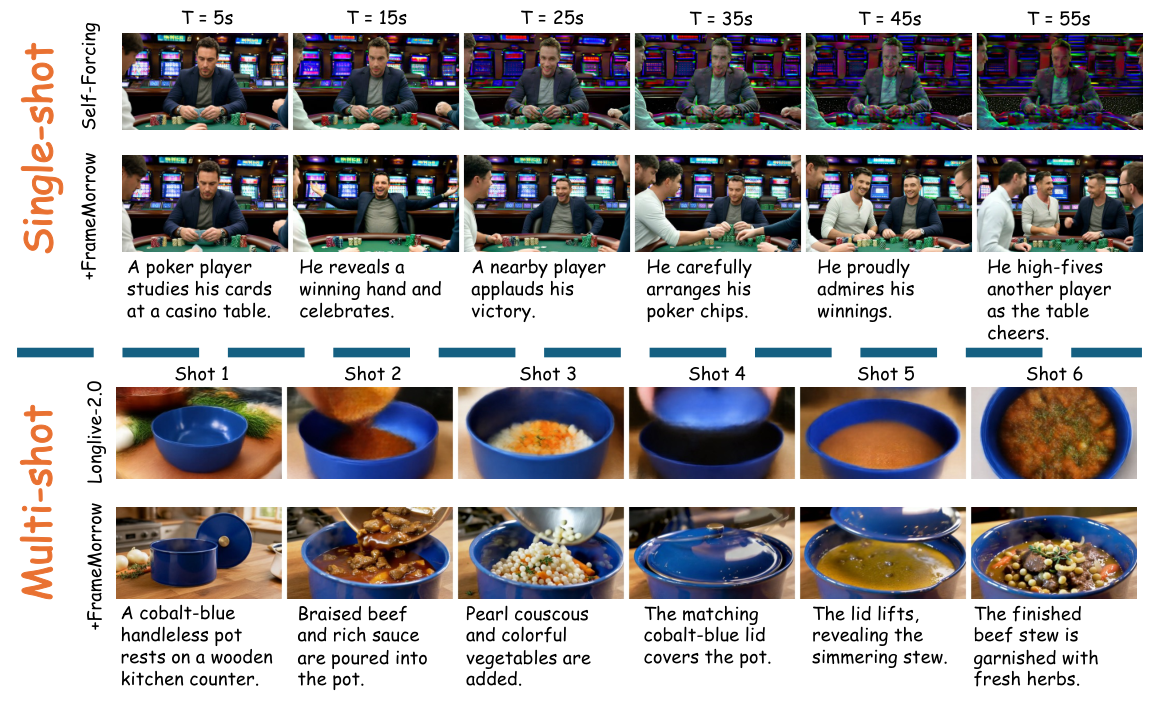
Figure 3 — 상호작용 비디오 생성 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RAR: Rate-Adaptive Rollout for Time-Consistent Interactive World Models
- [논문리뷰] Tetris3D: 3D Scene Generation With Objects That Fit Together
- [논문리뷰] LongLive-Plug: Once-for-All Distillation for Video Generation
- [논문리뷰] Select, Compress, Reinvest: A Controlled Study of Visual-Token Allocation in Long-Video MLLMs
- [논문리뷰] Magpie: Real-Time World Renderer for Interactive Games
Review 의 다른글
- 이전글 [논문리뷰] Efficient Reasoning Training Does Not Always Harm CoT Faithfulness and Monitorability
- 현재글 : [논문리뷰] FrameMorrow: Future-guided Frame Selection with Prospective Tokens for Long-Horizon Video Generation
- 다음글 [논문리뷰] From Gradients to Capabilities: Understanding Multi-Teacher On-Policy Distillation
댓글