[논문리뷰] Local Support Learning
링크: 논문 PDF로 바로 열기
저자: Assaf Ben-Kish, Akarsh Kumar, James Glass, Raja Giryes
1. Key Terms & Definitions (핵심 용어 및 정의)
- Catastrophic Forgetting: 대규모 사전 훈련된 모델이 새로운 데이터에 적응할 때 이전에 학습된 능력을 잊어버리는 현상입니다.
- Local Support Learning (LSL): 기존 gradient-based training에 gating function을 추가하여 이전 데이터에 대한 접근 없이도 모델의 이전 기능을 유지하도록 하는 general-purpose 프레임워크입니다.
- Weight Adapter: 대규모 모델의 전체 파라미터를 업데이트하는 대신, 작은 저랭크(low-rank) 행렬을 추가하여 효율적으로 fine-tuning을 수행하는 기법입니다. 논문에서는 LoRA(Low-Rank Adapters)와 같은 개념으로 사용됩니다.
- Gating Function: 특정 input activation이 현재 학습 분포 내에 있는지 여부를 판단하여 weight adapter의 활성화 여부를 제어하는 함수입니다. LSL에서는 Gaussian Mixture Model (GMM) 기반으로 구현됩니다.
- Gaussian Mixture Model (GMM): 여러 가우시안 분포의 혼합으로 데이터 분포를 모델링하는 통계 모델이며, LSL에서는 input activation의 support를 추정하는 데 사용됩니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Large Pre-trained Models의 post-training 과정에서 발생하는 Catastrophic Forgetting 문제를 해결하기 위해 Local Support Learning (LSL) 프레임워크를 제안합니다. 기존 딥러닝 패러다임은 대규모 데이터셋으로 사전 훈련된 신경망을 fine-tuning하여 특정 Task에 적응시키지만, 이 과정에서 모델이 이전에 학습한 기능을 잊어버리는 경향이 있습니다. 이러한 forgetting은 다단계 학습(multi-phase learning)을 방해하며, 사전 훈련 및 이전 fine-tuning 단계에서 습득한 능력이 덮어쓰여지는(overwritten) 문제가 발생합니다.
기존 완화 접근 방식들은 이전 데이터 샘플의 버퍼를 사용하거나, 데이터에 의존하는 정규화를 적용하거나, 최적화 제약을 부과하는 방식들이 있었지만, 이는 대규모 사전 훈련 설정에서 확장성이 떨어져 비실용적입니다. 특히, gradient-based optimizer에 의해 생성된 업데이트가 해당 학습에 필요한 input region, 즉 현재 phase 분포의 support 외부에서도 작동하여 이전에 학습된 input-output mapping을 변경시키는 것이 문제의 핵심입니다. 저자들은 이러한 한계를 극복하기 위해, 이전 데이터에 대한 접근 없이도 이전 능력을 유지할 수 있는 새로운 접근 방식이 필요하다고 주장합니다. Figure 2는 Catastrophic Forgetting이 발생하는 toy example을 통해, 모델이 새로운 Task에 적응하면서 기존 Task에 대한 decision boundary가 심하게 왜곡되는 것을 명확히 보여줍니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 catastrophic forgetting 문제를 해결하기 위해 Local Support Learning (LSL) 프레임워크를 제안합니다. LSL은 기존의 weight adapter에 Gating Function을 결합하여, adapter가 오직 현재 training distribution의 input activation에 대해서만 활성화되도록 합니다. 이 gating function은 Gaussian Mixture Model (GMM)을 기반으로 하며, GMM의 likelihood가 training data에서 멀어질수록 빠르게 감소하는 특성을 활용하여 이전 phase의 데이터에 대해서는 gate가 닫힌 상태를 유지하도록 유도합니다. Figure 1은 LSL이 catastrophic forgetting을 방지하는 메커니즘을 시각적으로 설명하며, GMM-based gate가 새로운 fine-tuning 데이터의 분포를 포착하고, 그 외부 데이터는 pretrained weight로만 라우팅되도록 합니다.
LSL의 전체 training algorithm은 Algorithm 1에, inference algorithm은 Algorithm 2에 상세히 기술되어 있습니다. 핵심적으로, Φneg GMM은 일반적인 pre-training 데이터의 작은 샘플에 대해 한 번 fit되며, Φpos GMM은 각 fine-tuning phase에서 해당 phase의 데이터에 대해 fit됩니다. GMM은 각 weight matrix에 개별적으로 적용되며, 이는 context-dependent feature를 기반으로 한 라우팅 결정을 가능하게 하여 단일 gate 방식보다 우수한 성능을 보입니다. 또한, GMM gate의 독립적인 토큰 처리 방식의 한계를 보완하기 위해 exponential moving average를 이용한 Temporal Smoothing 기법이 적용됩니다.
실험 결과, LSL은 Qwen2.5-7B-Instruct 모델을 사용하여 세 가지 다양한 downstream Task (cybersecurity instruction tuning, low-resource translation, chemistry instruction tuning)에서 평가되었습니다. Figure 4에서 LSL은 모든 설정에서 새로운 Task에 대한 강력한 성능을 달성하는 동시에, GSM8K (math reasoning), HumanEval (code generation), IFEval (instruction following)과 같은 pre-training 벤치마크에서 거의 최적의 retention을 유지했습니다. 반면, LoRA 및 OP-LoRA와 같은 baseline들은 새로운 Task에 대한 적응력은 높지만, 모든 설정에서 심각한 forgetting을 겪었습니다. Learning without Forgetting (LwF)도 LSL에 비해 retention 성능이 떨어졌습니다.
다중 post-training phase 실험 (Figure 5)에서는 LSL이 모든 phase에 걸쳐 pretrained capabilities를 유지하는 반면, baseline은 첫 번째 phase 이후에도 성능이 크게 저하되었습니다. LSL은 또한 fine-tuning Task 간의 간섭을 피하여 각 Task 학습 후에도 성능을 보존했습니다. LSL은 learning rate, adapter rank, batch size와 같은 hyperparameters에 대해 견고한(robust) 성능을 보였으며, 기존 fine-tuning 방식에서 발생하는 learning-forgetting trade-off를 해결했습니다 (Figure 6). 모델 scaling experiment (Figure 7)에서는 LSL이 1.5B에서 7B까지 모든 모델 크기에서 작동하며, 모델 규모가 커질수록 retention 성능이 향상되는 경향을 보였습니다. 효율성 측면에서, LSL은 GMM에 대해 13.8MB의 추가 메모리만 필요하며, inference latency와 training time은 기존 LoRA baseline과 비슷한 수준을 유지했습니다 (Figure 8). Ablation 연구를 통해, retention gains가 GMM 자체보다는 update의 local support 특성에서 비롯됨을 확인했습니다 (Figure 9).
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Large Pre-trained Models에서 발생하는 Catastrophic Forgetting 문제를 각 weight matrix의 input space geometry를 통해 분석하며, 업데이트가 오직 해당 training distribution의 activation에만 제한되어야 한다는 자연스러운 retention objective를 도출했습니다. 이 분석을 바탕으로, 저자들은 표준 adapter와 특화된 Gaussian Mixture Model (GMM)에 의해 fit되는 gating function을 결합한 Local Support Learning (LSL) 프레임워크를 제안합니다. LSL의 gating function은 local support를 통해 모든 phase의 input을 라우팅하면서도 현재 phase 데이터로만 훈련될 수 있도록 하여, 이전 phase의 간섭을 효과적으로 방지합니다.
LSL은 최대 70억 개 파라미터의 LLM에 대한 평가에서, pretrained capabilities 및 이전에 fine-tuning된 기술들을 여러 sequential phase에 걸쳐 온전히 유지하면서도 full capacity로 학습이 가능함을 입증했습니다. 이 연구는 hyperparameter 선택에 대한 견고성(robustness), training token 수에 독립적인 작은 memory footprint, 그리고 promising scaling behavior를 보여줍니다. LSL은 LLM을 실제 시스템에 배포할 때 핵심적인 문제인 catastrophic forgetting을 해결하여 모델 효율성을 높이고 에너지 소비를 줄이는 긍정적인 영향을 미칠 것으로 기대됩니다. 향후 연구는 LSL을 더 큰 모델, 다른 modality, reinforcement learning objective, 그리고 수백 개의 phase로 확장하는 것을 포함하여, test-time training과 같은 새로운 학습 패러다임을 가능하게 할 잠재력을 가지고 있습니다.
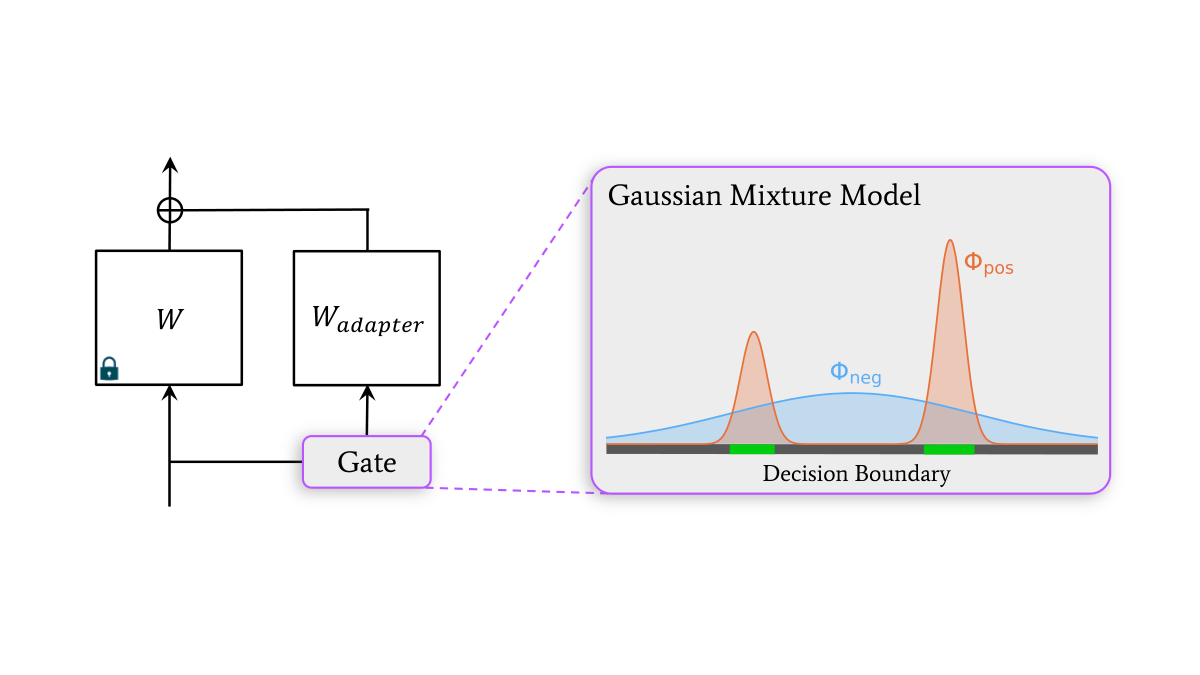
Figure 1 — Catastrophic Forgetting 방지
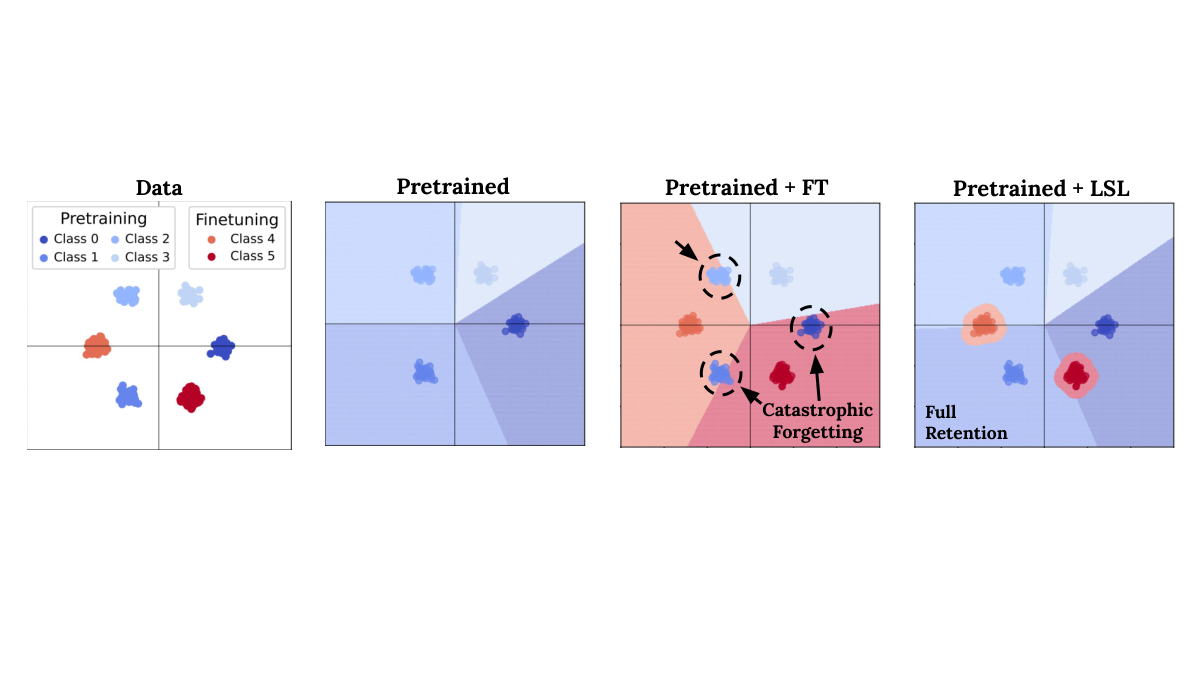
Figure 2 — Catastrophic forgetting 토이 예시
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Self-Preservation in Language Models
- [논문리뷰] PaLoRA: Paced Low-Rank Adaptation for Continual Learning
- [논문리뷰] Continual Learning Mechanisms Compose for Long-Horizon Memorization
- [논문리뷰] Continual Learning in Transition
- [논문리뷰] Language Models Need Sleep: Learning to Self-Modify and Consolidate Memories
Review 의 다른글
- 이전글 [논문리뷰] LexReward: A Taxonomy-Driven Reward Framework for Legal Language Models
- 현재글 : [논문리뷰] Local Support Learning
- 다음글 [논문리뷰] Looping Beyond Twice: A Scalable Recipe for Looped Mixture-of-Experts
댓글