[논문리뷰] LexReward: A Taxonomy-Driven Reward Framework for Legal Language Models
링크: 논문 PDF로 바로 열기
저자: Yida Cai, Xin Dai, et al.
1. Key Terms & Definitions
- LexReward: Legal language models를 위한 taxonomy-driven reward framework로, Style, Element, Chain의 세 가지 complementary dimension을 통해 legal response quality를 fine-grained하게 특성화한다.
- LexRM: LexReward framework 내에서 rubric-derived preference data를 기반으로 학습된 중국어 legal reward models의 family이다.
- Direct Preference Optimization (DPO): Preference data를 활용하여 reward model 없이 policy를 직접 최적화하는 reinforcement learning 기법이다.
- Group Relative Policy Optimization (GRPO): 학습된 reward models를 통해 policy를 최적화하는 reinforcement learning pipeline을 의미한다.
- Taxonomy: Legal response quality를 Style, Element, Chain 세 가지 핵심 dimension으로 구조화하고, 각각을 fine-grained criteria로 세분화하여 평가하는 정의 체계이다.
2. Motivation & Problem Statement
Legal large language models (LLMs)는 legal question answering 및 legal reasoning과 같은 다양한 legal generation tasks에서 상당한 잠재력을 보여주었으나, 단순히 올바른 최종 답변을 제공하는 것 이상의 고품질 legal response를 생성하는 데는 한계가 있다. 기존의 reward methods는 종종 coarse-grained holistic judgment에 의존하여 제한적인 domain specificity와 interpretability를 제공하며, legal response quality의 다차원적인 측면을 충분히 포착하지 못한다. 이러한 한계로 인해 model은 불완전한 reasoning, legally decisive facts의 누락, 부적절한 statutory basis 인용, 또는 유창하지만 legal하게 신뢰할 수 없는 설명을 생성할 수 있다. 결과적으로, legal response quality를 구조화된 방식으로 정의하고 이를 model optimization에 효과적으로 활용할 수 있는 포괄적인 reward framework의 필요성이 대두된다.
3. Method & Key Results
본 논문은 legal response quality를 세 가지 complementary dimension인 Style, Element, Chain으로 분해하는 LexReward라는 taxonomy-driven reward framework를 제안한다 [Figure 1], [Figure 2]. Style은 lexical 및 syntactic quality를, Element는 legal subjects, facts, statutes, decisions의 식별 및 처리를, Chain은 legal reasoning의 order, completeness, correctness, non-redundancy를 평가한다. 각 dimension에 대해 rule-based 또는 LLM-as-a-judge evaluators를 사용하여 평가 기준과 quality level을 지정하는 rubrics를 개발한다. 이 rubric-based rewards를 사용하여 preference data를 구축하고, 이를 기반으로 LexRM이라는 reward models family를 학습시킨다.
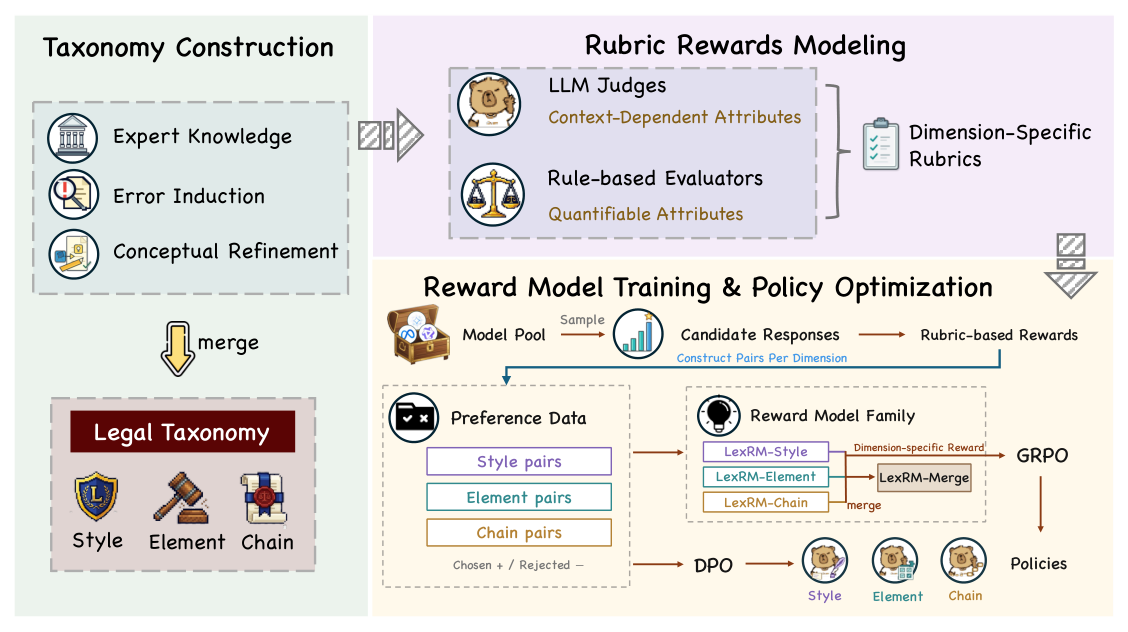
Figure 1 — LexReward framework의 전체적인 구조와 프로세스를 시각적으로 보여주는 핵심 다이어그램
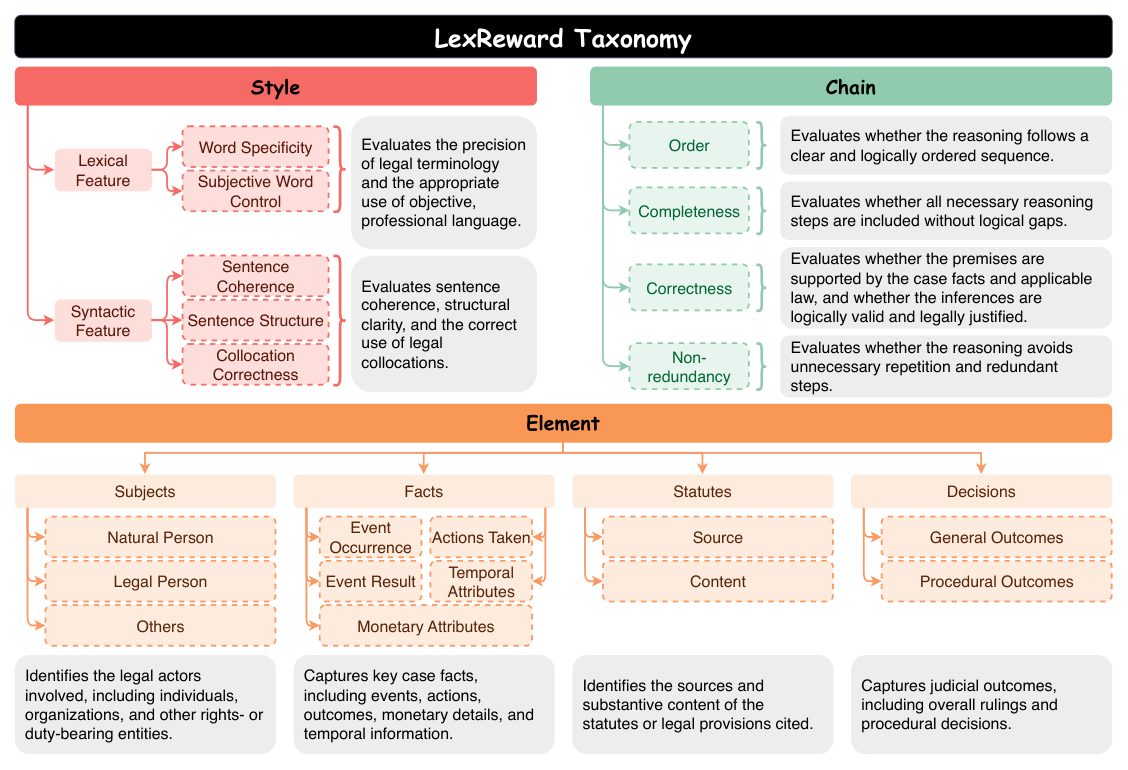
Figure 2 — LexReward taxonomy의 세 가지 핵심 dimension과 그 하위 기준들을 시각적으로 상세히 정의한 다이어그램
실험 결과는 LexReward가 legal response quality를 안정적으로 구별하며, 이를 통해 model 성능을 성공적으로 향상시킴을 입증했다.
- Rubric 및 Reward Model 평가: Table 1에 나타난 바와 같이, rubric-based rewards(Rubric)는 five-model average 또는 random selection보다 우수한 response를 선택하는 능력을 보여주었다. 특히, LexRM-Style과 LexRM-Chain은 해당 dataset에서 가장 좋은 overall 결과를 달성했으며, LexRM-Element는 두 번째를 기록했다. 이는 reward models가 rubrics의 기준을 continuous scoring functions으로 효과적으로 내재화했음을 시사한다.
- DPO 및 RL 평가: Table 2에서, DPO는 모든 세 dimension에서 vanilla model보다 성능을 개선하여, rubric-derived preference data가 policy optimization에 유용한 reward 정보를 제공함을 확인했다. 더욱이, GRPO (RM)은 모든 dimension에서 가장 높은 점수를 달성했으며, 특히 Element dimension에서는 SFT 대비 6.04 points의 가장 큰 성능 향상을 기록했다. 이는 LexRM이 supervised fine-tuning을 넘어 legal generation 품질을 개선하기 위한 효과적인 supervision을 제공함을 보여준다.
4. Conclusion & Impact
본 연구는 legal language models의 reward modeling을 위한 taxonomy-driven framework인 LexReward를 도입하며, 이는 legal response quality를 Style, Element, Chain의 세 가지 핵심 dimension으로 구조화한다. LexReward는 fine-grained scoring rubrics를 통해 다양한 quality의 legal response를 효과적으로 구별하며, 이러한 rubrics에서 파생된 preference data는 DPO를 통한 legal response generation 개선 및 LexRM이라는 중국어 legal reward models family 학습에 활용된다. LexRM은 multi-model response selection을 향상시키고, Style, Element, Chain 각 dimension에 대해 policy를 개별적으로 최적화하는 데 효과적인 reinforcement-learning rewards를 제공한다. 이러한 결과는 taxonomy-driven rewards가 legal language models의 품질을 향상시키는 효과적인 supervision임을 확립하며, legal domain knowledge를 reward construction 및 model optimization에 통합하는 중요한 방향을 제시한다.
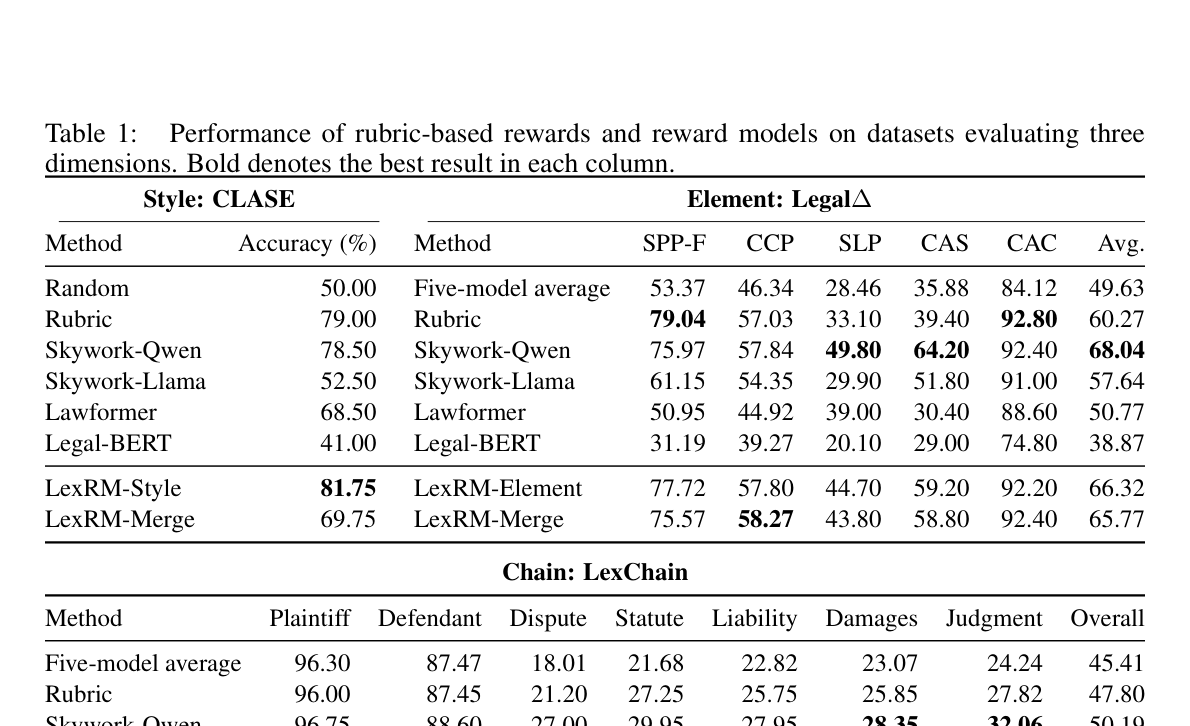
Table 1 — Style, Element, Chain 각 dimension에서 rubric-based rewards 및 LexRM의 정량적 성능 비교를 보여주는 주요 결과 테이블
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RUBRIC-ARROW: Alternating Pointwise Rubric Reward Modeling for LLM Post-training in Non-verifiable Domains
- [논문리뷰] OPD Before RL: Warm-Starting Rubric-Based RL with On-Policy Distillation
- [논문리뷰] WorldReward: Reward Modeling for Camera-Conditioned World Models
- [논문리뷰] Are Android GUI Agents Robust Against Runtime Anomalies? AnTrap: Evaluating Agents in Dynamic Adversarial Environments
- [논문리뷰] Skill-RM: Unifying Heterogeneous Evaluation Criteria via Agent Skill
Review 의 다른글
- 이전글 [논문리뷰] Learning from Runtime Feedback through Failure-Bank Self-Evolution for Vision-Language-Action Models
- 현재글 : [논문리뷰] LexReward: A Taxonomy-Driven Reward Framework for Legal Language Models
- 다음글 [논문리뷰] Local Support Learning
댓글