[논문리뷰] Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Generation Model Training
링크: 논문 PDF로 바로 열기
메타데이터
저자: Shuyuan Tu, Qi Tian, Yinming Huang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Native 2K Training: 저해상도에서 생성 후 업스케일링(SR)하는 기존 방식과 달리, 2K 해상도에서 직접적으로 모델을 학습시켜 고해상도 시각적 디테일과 모션 역동성을 확보하는 기법.
- Dynamic Block Shape: 3D 토큰 시퀀스를 Spatiotemporal macro-zones로 분할하고, 각 구역의 시각적 변화도와 오디오-비디오 상호작용 강도에 따라 블록 형태(Edge lengths)를 유동적으로 조정하는 방식.
- Hybrid Top-kk/Top-pp Selection: 고정된 sparsity 대신, 최소 Coverage를 보장하는 Top-kk와 정보 밀도에 따라 동적으로 확장되는 Top-pp를 결합하여 연산 효율과 품질을 동시에 최적화하는 전략.
- Full Attention: 시퀀스 전체 토큰 간의 관계를 계산하는 방식. 2K 해상도에서 quadratic cost로 인해 과도한 중복 토큰(Redundant tokens)이 생성되어 학습 신호가 희석되는 문제점 유발.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 Native 2K 해상도에서의 공동 비디오-오디오 생성(Joint video-audio generation) 학습 시 발생하는 연산 효율성 및 학습 신호 희석 문제를 해결하기 위해 제안되었다. 기존 모델들은 2K 학습 시 quadratic cost로 인해 Full Attention 사용이 제한되거나, 저해상도 생성 후 업스케일링을 거쳐 고해상도 디테일 학습에 한계를 보인다 [Figure 1]. 또한, 기존의 sparse attention 방식들은 고정된 블록 형태를 사용하거나 오디오-비디오 간의 특수한 상호작용 구조를 고려하지 않아 고해상도 데이터의 효율적인 학습이 어렵다. 따라서 시각적 변화와 오디오 영향을 동적으로 반영하는 새로운 sparse attention 프레임워크가 필수적이다.
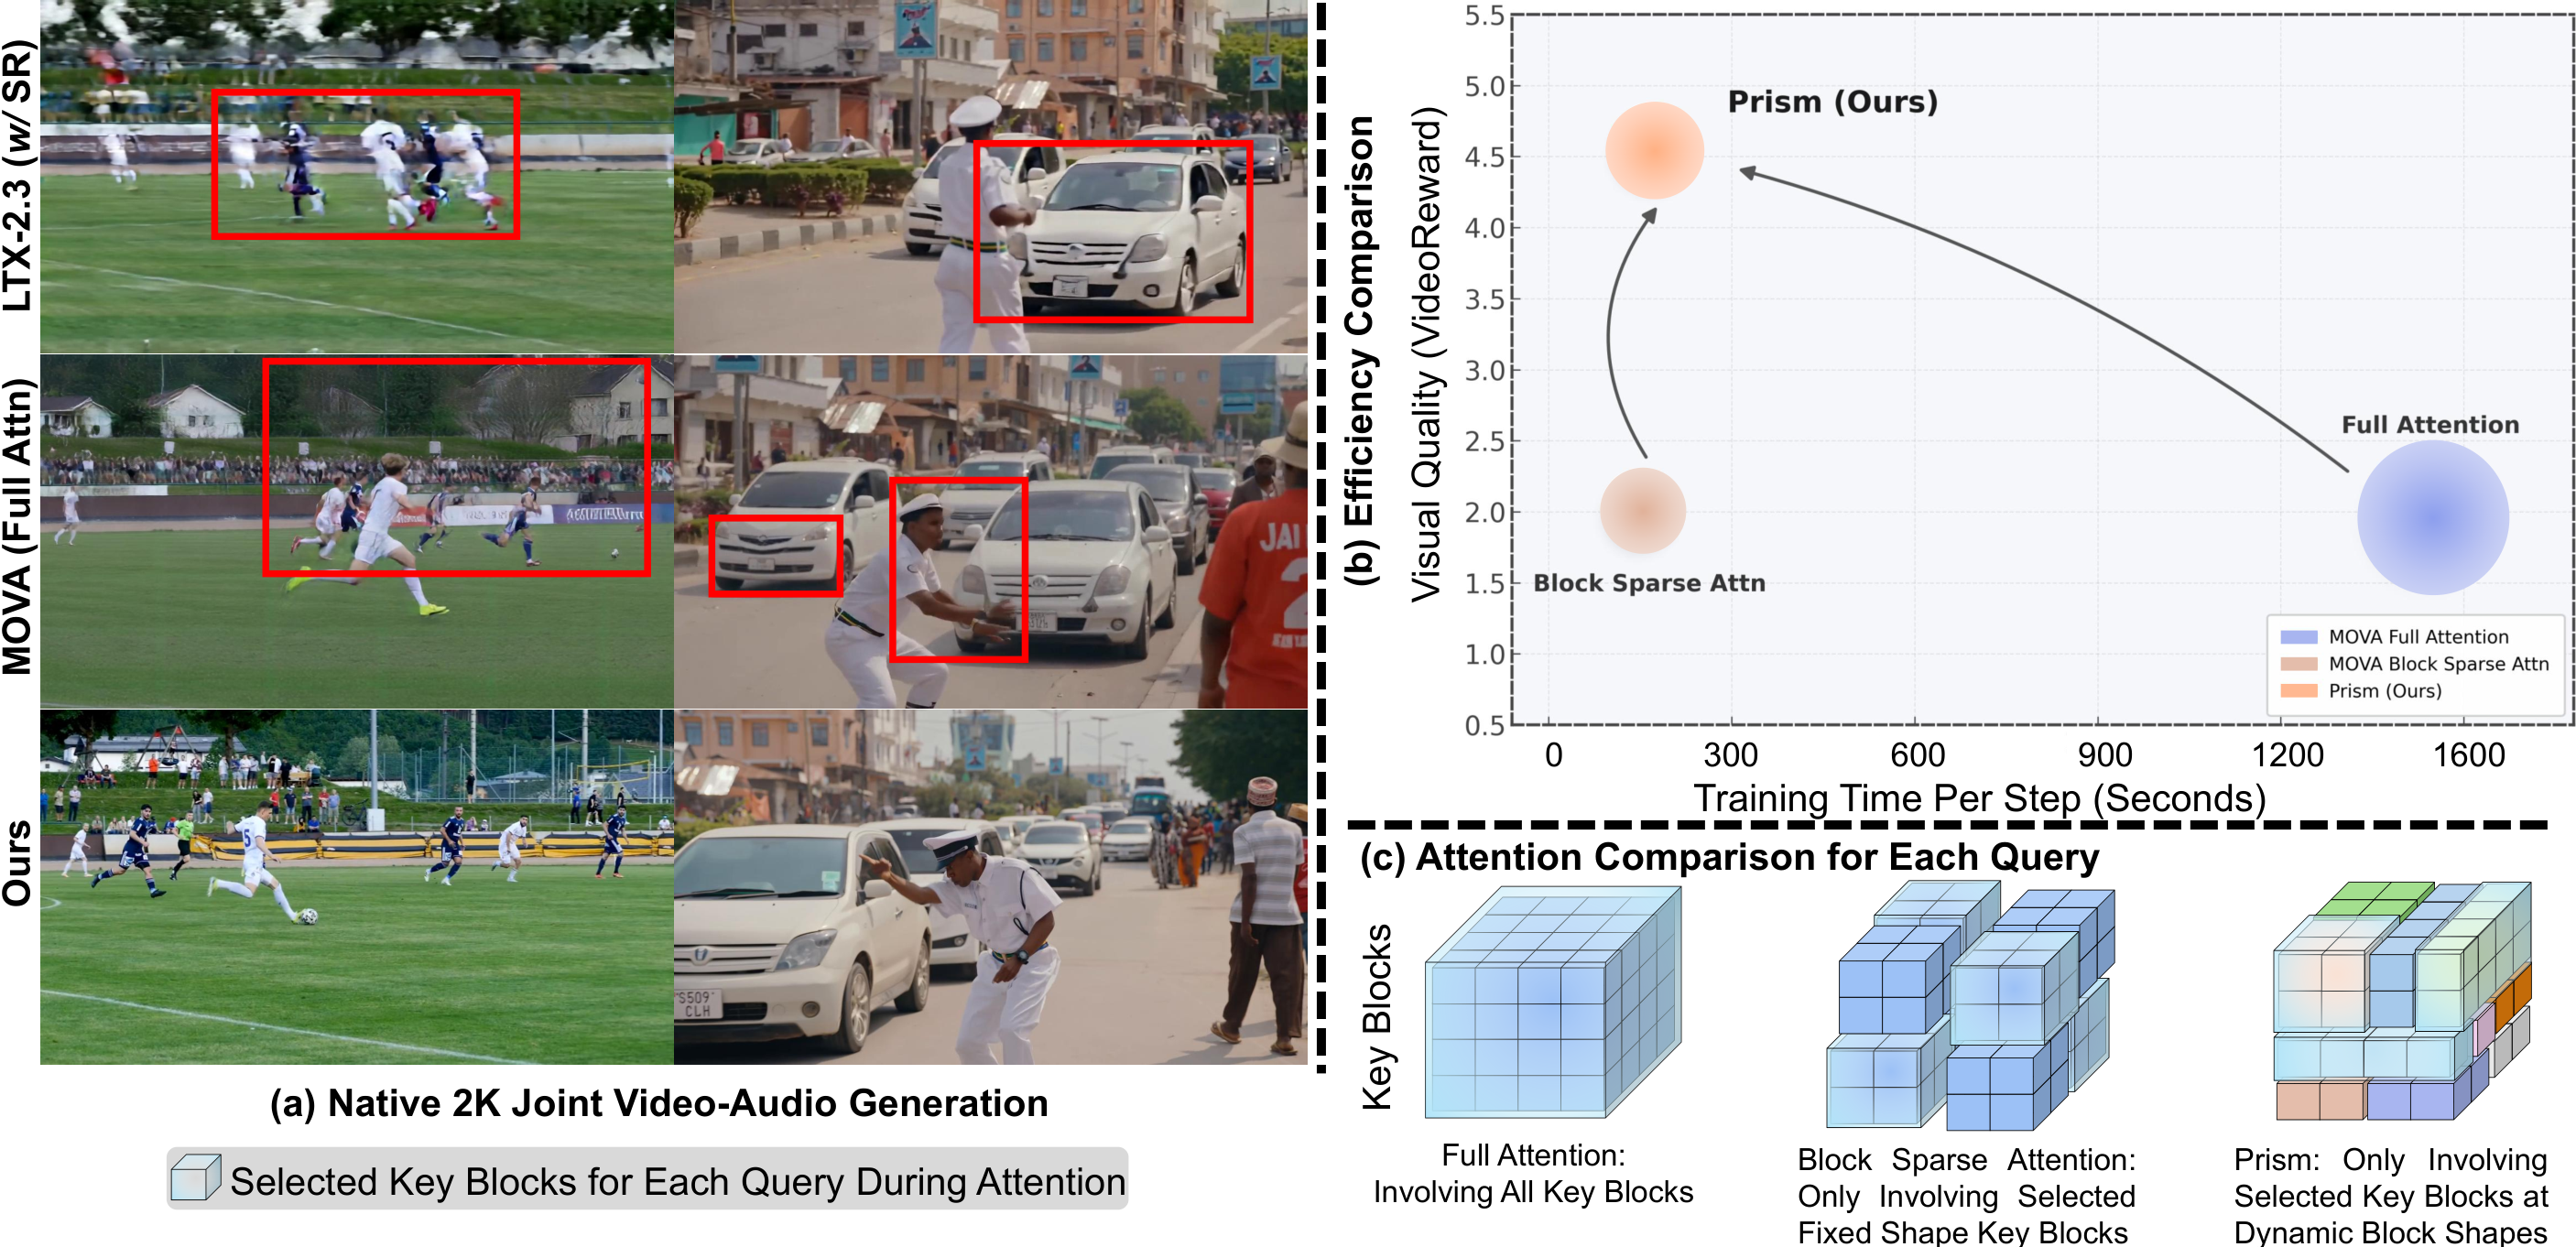
Figure 1 — Prism의 생성 예시와 학습 효율
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Prism이라 명명된 dynamic sparse attention 프레임워크를 제안하여 Native 2K 학습을 가능하게 한다 [Figure 2]. 저자들은 토큰을 spatiotemporal macro-zones로 나누고, video channel-wise variance와 audio-to-video cross-attention norm을 결합하여 각 구역의 정보 구조를 평가한다. 이를 통해 블록 내부의 정보 손실을 최소화하도록 각 구역에 맞춤형 3D 블록 형태를 동적으로 할당한다 [Figure 2]. 또한, Hybrid Top-kk/Top-pp block selection을 통해 쿼리별로 적응적인 sparsity를 적용함으로써 연산량을 효율적으로 분배한다. 실험 결과, Prism은 Full Attention 대비 **2.5×**의 학습 속도 향상을 달성하였다 [Figure 1]. 2K-Bench 평가에서 AQ(Audio Quality) 및 MotionQ 등 주요 지표에서 기존 SOTA 모델인 MOVA, LTX-2.3 등을 큰 폭으로 능가하며 우수한 생성 품질을 입증하였다 [Table 1]. 특히 시각적 일관성과 오디오-비디오 동기화 측면에서 압도적인 성능 우위를 보였다 [Figure 3].
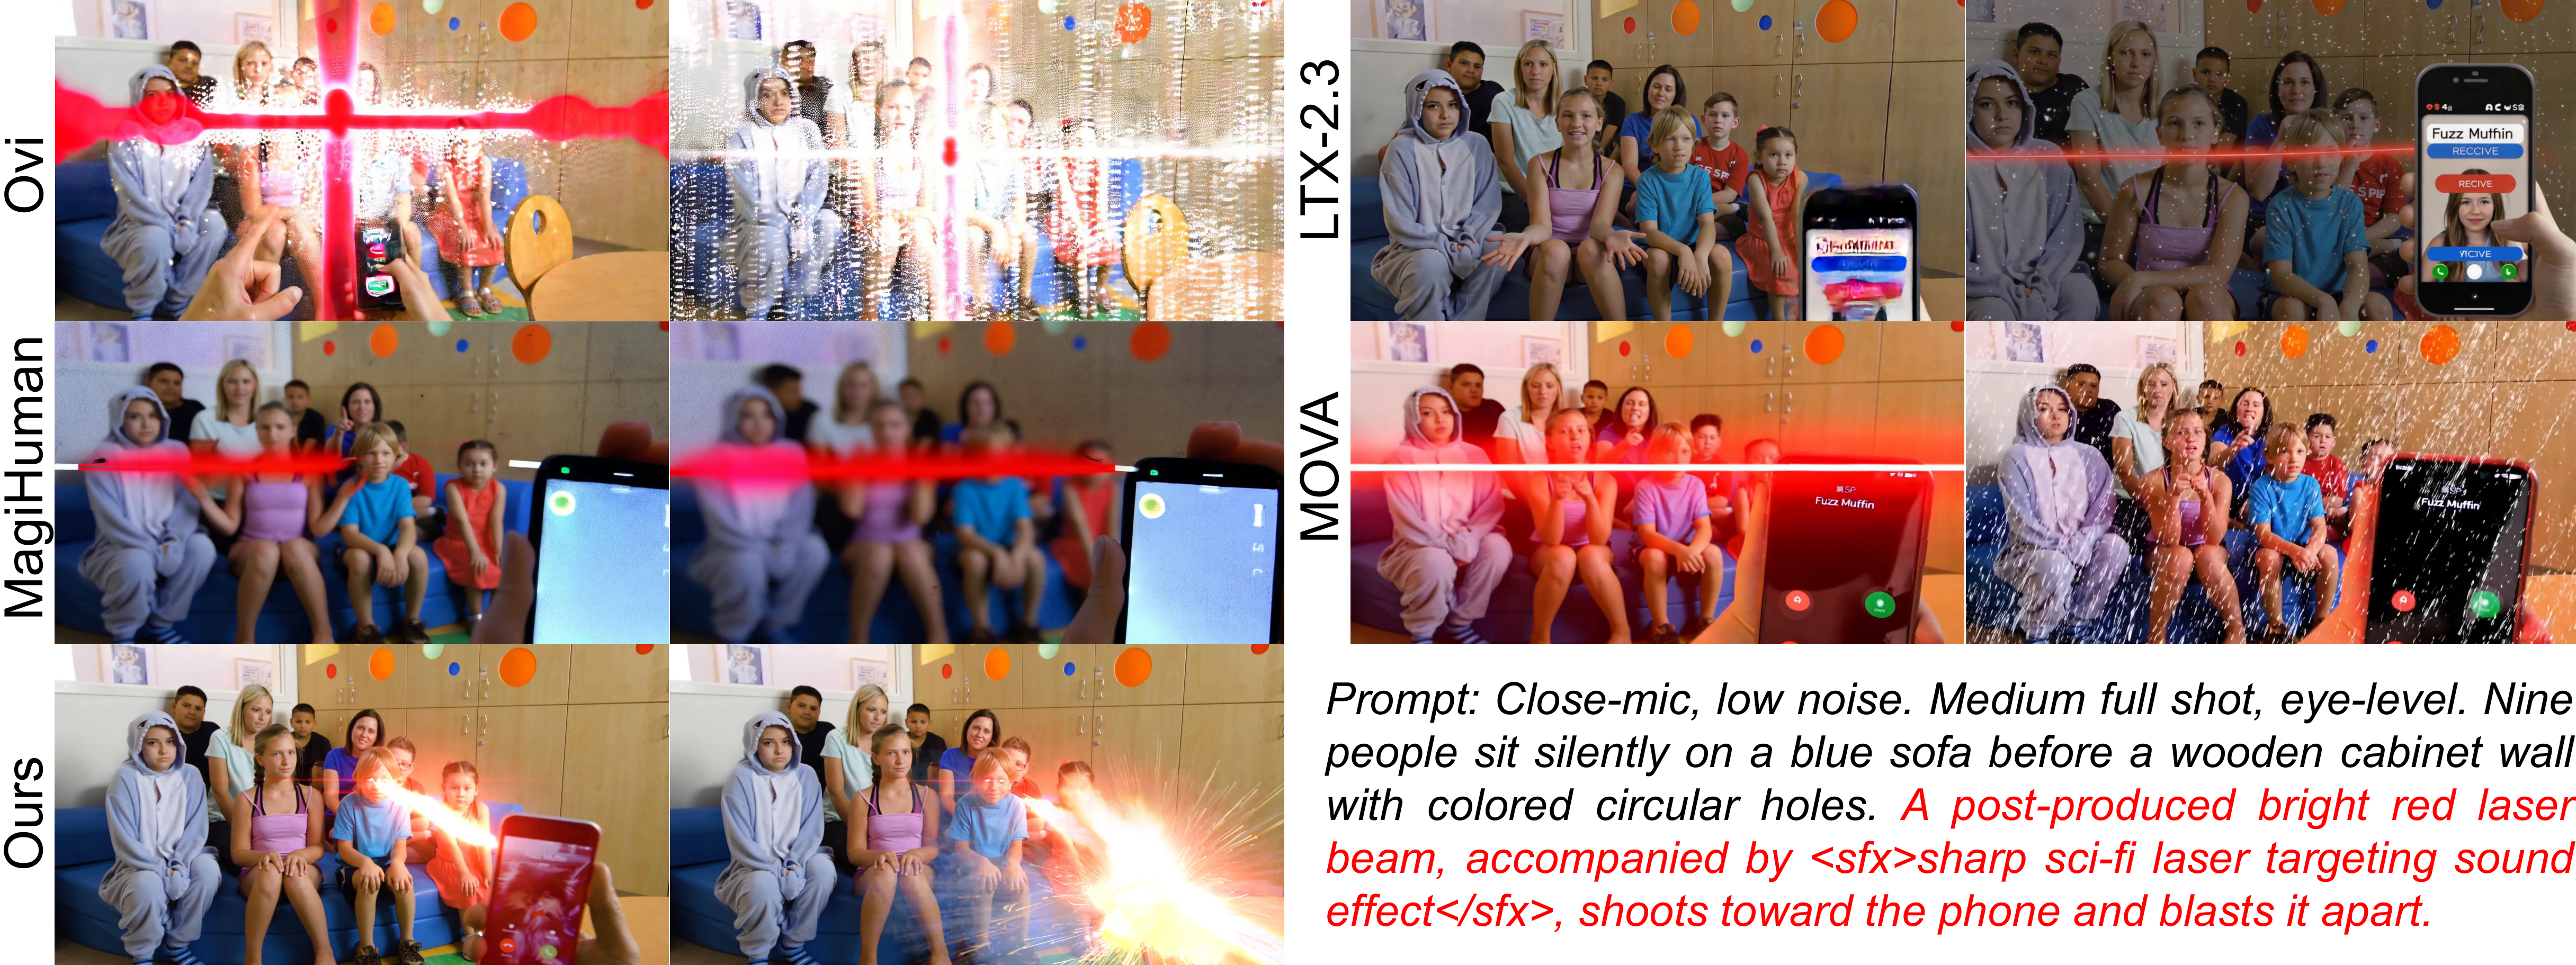
Figure 3 — 기존 모델과의 정성적 비교
4. Conclusion & Impact (결론 및 시사점)
Prism은 오디오-비디오 데이터의 구조적 특성을 활용한 동적 블록 Sparse Attention 기법을 통해 Native 2K 공동 생성 모델의 효과적인 학습을 최초로 구현하였다. 이 연구는 기존 고해상도 생성 모델들이 겪던 연산 과부하와 학습 품질 저하 문제를 근본적으로 개선했다는 점에서 학술적 가치가 크다. 본 프레임워크는 고해상도 멀티모달 생성 모델의 효율적인 확장(Scaling)을 위한 새로운 표준을 제시하며, 향후 고화질 비디오-오디오 콘텐츠 생성 분야의 연구 개발을 가속화할 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] From Prompting to Composing: A Spatial Canvas Interface for Poster Generation
- [논문리뷰] GRACE: Generation-aware latent compression for efficient video generation
- [논문리뷰] PixelDense: Dense Prediction as Representation Alignment for Pixel Diffusion
- [논문리뷰] Diffusion Reward Models
- [논문리뷰] UltraTex: Unleashing 2K Multi-View Diffusion for 3D Texturing
Review 의 다른글
- 이전글 [논문리뷰] PluginRSI: Recursive Improvement of Agent Harnesses with Reusable Plugins
- 현재글 : [논문리뷰] Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Generation Model Training
- 다음글 [논문리뷰] ProgressCompass: Embodied Progress Reward Models Are Lost Without the Right Context
댓글