[논문리뷰] TextReg: Mitigating Prompt Distributional Overfitting via Regularized Text-Space Optimization
링크: 논문 PDF로 바로 열기
저자: Lucheng Fu, Ye Yu, Yiyang Wang, Yiqiao Jin, Haibo Jin, B. Aditya Prakash, Haohan Wang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Prompt Distributional Overfitting: 프롬프트 최적화 과정에서 프롬프트가 학습 데이터에 과도하게 적응하여, 타겟 분포(OOD)에서 성능이 저하되는 현상을 의미합니다.
- Representational Inefficiency: 프롬프트의 품질을 결정하는 두 가지 요소인 Capacity Cost(프롬프트 길이)와 Scope Narrowness(규칙의 일반화 범위 부족)의 곱으로 정의되는 지표입니다.
- Dual-Evidence Gradient Purification: Local batch evidence와 RuleBank recurrence evidence를 결합하여 불필요하거나 과도하게 특정한 규칙(case-specific patches)을 필터링하는 단계입니다.
- Semantic Edit Regularization: LLM 기반의 analyzer를 통해 프롬프트 수정 전후의 구조적 변화를 감지하고, Capacity와 Scope 채널에서의 degradation을 정규화하는 기법입니다.
- TextReg: Capacity Cost와 Scope Narrowness를 제어하여 Out-of-Distribution (OOD) 일반화 성능을 극대화하는 정규화 프레임워크입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM의 프롬프트 최적화 과정에서 발생하는 Prompt Distributional Overfitting 문제를 해결하고자 합니다. 최근의 프롬프트 최적화 기법들은 학습 과정에서 프롬프트의 길이를 무분별하게 늘리거나, 특정 사례에만 적용되는 좁은 규칙들을 누적시킴으로써 일반화 성능을 떨어뜨리는 경향이 있습니다 [Figure 1]. 이러한 현상은 단순히 최적화 동역학의 문제가 아니라, 최적화 과정에서 표현(Representation)에 대한 제어가 결여된 데서 기인하는 효율성 저하의 결과입니다. 따라서 저자들은 Representational Inefficiency라는 개념을 통해 이러한 문제를 공식화하고, 이를 체계적으로 정규화할 수 있는 새로운 접근 방식을 제안합니다.
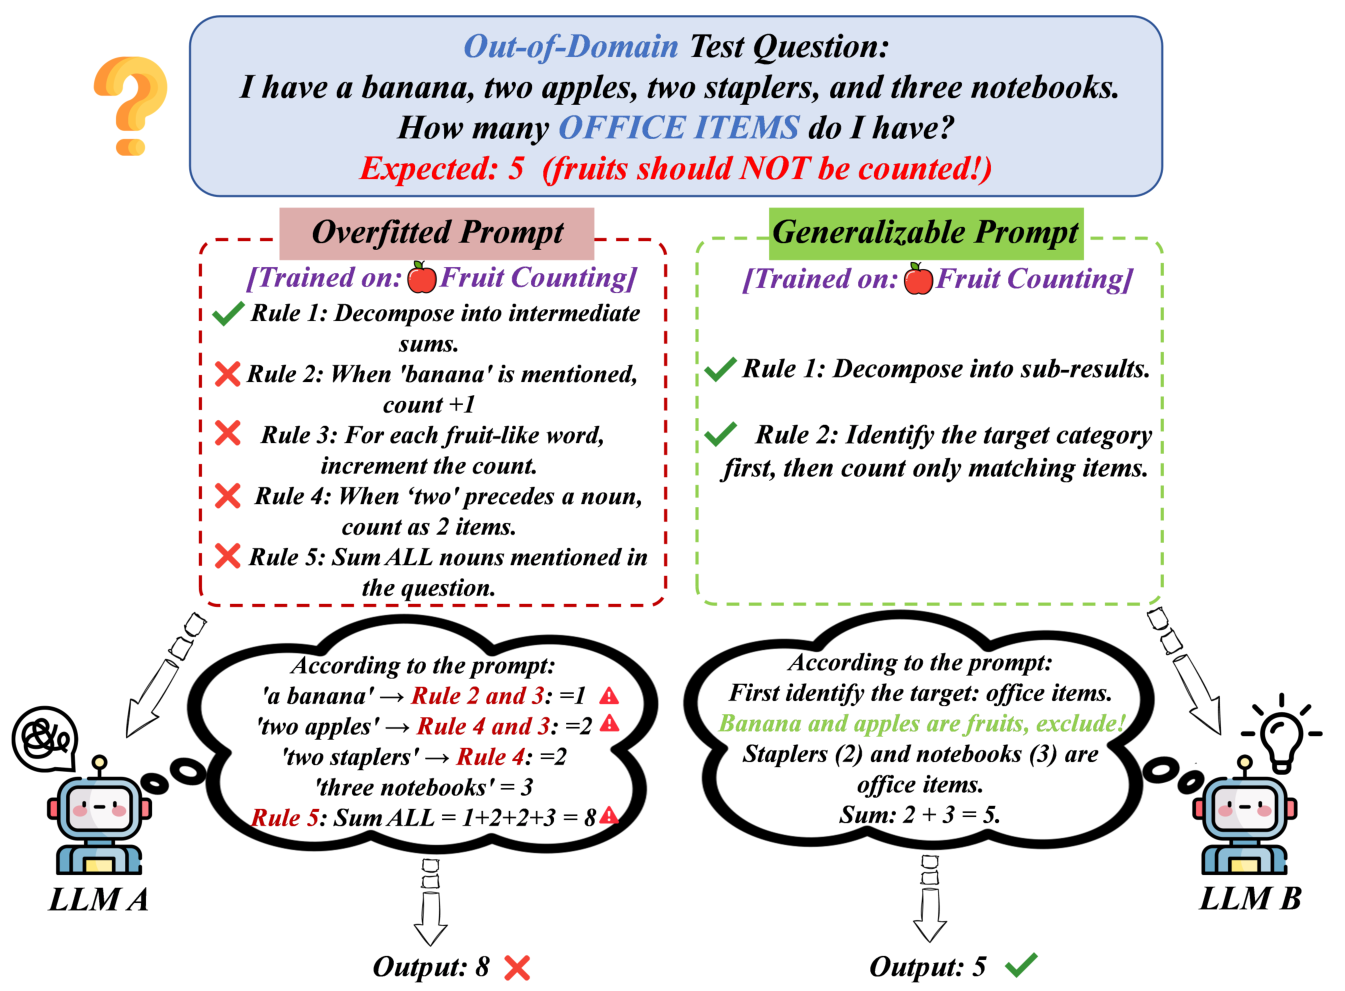
Figure 1 — 프롬프트 과적합 문제 정의
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 프롬프트의 성능을 유지하면서 구조적 효율성을 제어하는 TextReg 프레임워크를 제안합니다 [Figure 2]. TextReg는 크게 세 단계로 작동합니다: 1) Dual-Evidence Gradient Purification을 통해 로컬 데이터와 RuleBank를 바탕으로 불필요한 노이즈를 제거한 최적화 신호를 생성하고, 2) Semantic Edit Regularization을 통해 수정된 프롬프트가 용량과 일반화 범위 측면에서 퇴보했는지 감지하며, 3) Regularization-Guided Prompt Update를 통해 태스크 충실도와 정규화 목표를 통합하여 최적의 프롬프트로 업데이트합니다. 실험 결과, TextReg는 여러 Reasoning 벤치마크에서 기존의 TextGrad 대비 최대 +11.8%, REVOLVE 대비 최대 +16.5%의 Accuracy 향상을 달성했습니다 [Table 1]. 특히, 소스 태스크보다 난이도가 높은 Out-of-Distribution (OOD) 환경에서 기존 방법론들은 CoT보다 낮은 성능을 보이는 반면, TextReg는 안정적이고 우수한 일반화 성능을 입증했습니다 [Figure 3].
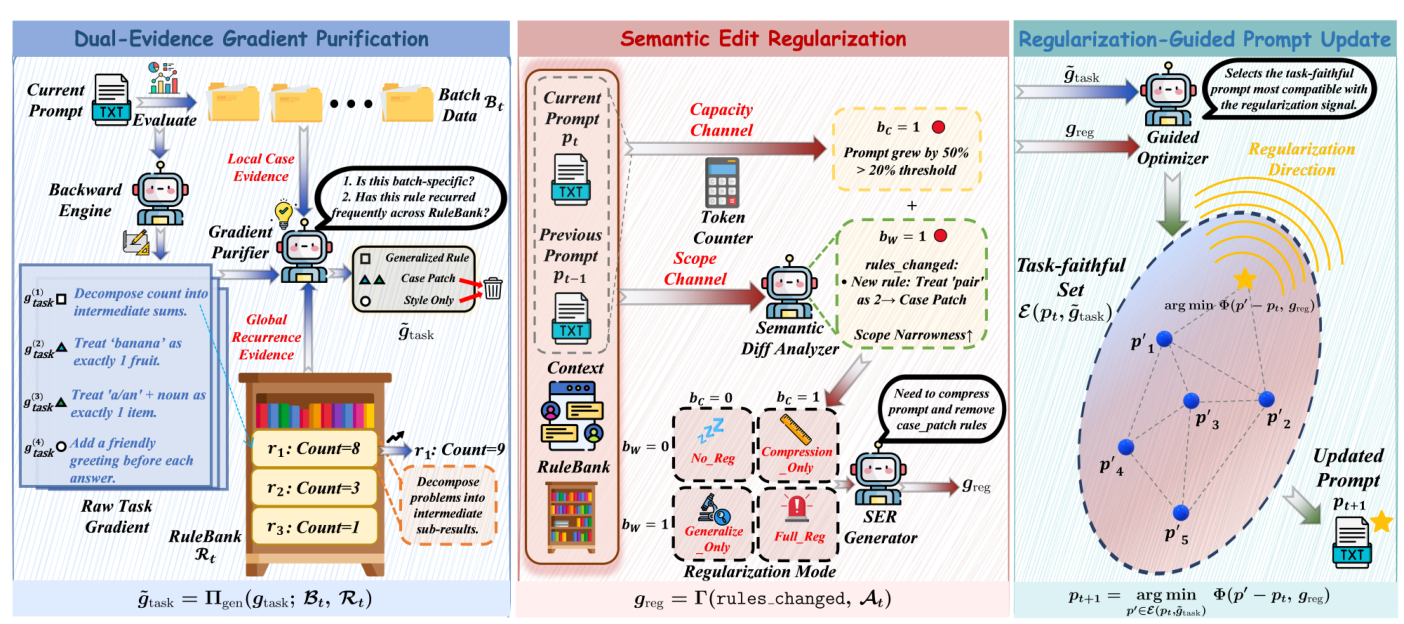
Figure 2 — TextReg 전체 프레임워크
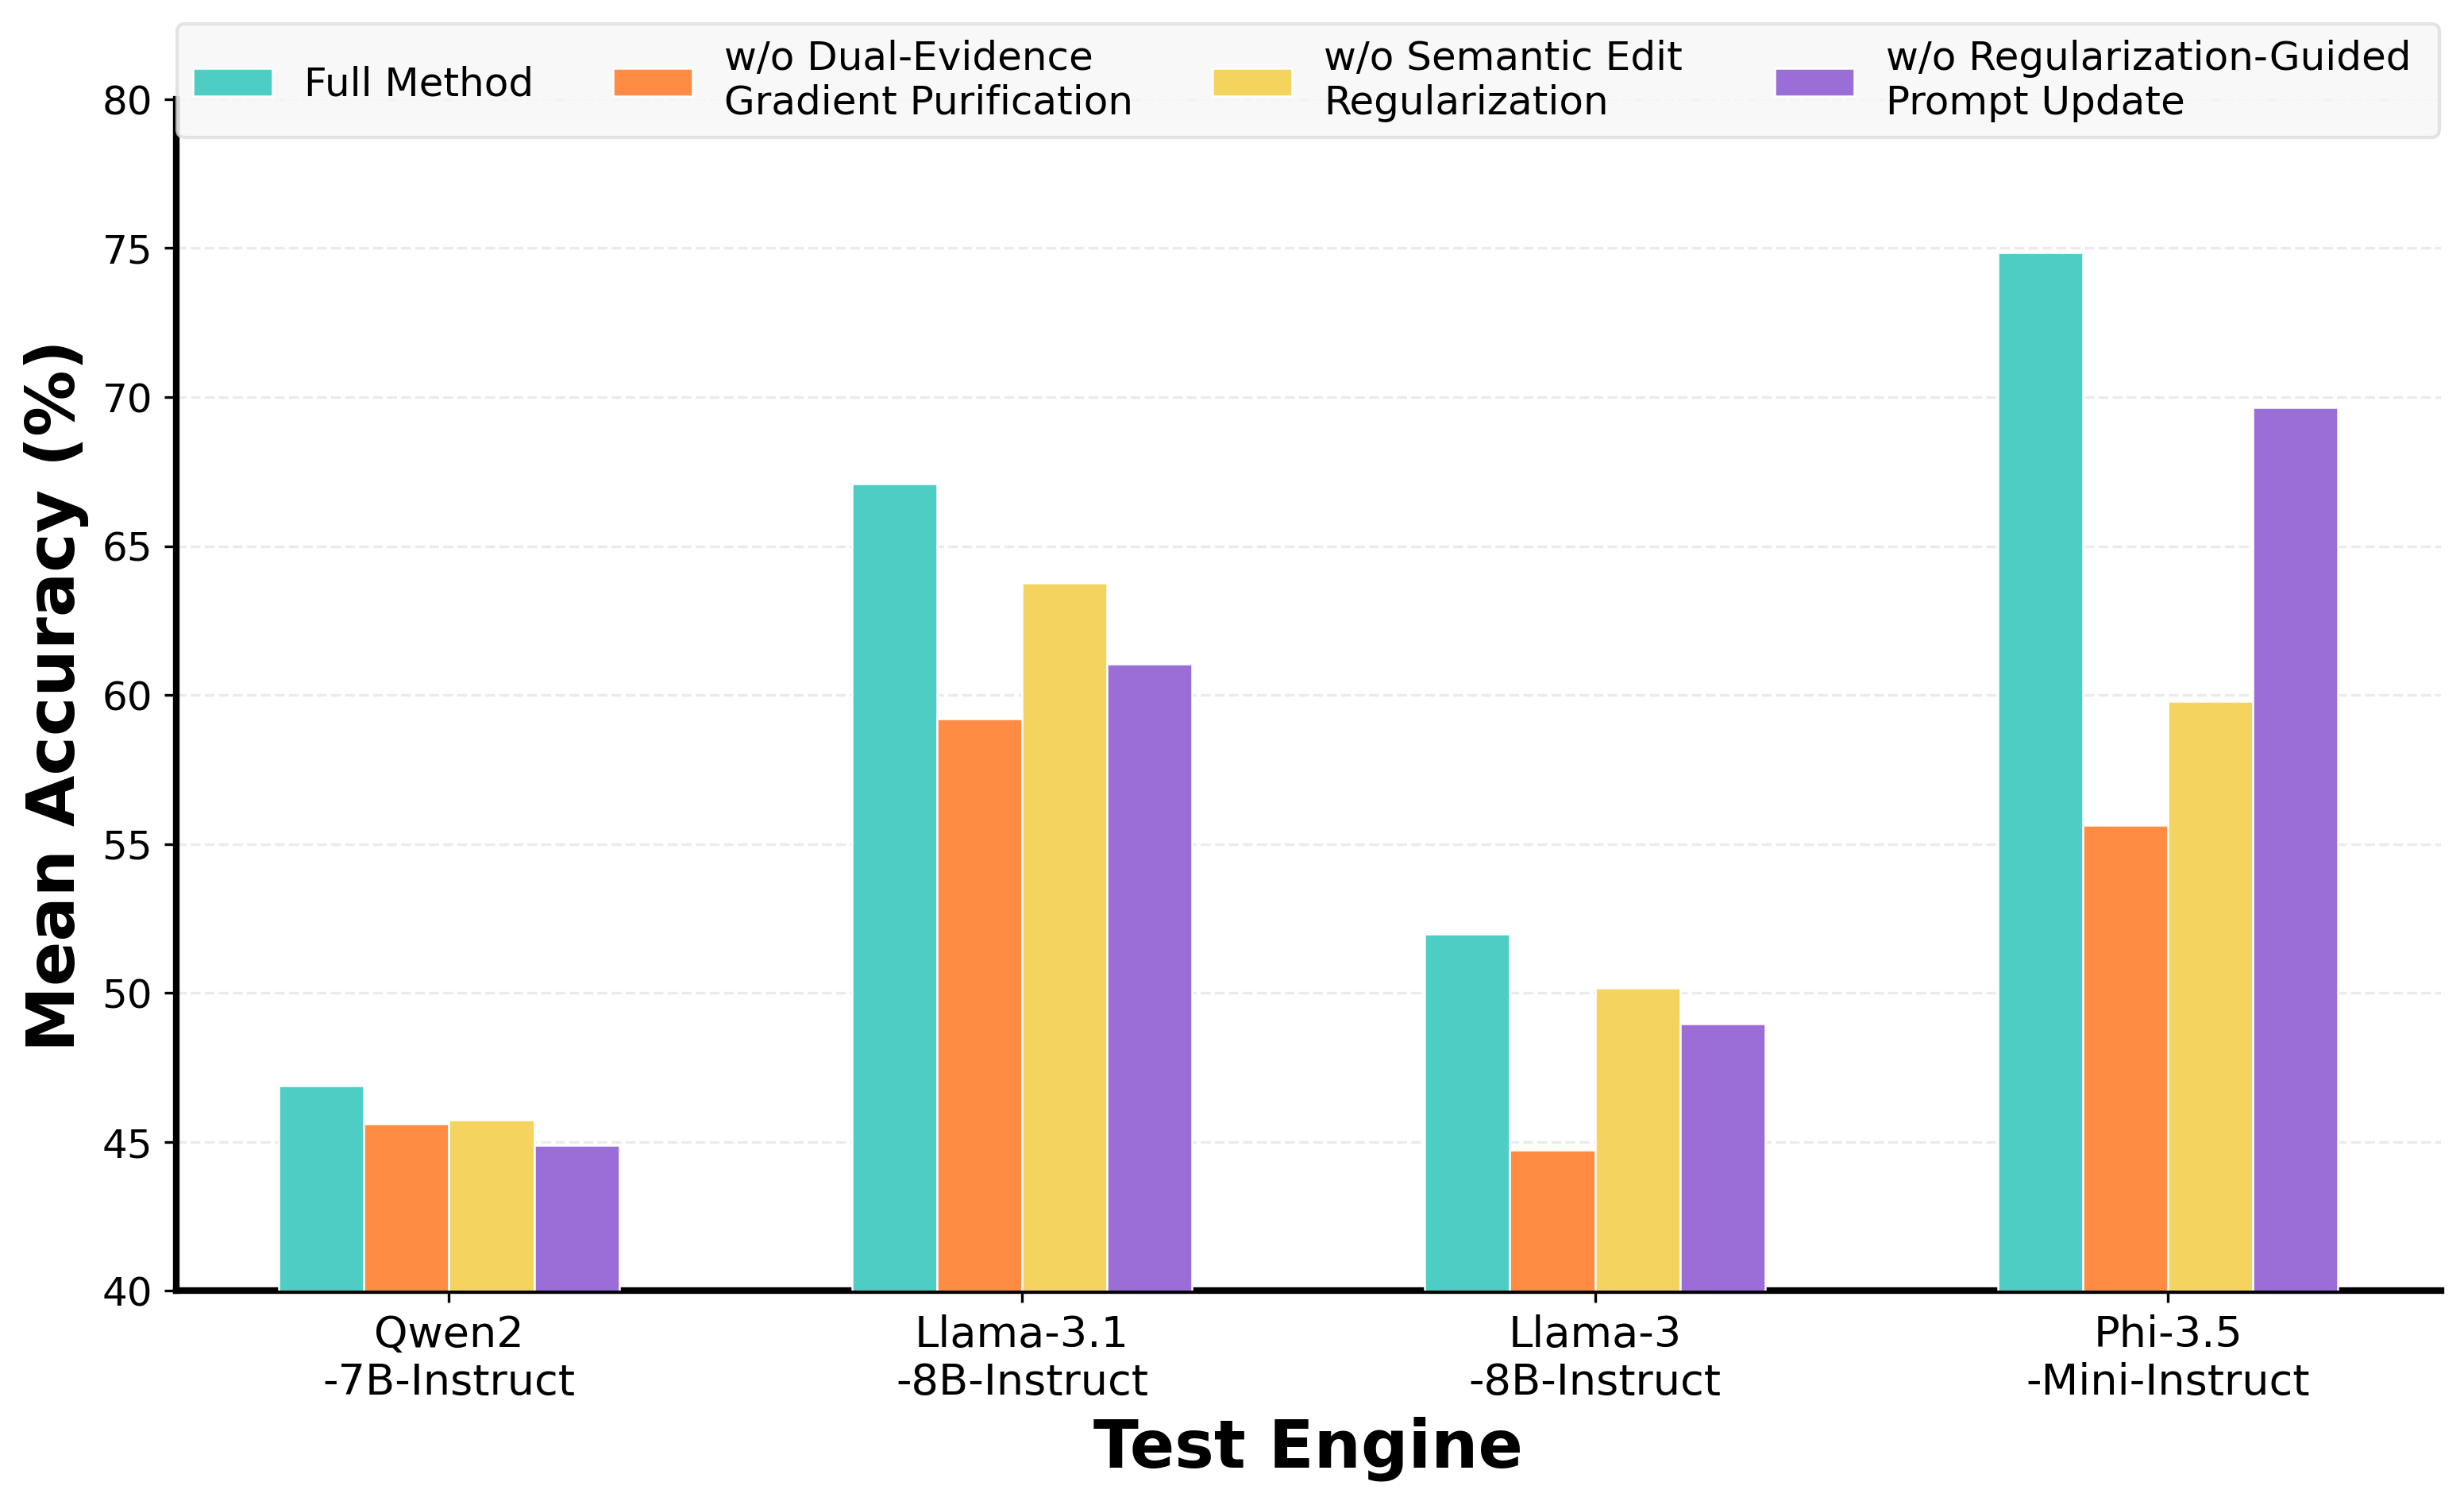
Figure 3 — 핵심 구성요소 제거 실험
4. Conclusion & Impact (결론 및 시사점)
본 논문은 프롬프트 최적화의 핵심적인 실패 모드인 Prompt Distributional Overfitting을 효율성의 관점에서 성공적으로 정의하고 해결했습니다. Representational Inefficiency라는 개념적 도구와 이를 제어하는 TextReg 프레임워크는 대규모 언어 모델의 프롬프트 엔지니어링을 자동화하는 데 있어 중요한 전환점을 제공합니다. 이 연구는 단순히 성능 향상에 그치지 않고, 복잡한 자연어 최적화 과정에서 정규화 기법의 가능성을 명확히 입증했습니다. 향후 더 복잡한 Reasoning 태스크나 긴 문맥 최적화 분야에서 강력한 기준점으로 활용될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] AgentGrad: Intervention-guided Prompt Optimization for Multi Agent Systems
- [논문리뷰] Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding Agents
- [논문리뷰] Vela: User Behavior as Supervision Sparks LLM Intelligence
- [논문리뷰] Stateless Language Agents: Scaling Long-Horizon Automated Research
- [논문리뷰] PreSTO: Predictive Subtree Prefetching for Fast LLM Power Sampling
Review 의 다른글
- 이전글 [논문리뷰] SoK: Semantic Decision Engines in Network Control Loops
- 현재글 : [논문리뷰] TextReg: Mitigating Prompt Distributional Overfitting via Regularized Text-Space Optimization
- 다음글 [논문리뷰] The Missing Primitive: Diagnosing and Repairing Mathematical Reasoning in Large Language Models
댓글