[논문리뷰] World Editing: Intervening on Executable Worlds at Increasing Depth
링크: 논문 PDF로 바로 열기
저자: Max Ku, Nok-Kan Law, Yu-Chien Tang, Shih-Ying Yeh, Ping Nie, Andy Zheng, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- World Editing: 기존의 실행 가능한 세계(Executable World)에서 엔티티, 동적 시스템, 규칙 등을 의도적으로 수정하면서도 보존해야 할 속성은 유지하는 AI 능력입니다.
- Intervention Depth: 수정 작업이 세계의 엔티티, 동적 특성 및 시스템 간의 결합(Coupling)을 얼마나 강력하게 다루어야 하는지를 정의하는 척도입니다(L1~L4로 분류).
- IGMBench: Minecraft와 Terraria를 기반으로 110개의 태스크와 1.1K 이상의 실행 가능한 평가 기준을 포함한 세계 수정 능력 평가용 벤치마크입니다.
- IGMWorld: 에이전트가 모드 저장소를 수정하고, 빌드 및 실행을 거쳐 평가받을 수 있도록 설계된 실행 환경입니다.
- TPIPS: 텍스트 조건을 입력받아 생성된 자산의 의미적, 스타일적 일관성을 평가하는 텍스트 기반 지각 메트릭입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 현대 AI 에이전트가 세계를 생성(Generation)하거나 그 안에서 상호작용하는 능력은 크게 발전했으나, 이미 존재하는 세계를 의도적으로 수정(World Editing)하는 능력은 체계적으로 연구되지 않았다는 문제의식을 바탕으로 합니다. 기존 연구들은 대개 단일 자산 수정이나 제한된 시각적 변화에 머물러 있어, 복잡한 게임의 시스템이나 규칙을 변경하는 수준에는 미치지 못합니다. 이에 저자들은 세계 수정 능력을 구조화하고, 깊이(Depth)에 따른 성능 차이와 실패 원인을 규명하기 위한 새로운 프레임워크를 제안합니다. 이를 위해 산업 표준 게임 모딩 환경을 활용하여 에이전트가 실제 실행 가능한 환경에서 작업을 수행하도록 설계했습니다 [Figure 1].
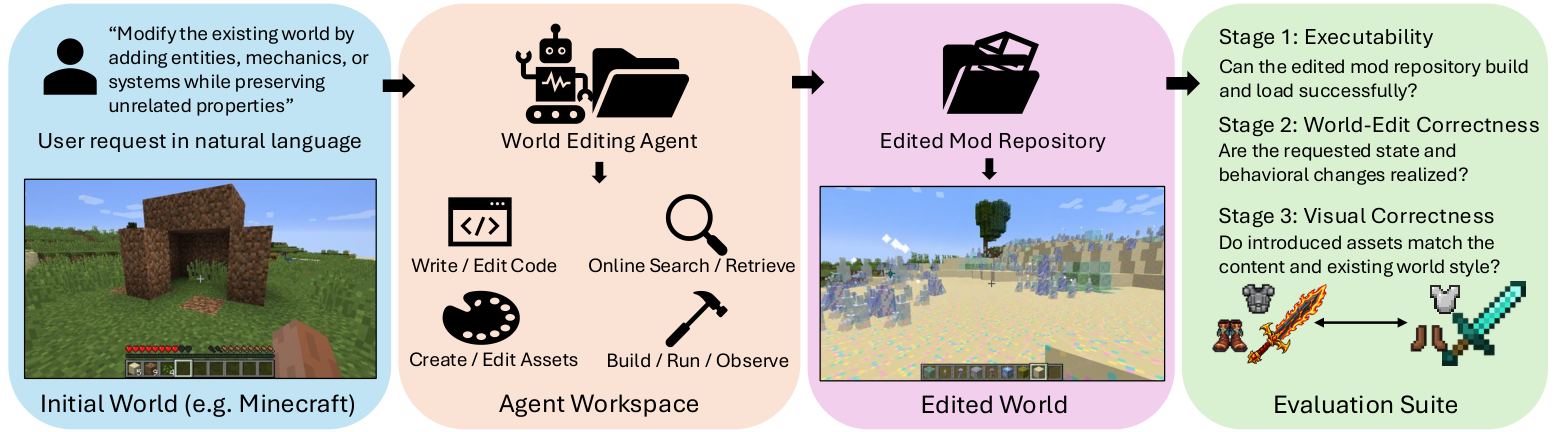
Figure 1 — IGMWorld 수정 워크플로우
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 저자들은 수정의 난이도를 4단계(L1: Property, L2: Entity, L3: Dynamics, L4: System)로 정의하고, IGMWorld 환경 내에서 에이전트가 자연어 요청을 받아 게임 모드를 수정하도록 구현했습니다. 실험 결과, GPT-5.6 Sol 모델이 WSR(World-Editing Success Rate) 기준 78.2%의 최고 성능을 기록하였으며, CPR(Criterion Pass Rate)은 94.8%까지 도달했습니다 [Table 3]. 수정 깊이가 깊어질수록 성능이 체계적으로 감소하는 양상을 보였으며, 이는 단순히 평가 기준의 개수 때문이 아니라 작업 자체의 구조적 결합도 때문임을 증명했습니다 [Figure 2]. 대부분의 에이전트는 빌드와 실행에는 성공하나, 이후 구동되는 세계에서의 행동적 오류(Behavioral Failure)가 주된 실패 원인으로 밝혀졌습니다 [Figure 3]. 시각적 일관성 측면에서는 모든 모델이 47% 미만의 낮은 공동 패스율을 보이며, 기능적 수정과 시각적 수정 능력이 서로 다른 병목 현상을 겪고 있음을 확인했습니다 [Table 4].
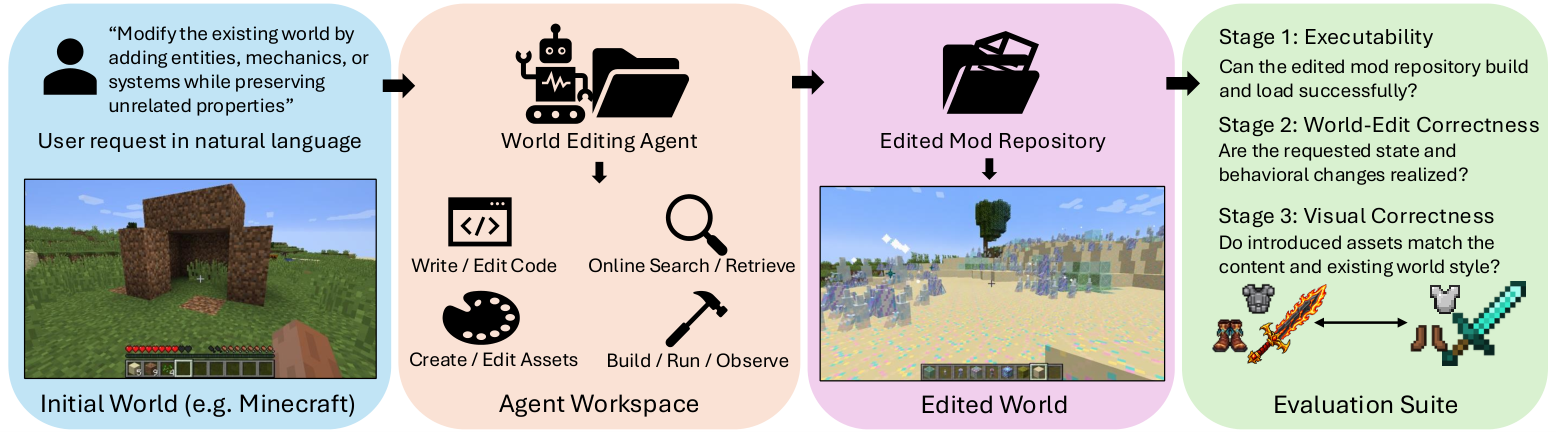
Figure 2 — 수정 깊이별 신뢰성 분석
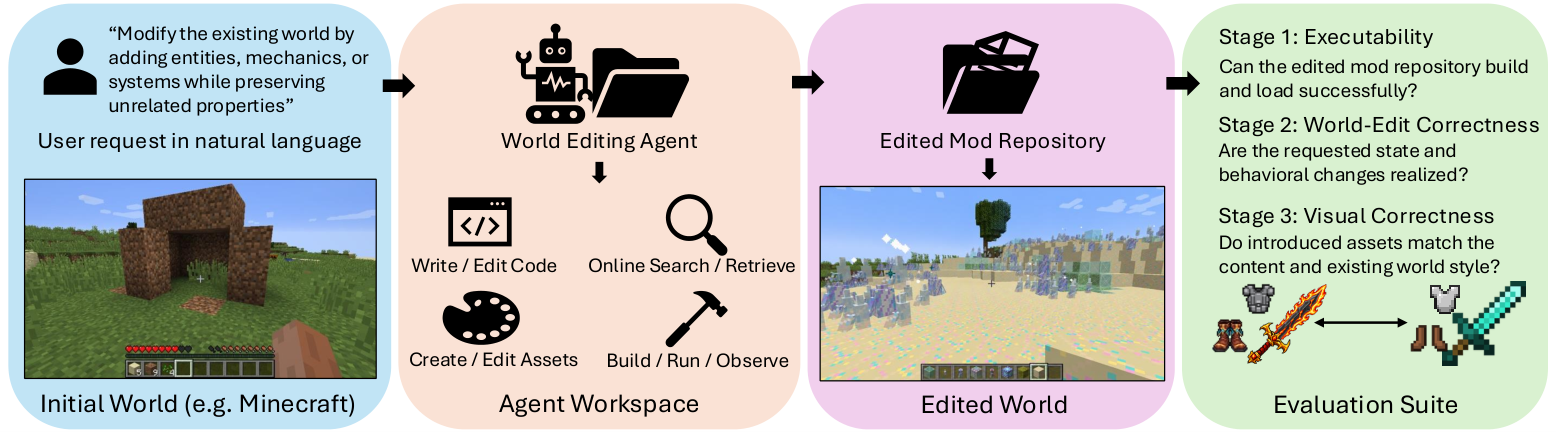
Figure 3 — 수정 실패 유형 분석
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 세계 수정을 독립적인 AI 능력으로 정립하고, 세계 생성 및 상호작용과 차별화되는 고유한 도전 과제임을 시사합니다. 연구를 통해 에이전트가 단순히 코드를 생성하는 수준을 넘어, 복잡한 상호작용 시스템을 이해하고 수정할 수 있는 능력이 요구됨을 밝혔습니다. 이는 향후 AI가 복잡한 시뮬레이션 환경을 제어하고, 사용자의 요구에 맞춰 기존의 실행 가능한 디지털 세계를 변형하는 응용 분야에서 핵심적인 기초 자료가 될 것입니다. 본 연구에서 제안된 IGMBench는 복잡한 시스템의 일관성을 유지하며 세계를 수정하려는 AI 모델의 한계와 발전 가능성을 제시합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] SWEeper-Bench: Can Agents Discover Bugs in Interactive Software?
- [논문리뷰] Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding Agents
- [논문리뷰] AgentSWE: Can Coding Agents Build the Agent You Actually Want?
- [논문리뷰] SWE-Duel: Towards a Self-Scaling Arena for Coding Agents
- [논문리뷰] ProgramGym: Scaling Training Environments for Long-Horizon Program Reproduction Agents
Review 의 다른글
- 이전글 [논문리뷰] When to Switch: Reliable Action-Chunk Extension for Vision-Language-Action Models
- 현재글 : [논문리뷰] World Editing: Intervening on Executable Worlds at Increasing Depth
- 다음글 [논문리뷰] A Safe Action Is Not Enough: Feasible-Future Decoding for Vision-Language-Action Policies
댓글