[논문리뷰] EVISKILL: Grounding Skill Evolution in Replayable Evidence
링크: 논문 PDF로 바로 열기
메타데이터
저자: Yan Zhou, Yili Wang, Yiwei Dai, Qinggang Zhang, Xin Wang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Replayable Evidence Card: 특정 skill correction 제안과 이를 뒷받침하는 trajectory 내의 trigger ranges를 결합하여 기록한 데이터 구조로, 향후 re-execution을 통한 검증이 가능함.
- Working Skill: 현재 학습 중인 skill package로,
Validated Skill과 아직 공식적으로 통합되지 않았으나 replay를 통해 유효성이 검증되어 임시 보관 중인Provisional Edit Ledger의 결합체. - Cross-Epoch Evidence Propagation: 현재 epoch의 학습 결과뿐만 아니라 이전 epoch에서 생성된 evidence와 수정안을 지속적으로 유지하고 재평가하여, 점진적으로 skill을 고도화하는 메커니즘.
- Replay-Guided Edit Verification: 제안된 edit가 의도한 행동 변화를 실제로 유발하는지 확인하기 위해, 관련 trajectory를 복원하여 수정된 skill 환경에서 해당 동작을 재실행(re-execution)하는 검증 과정.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 경험 기반 skill evolution 방법들이 가진 불완전성을 해결하고자 EviSkill을 제안한다. 기존 연구들은 단순한 trajectory 피드백을 기반으로 skill을 수정하는데, 이는 수집된 경험이 특정 상황에 과적합(overfit)되거나, 수정안의 근거가 되는 행동 맥락이 손실되는 문제를 야기한다. 또한, 전체 수정안이 검증을 통과하지 못할 경우, 부분적으로 유효한 수정안까지 함께 폐기되는 비효율적인 문제가 존재한다. 따라서 본 연구는 수정안과 그 근거가 되는 execution evidence를 명시적으로 연결하고, 이를 여러 epoch에 걸쳐 지속적으로 검증 및 정제하는 증거 중심의 프레임워크를 목표로 한다 [Figure 1].
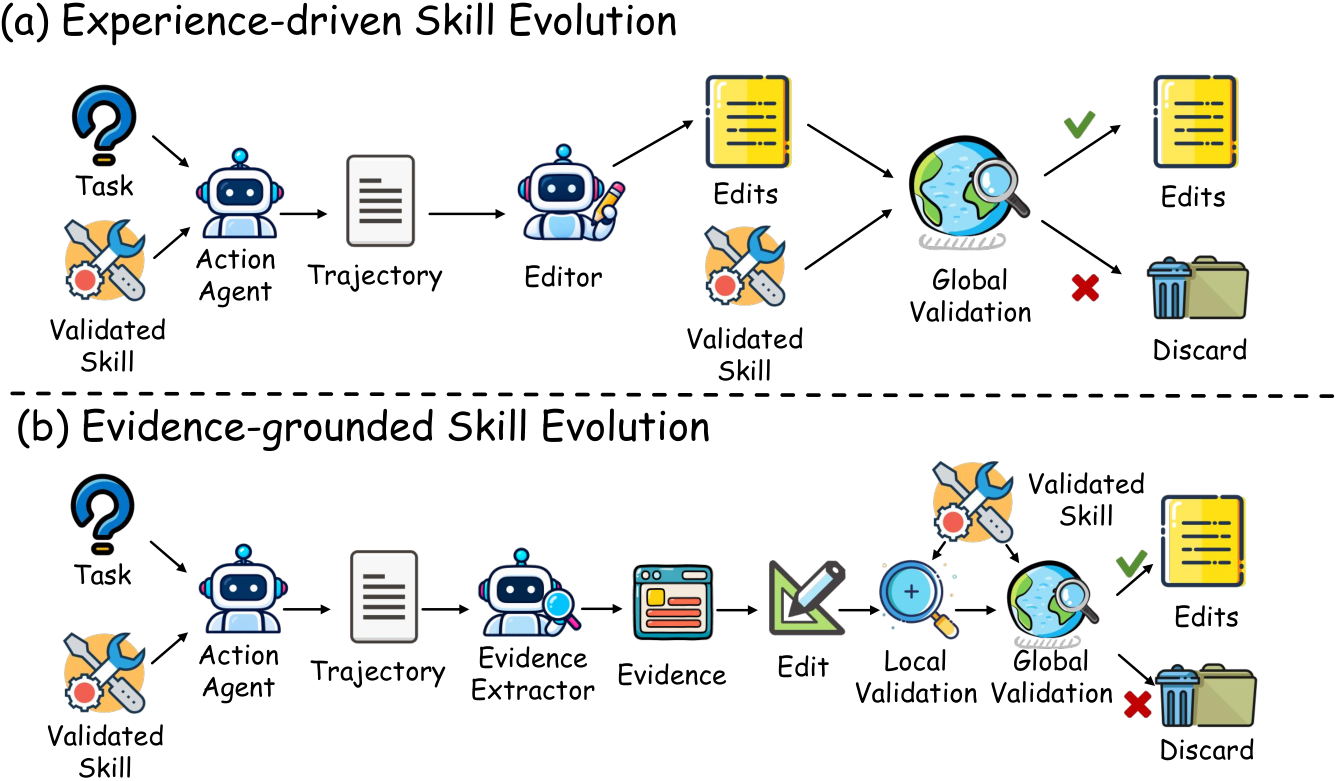
Figure 1 — 경험 기반 vs 증거 기반 skill evolution
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문이 제안하는 EviSkill은 크게 세 단계의 프로세스를 통해 운영된다. 첫째, Evidence-Grounded Edit Synthesis는 trajectory를 분석하여 수정 제안과 지원 근거를 Replayable Evidence Card 형태로 생성한다. 둘째, Replay-Guided Edit Verification은 제안된 edit가 실제 실행 환경에서 의도한 효과를 내는지 재실행(replay)을 통해 검증하며, 필요시 수정안을 보완한다. 마지막으로, Cross-Epoch Evidence Propagation은 검증된 edit를 임시 Ledger에 보관하고, 검증 실패 시에도 재실행을 통해 유효성을 재판단하여 차기 epoch에서 재사용 가능하도록 관리한다 [Figure 4]. 실험 결과, EviSkill은 ALFWorld, AppWorld, ScienceWorld 벤치마크에서 기존의 skill evolution baselines 대비 우수한 성능을 입증하였다. 특히 ScienceWorld 벤치마크에서 Qwen3.5-9B backbone 사용 시, 기존 최고 성능 대비 약 15.64%p 향상된 정확도를 기록하였다. 전체적인 모델 성능 평가에서 18개 테스트 환경 중 14개에서 최상위(best) 성능을 달성하며, 경험 기반 수정의 한계인 성능 저하를 방지하고 지속적인 성능 개선을 보장함을 확인하였다 [Table 1].
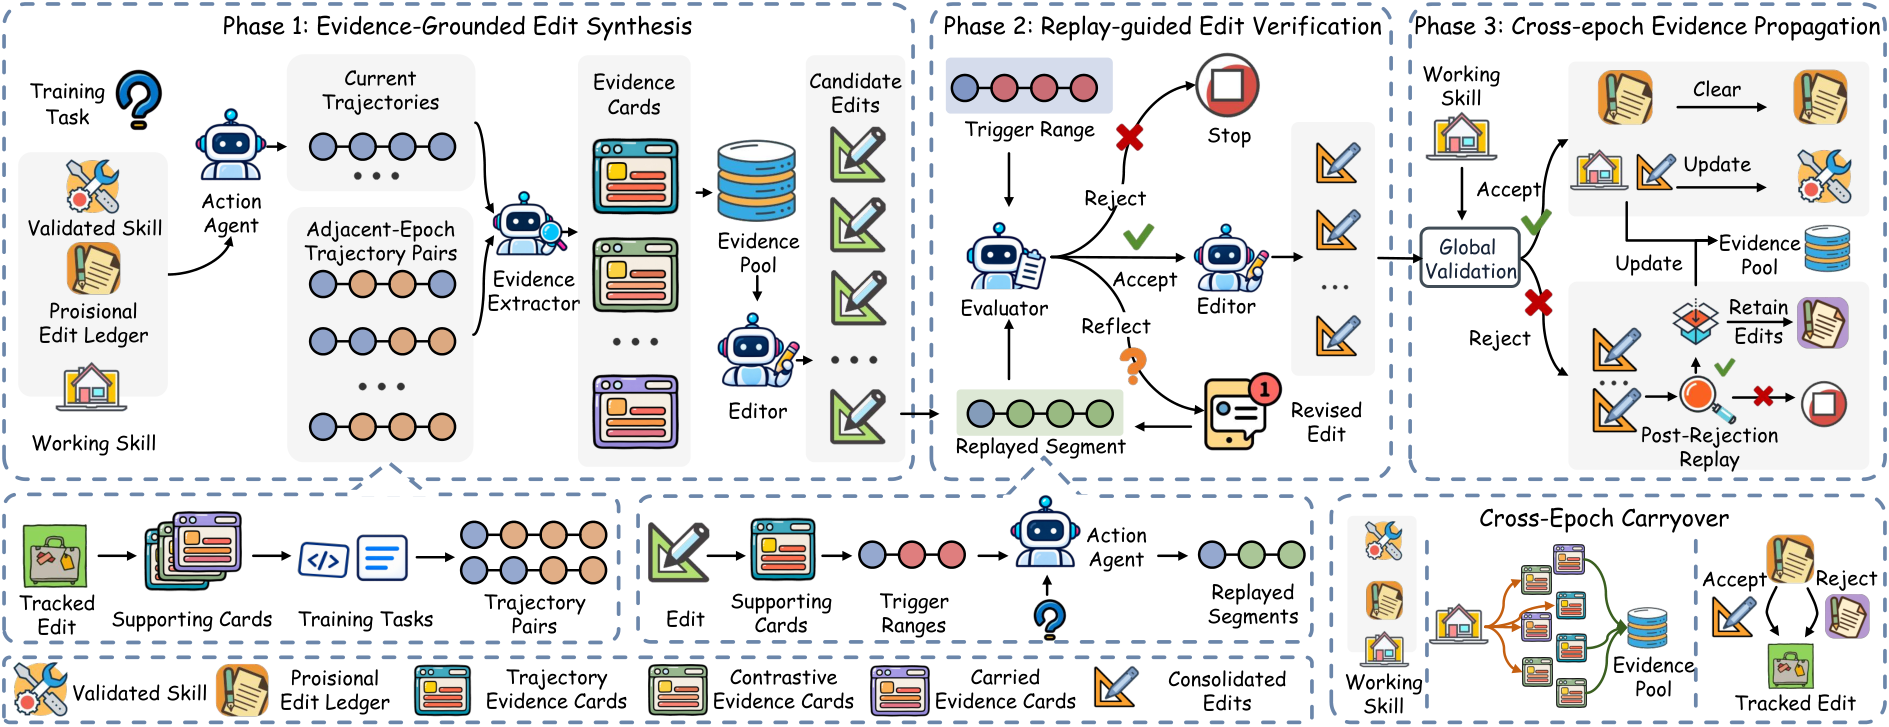
Figure 4 — EviSkill 프레임워크 구조
4. Conclusion & Impact (결론 및 시사점)
본 논문은 skill evolution 과정에서 evidence의 체계적인 유지와 behavioral verification의 중요성을 강조하며, 이를 위한 통합 프레임워크 EviSkill을 제시했다. 본 연구는 단순히 경험을 축적하는 것을 넘어, 수정안의 타당성을 검증하고 이전의 실패한 수정안에서도 유효한 요소를 추출하여 재활용함으로써 skill 학습의 신뢰성과 효율성을 크게 제고하였다. 이러한 접근 방식은 복잡하고 긴 호흡의(long-horizon) 상호작용이 필요한 LLM agent 개발에 중요한 방법론적 지침을 제공하며, 향후 학계 및 산업계의 에이전트 개발 과정에서 재사용 가능한 지식 패키지 고도화에 기여할 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] ContinualSkillBench: Can LLM Agents Truly Evolve Their Capabilities?
- [논문리뷰] When Agents Slow Down: Understanding LLM Agents' Test-Time Strategies via Elo-per-token Analysis
- [논문리뷰] SkillHone: A Harness for Continual Agent Skill Evolution Through Persistent Decision History
- [논문리뷰] OpenSkill: Open-World Self-Evolution for LLM Agents
- [논문리뷰] SkillGrad: Optimizing Agent Skills Like Gradient Descent
Review 의 다른글
- 이전글 [논문리뷰] DuoMatching: Joint-Marginal Distribution Matching for Few-Step Video Generation
- 현재글 : [논문리뷰] EVISKILL: Grounding Skill Evolution in Replayable Evidence
- 다음글 [논문리뷰] EmbodiedSmith: Scaling Embodied Data through Recursive Self-Improvement Flywheel in Simulation
댓글