[논문리뷰] Learning Functional Subspaces for Neural Network Compression
링크: 논문 PDF로 바로 열기
Part 1: 요약 본문
메타데이터
저자: Massimo Bini, Anders Christensen, Stephan Alaniz, Judah Goldfeder, Ole Winther, Yann LeCun, Ravid Shwartz-Ziv, Zeynep Akata
1. Key Terms & Definitions (핵심 용어 및 정의)
- LSP (Learnable Subspace Projections): 사전 훈련된 모델의 가중치를 고정하고, 제거할 subspace를 정의하는 orthogonal projector를 End-to-End로 최적화하는 압축 프레임워크입니다.
- Tied Group: 동일한 활성화를 공유하는 선형 레이어(예: Q, K, V 또는 gate/up)들의 집합으로, 이들은 하나의 tied projector를 공유하여 학습 효율과 추론 성능을 높입니다.
- Measured-KL Allocation: 각 유닛이 모델 출력에 미치는 영향을 KL divergence로 직접 측정하고, parameter budget 내에서 가장 낮은 비용(cost-per-saved-parameter)을 갖는 방향으로 압축률을 배분하는 전략입니다.
- Latent-cache: LSP에서 적용되는 추론 방식으로, 공통된 latent 벡터만을 저장하여 전체 KV cache를 획기적으로 축소하는 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 현대 Transformer 모델의 심각한 메모리 및 연산 효율성 문제를 해결하기 위해, 모델의 functional subspace를 식별하여 최적의 압축을 수행하는 방법을 제안합니다. 기존의 low-rank 압축 연구들은 activation statistics나 개별 레이어의 reconstruction error와 같은 local한 기준에 의존하여 중요한 정보를 무시하거나 깊이에 따른 오차 누적을 초래했습니다 [Figure 1]. 또한, 기존의 loss-aware 접근 방식들은 고압축 상황에서의 surrogate loss 성능 저하라는 한계를 가지고 있습니다. 따라서 저자들은 네트워크의 전체적인 출력 분포에 기반하여 압축 방향을 결정하는 End-to-End 학습 방법론이 필요함을 역설합니다 [Figure 2].
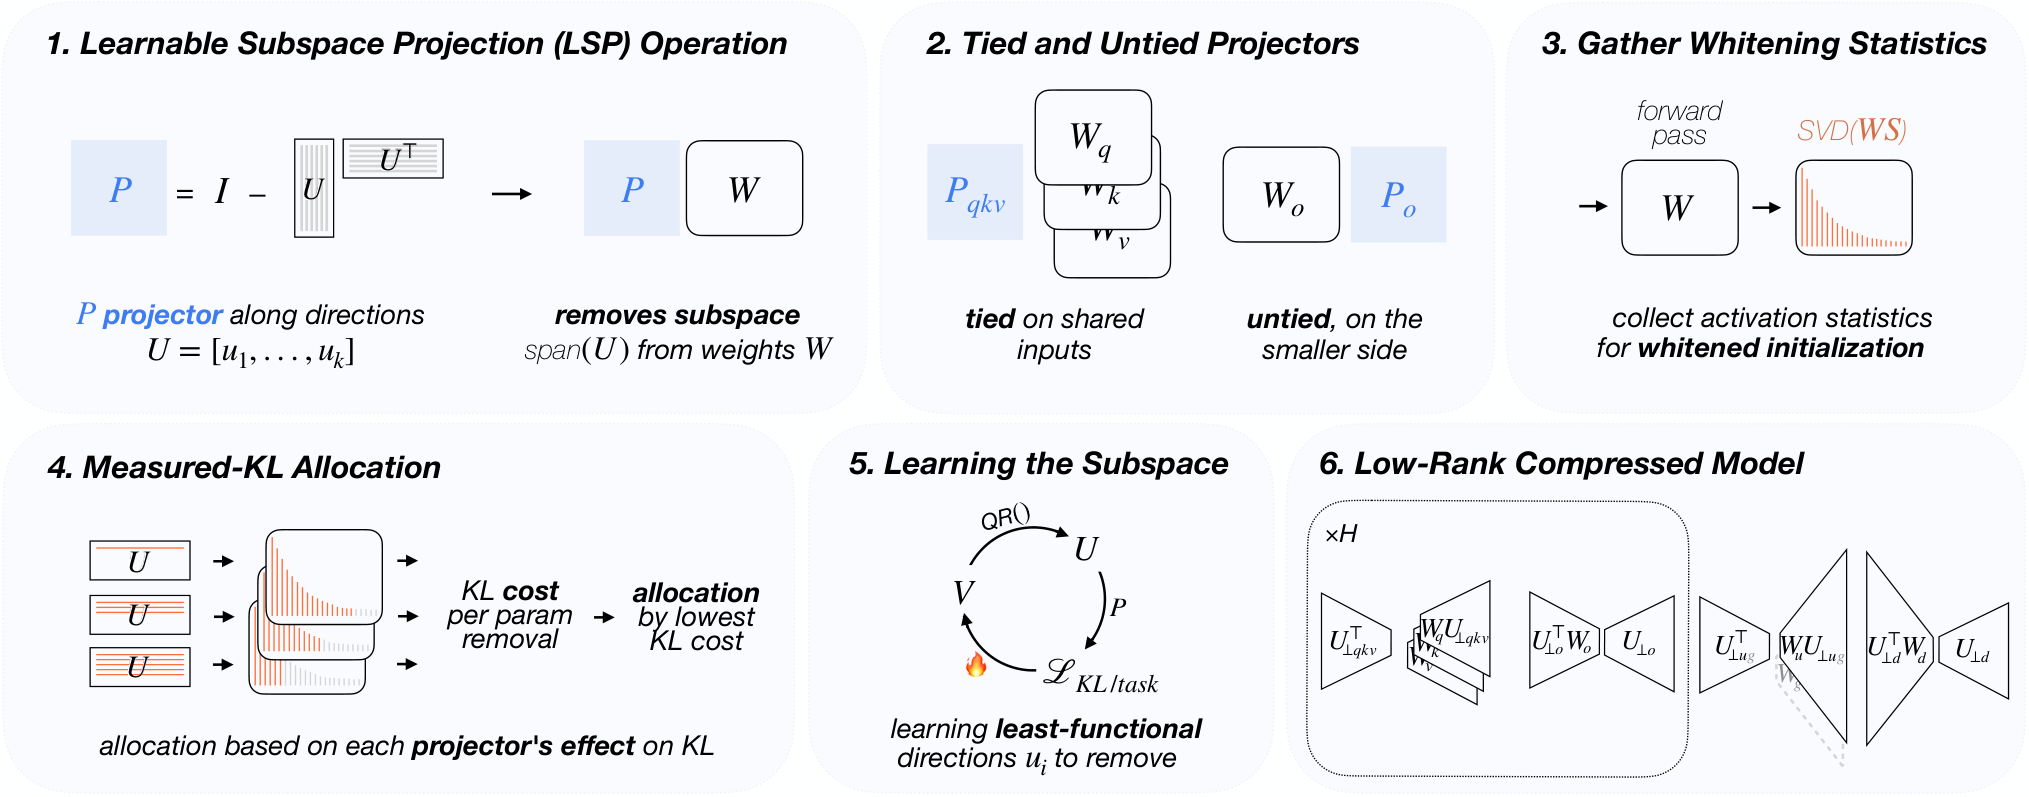
Figure 1 — 기존 방식과 LSP 비교
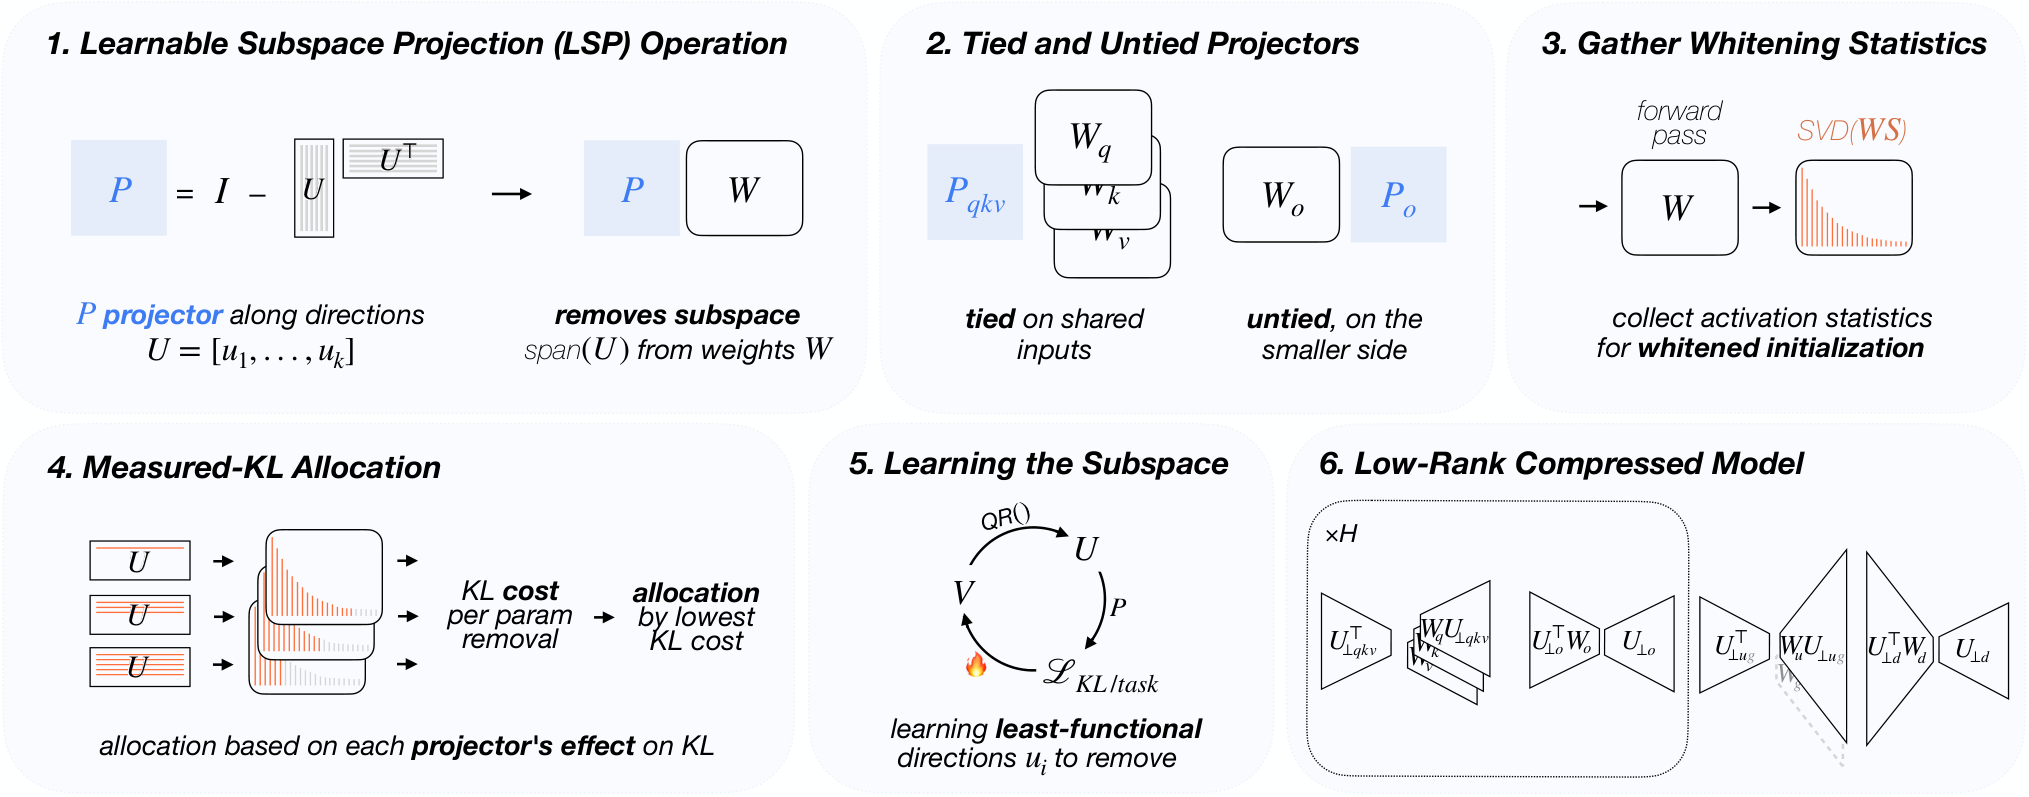
Figure 2 — LSP 전체 파이프라인
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 각 레이어의 orthogonal projector를 KL divergence를 최소화하는 방향으로 학습시키는 LSP를 제안합니다 [Figure 2]. 제안된 기법은 whitened initialization을 통해 최적화의 시작점을 확보하며, 훈련 과정에서는 사전 훈련된 가중치를 완전히 고정한 채 오직 projector 파라미터만을 학습시킵니다. 실험 결과, Llama-2-7B 모델을 -70% 압축했을 때, LSP는 WikiText-2 perplexity 10.9를 기록하여 기존 최강 baseline(13.3) 대비 월등한 성능 우위를 보였습니다 [Table 1]. 또한, zero-shot accuracy에서도 모든 비교군 대비 높은 수치를 기록하며 다양한 벤치마크에서 일반화 성능이 뛰어남을 입증했습니다 [Table 2]. 효율성 측면에서는 latent-cache를 통해 Dense 모델 대비 13.5x 작은 메모리 점유율을 달성하며, 디코딩 속도 또한 기존 factorization 기법들보다 1.6x 향상된 결과를 보였습니다 [Table 5].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 모델의 기능적 보존을 위해 functional subspace를 직접 학습하는 것이 압축의 핵심임을 입증했습니다. 제안된 LSP 프레임워크는 레이어 간의 종속성을 파악하고 전역적인 objective를 통해 압축 효율을 극대화함으로써, 고압축률에서도 성능 저하를 최소화합니다. 이 연구는 대규모 모델의 경량화 기술이 단순히 가중치를 줄이는 것을 넘어, 모델의 본질적인 출력 행위를 보존하는 방향으로 나아가야 함을 보여줍니다. 이는 향후 자원이 제한된 환경에서의 대규모 언어 모델 배포 및 산업적 적용에 중요한 기술적 토대를 제공할 것으로 기대됩니다.
Part 2: 중요 Figure 정보

Figure 1 — 기존 방식과 LSP 비교
Figure 2 — LSP 전체 파이프라인
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] The Life Cycle of a Massive Activation: Stochastic Birth, Weight-Decay-Driven Growth, and Competitive Consolidation
- [논문리뷰] Foundations of Large Language Models
- [논문리뷰] Towards In-Parameter Memory Augmentation for Large Language Models
- [논문리뷰] SlimWise: Decoupling Expert Pruning Across Prefill and Decode for Efficient MoE Serving
- [논문리뷰] Do Language Models Need a Trainable Input Embedding Table? Fixed Minimal Token Codes at 1.7B-Class Scale
Review 의 다른글
- 이전글 [논문리뷰] Learning Discriminative Geometry for Drifting Models
- 현재글 : [논문리뷰] Learning Functional Subspaces for Neural Network Compression
- 다음글 [논문리뷰] Learning to Read the Contextual Tokens in Diffusion Transformers
댓글