[논문리뷰] Learning to Read the Contextual Tokens in Diffusion Transformers
링크: 논문 PDF로 바로 열기
메타데이터
저자: Omer Dahary, Etai Sella, Hadar Averbuch-Elor, Daniel Cohen-Or, Or Patashnik
1. Key Terms & Definitions (핵심 용어 및 정의)
- MM-DiT (Multimodal Diffusion Transformers): 텍스트와 시각적 토큰이 공동으로 어텐션(Attention)에 참여하여 상호 업데이트되는 생성 모델 아키텍처입니다.
- Contextual Tokens: MM-DiT 내에서 multimodal attention을 통해 텍스트 토큰이 이미지 정보를 흡수하며 형성되는 동적 표현입니다.
- Contextual Reader: Bottleneck Network를 활용하여 Contextual Tokens를 자연어로 질문하고 답변을 얻을 수 있게 하는 해석 프레임워크입니다.
- Contextual Alignment (CoAl): Contextual Tokens가 이미지의 핵심 시각적 의미 정보를 인코딩하도록 정규화(Regularization)하는 학습 기법입니다.
- Bottleneck Network: 고차원의 Contextual Tokens를 LLM이 이해 가능한 수준의 Contextual Descriptor로 압축하는 경량 신경망입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 현대 MM-DiT 모델의 성능을 견인하는 Contextual Tokens가 내부적으로 어떤 의미 정보를 담고 있는지 불분명하다는 문제를 제기한다. 기존 연구들은 시각적 토큰(Visual tokens)에 집중하여 이를 가시화하고 조정하는 방법을 탐구했으나, Contextual Tokens는 명시적인 공간적 대응 관계나 감독(Supervision)이 부족하여 해석이 어려웠다. 저자들은 이러한 내부 표현의 불투명성이 생성 과정의 제어 및 모델 최적화에 한계를 준다고 판단하였다. 따라서 본 연구는 Contextual Tokens의 의미론적 내용을 추출하고 이를 모델 학습에 활용하는 새로운 해석적 접근 방식을 제안한다 [Figure 1].
Figure 1 — 초기 Contextual 토큰의 의미 정보
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Contextual Reader와 Contextual Alignment (CoAl)를 결합한 새로운 해석 및 학습 프레임워크를 제안한다. Contextual Reader는 Bottleneck Network를 통해 Contextual Tokens를 LLM의 입력 공간으로 매핑하여, 생성 중인 이미지에 대한 자연어 질문에 답할 수 있도록 한다 [Figure 2]. 실험 결과, 모델은 프롬프트가 없는(empty prompt) 상태에서도 디노이징 초기 단계부터 이미지의 핵심 의미를 파악하고 있었으며, 이는 생성 품질과 HPS (Human Preference Score) 간에 양의 상관관계가 있음을 보여준다 [Figure 5]. 이를 바탕으로 제안된 Contextual Alignment (CoAl)는 SigLIP 기반의 global semantic teacher와 Contextual Tokens를 정렬하여 모델의 생성 품질 및 분포 커버리지를 효과적으로 향상시킨다 [Figure 6]. 정량적으로는 Contextual Alignment가 적용된 모델이 미세 조정(Fine-tuning) 단계에서 기존 방식 대비 더 높은 HPS 개선폭을 나타냈다.
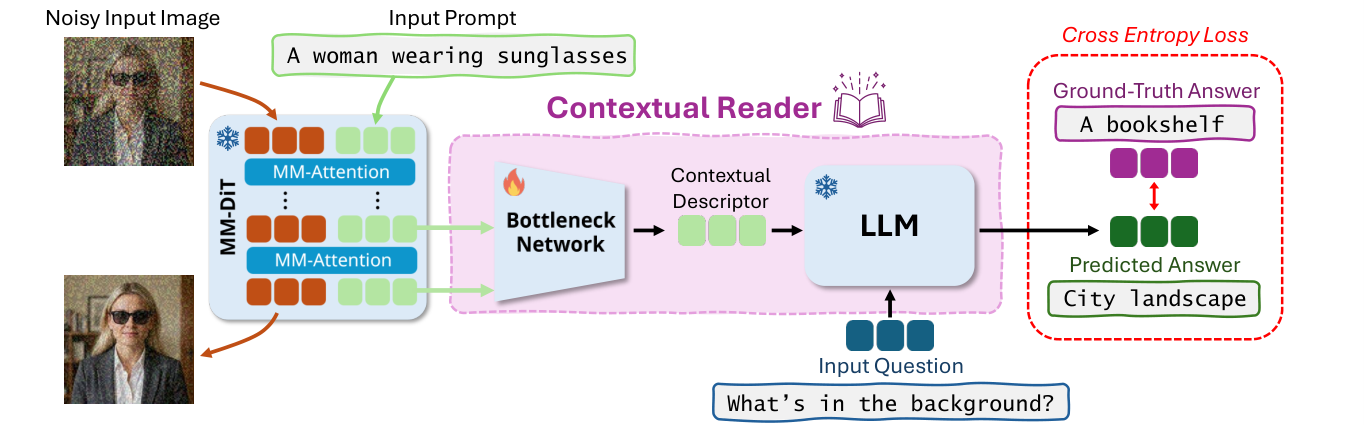
Figure 2 — Contextual Reader 학습 아키텍처
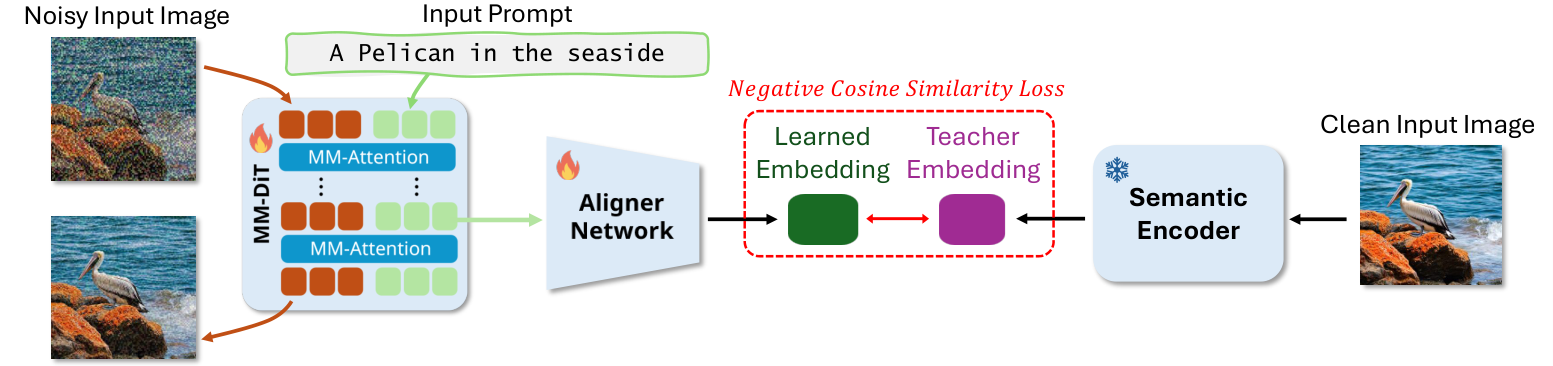
Figure 6 — Contextual Alignment 학습 구조
4. Conclusion & Impact (결론 및 시사점)
본 연구는 Contextual Tokens가 단순한 언어적 조건을 넘어 생성 과정의 핵심적인 시각-의미론적 정보를 담고 있는 해석 가능한 통로임을 입증하였다. 특히, 생성 초기부터 존재하는 높은 의미적 가독성은 모델의 최종 생성 품질을 예측하는 중요한 지표로 활용될 수 있음을 확인하였다. 이 연구는 MM-DiT의 내부 역학을 규명하는 새로운 도구를 제공하며, Contextual Alignment를 통해 모델의 생성 성능을 향상시키는 새로운 학습 패러다임을 제시한다. 향후 다중 모달 생성 모델의 가설 해석 및 강건한 학습 방법론 연구에 중요한 이정표가 될 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] The Thinking Leakage in Reinforcement Learning for LLMs
- [논문리뷰] S-Space: Exploring Spatial Workspace in Multimodal Language Models
- [논문리뷰] Iris-3B: Going Beyond the Latent with Pixel-Space Diffusion Training, Conversion and Fine-Tuning
- [논문리뷰] Making LLMs Say What They Think: Measuring and Improving CoT-Interpretability Alignment
- [논문리뷰] Base Models Can Reason By Taking a Cue From Training Data
Review 의 다른글
- 이전글 [논문리뷰] Learning Functional Subspaces for Neural Network Compression
- 현재글 : [논문리뷰] Learning to Read the Contextual Tokens in Diffusion Transformers
- 다음글 [논문리뷰] Making LLMs Say What They Think: Measuring and Improving CoT-Interpretability Alignment
댓글