[논문리뷰] MIMESIS: Learning User Simulators as Training Environments for Interactive Agents
링크: 논문 PDF로 바로 열기
메타데이터
저자: Hoang Phan, Dat Huynh, Andrey Zhmoginov, Qi Zeng, Wancen Mu, Yue Cao, Shengjie Bi, Yun He, Changdae Oh, Deren Lei, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- MIMESIS: 사용자 시뮬레이터의 실재감(fidelity)과 학습 유용성을 극대화하기 위해 설계된, explicit reasoning supervision 및 13가지 현실적 행동 패턴으로 훈련된 User Simulator.
- SOUL-Index: conversational, social, cognitive, role-play, evaluation 등 5개 축을 통해 사용자 시뮬레이터의 성능을 종합적으로 평가하는 벤치마크 지표.
- CSD (Coached On-Policy Self-Distillation): 시뮬레이터가 생성한 private reasoning trace와 반응을 coaching note로 변환하여, agent 학습 시 dense, token-level supervision을 제공하는 방법론.
- ThoughtTrace: 사용자의 메시지와 함께 그 이면에 있는 motivations 및 reactions를 기록하여 시뮬레이터가 잠재적인 사용자 상태를 더 잘 이해하도록 돕는 주석 데이터셋.
- RealUserSim: 실제 인간의 대화 기록을 기반으로 시뮬레이터의 행동적 일치성(behavioral fidelity)을 측정하는 벤치마크.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 Instruction-tuned 언어 모델을 사용자 시뮬레이터로 사용할 때 발생하는 행동 불일치(behavioral mismatch) 문제를 해결하고자 한다. 대부분의 시판 LLM은 지나치게 협력적이고 명시적인 대화 패턴을 보여, 실제 인간 사용자의 모호함, 인내심 부족, 혹은 비협력적인 특성을 제대로 반영하지 못한다 [Figure 2]. 이러한 행동적 편향은 에이전트의 훈련 데이터 분포를 왜곡하여, 결과적으로 에이전트가 현실 환경으로 일반화되는 것을 방해한다. 따라서 저자들은 실제 인간의 대화 패턴과 추론 과정을 정확히 모사하면서도 에이전트 학습에 최적화된 새로운 사용자 시뮬레이터의 필요성을 제기한다.
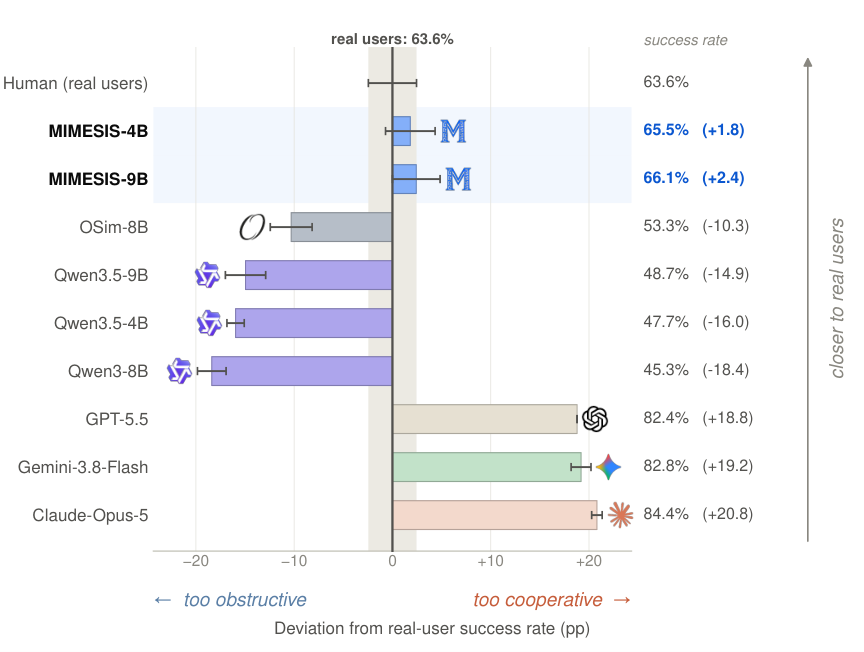
Figure 2 — 기존 LLM의 행동 불일치 문제
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 2단계 훈련 프레임워크인 MIMESIS를 제안하며, 이는 사용자 시뮬레이터 학습과 이를 환경으로 사용하는 에이전트 Post-training으로 구성된다 [Figure 3]. 1단계에서 저자들은 ThoughtTrace 데이터를 활용하여 모델이 발화 전 잠재적 추론 과정을 생성하도록 명시적으로 지도하고, 13가지 현실적 행동 패턴을 정립하여 이를 Multi-domain Reinforcement Learning의 학습 목표로 포함시켰다. 실험 결과, MIMESIS-9B 모델은 SOUL-Index 65.7을 기록하며 가장 강력한 frontier model(Claude-Opus-5 등)을 상회하였다 [Table 1]. 2단계에서는 고정된 시뮬레이터를 기반으로 에이전트를 학습시키며, 특히 CSD를 도입하여 시뮬레이터의 피드백을 dense guidance로 변환함으로써 에이전트의 성능을 향상시켰다. 8개의 환경에서 평가한 결과, MIMESIS로 훈련된 에이전트는 GPT-5.5 기반 시뮬레이터로 훈련된 에이전트보다 9개의 미학습 평가 사용자 모델 모두에서 우수한 성능을 보였다.
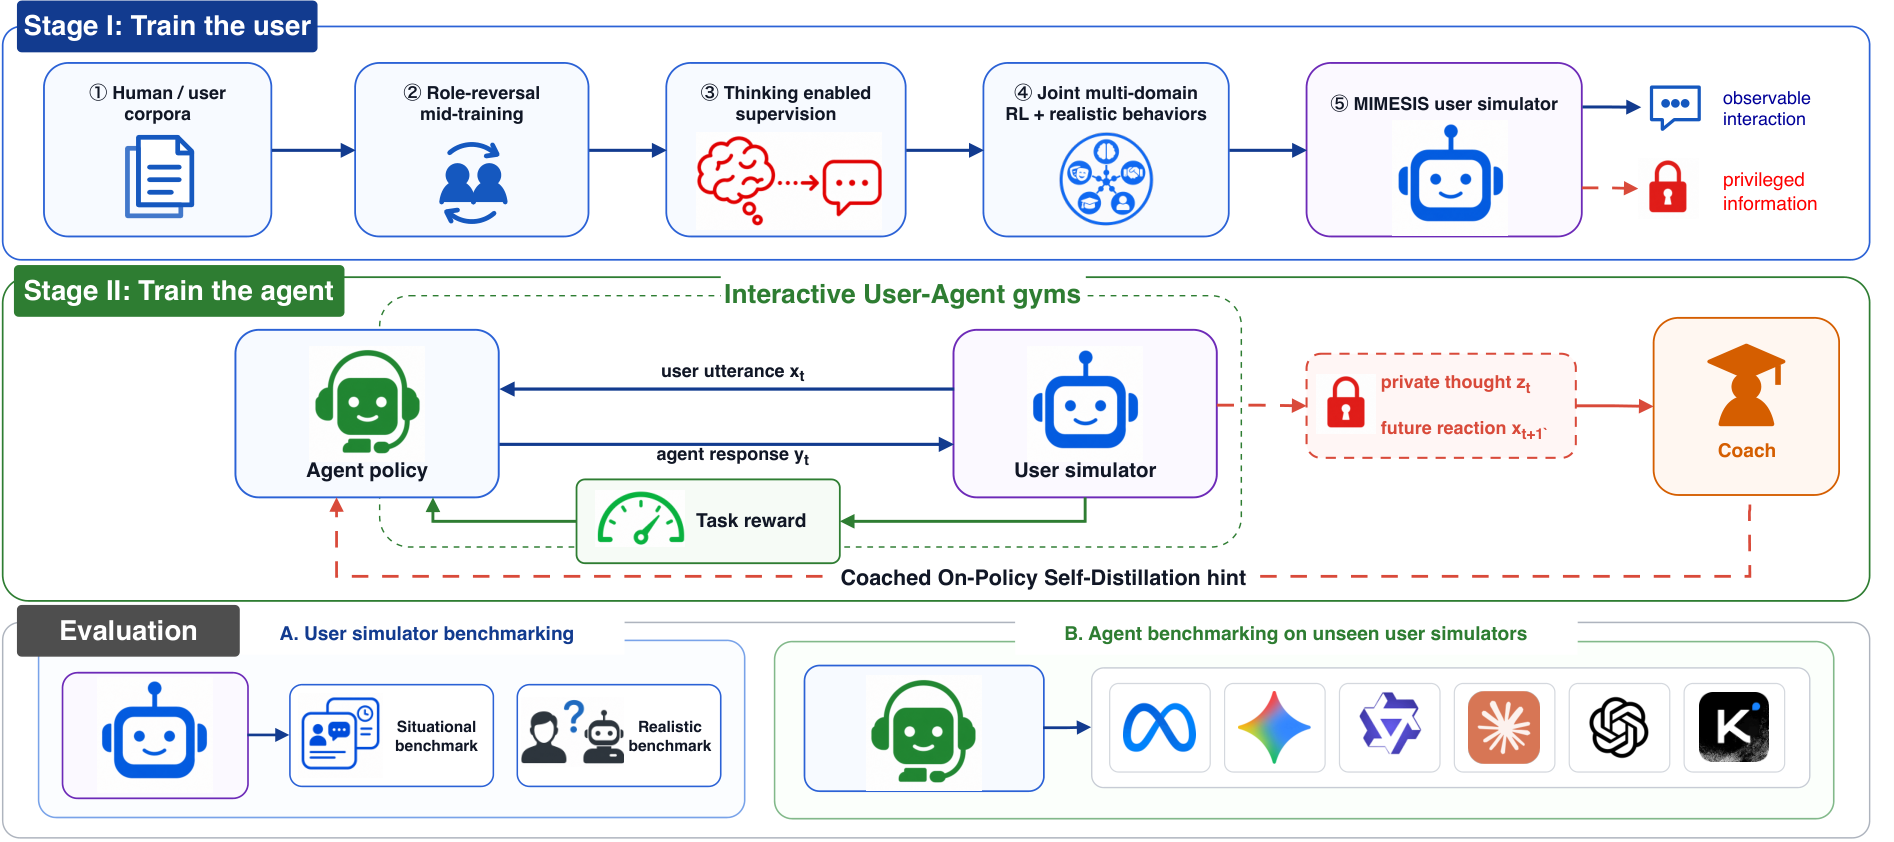
Figure 3 — MIMESIS 프레임워크 개요
4. Conclusion & Impact (결론 및 시사점)
본 논문은 행동적으로 정교한 사용자 시뮬레이터인 MIMESIS가 대화형 에이전트의 일반화 및 학습 효율성에 미치는 긍정적인 영향을 입증하였다. 특히, 정적인 데이터 모방을 넘어 인간 사용자의 복잡한 행동과 추론 과정을 반영한 시뮬레이터가 왜 필수적인지를 명확히 하였다. 본 연구에서 제안된 CSD 방법론은 시뮬레이터의 잠재적 피드백을 에이전트 학습에 적극적으로 활용할 수 있는 새로운 길을 제시했다. 이는 향후 에이전트 평가 및 강화를 위한 데이터 생성 프레임워크 구축에 있어 중요한 학술적·기술적 이정표가 될 것으로 기대된다.
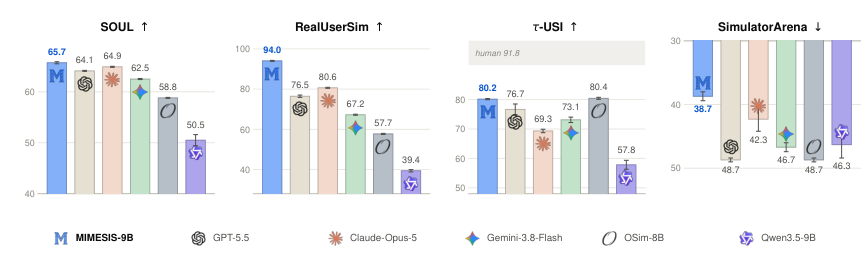
Figure 1 — 시뮬레이터 성능 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Sherpa: Teaching LLMs to Teach Adaptively
- [논문리뷰] StudentSim: Training LLM-based Student Simulators
- [논문리뷰] TurnSight: Turn-Level Hindsight Self-Distillation for Tool-Integrated Reasoning
- [논문리뷰] Healthcare AI GYM for Medical Agents
- [논문리뷰] InfoPO: Information-Driven Policy Optimization for User-Centric Agents
Review 의 다른글
- 이전글 [논문리뷰] Long-WAM: Scaling the Context of World-Action Models
- 현재글 : [논문리뷰] MIMESIS: Learning User Simulators as Training Environments for Interactive Agents
- 다음글 [논문리뷰] Mechanics of Long-Context Hybrid Models Part 1.1: From Hybrid Attention to Hybrid Position
댓글