[논문리뷰] VIEScore2: Unified Image Evaluation with Spatially Grounded Explanations
링크: 논문 PDF로 바로 열기
메타데이터
저자: Xianda Du, Max Ku, Weiming Ren, Zhi Rui Tam, Chunlin Ren, Ping Nie, Min-Hung Chen, Wenhu Chen
1. Key Terms & Definitions (핵심 용어 및 정의)
- VIEScore2: 이미지 생성 및 편집 작업의 품질 평가와 결함 위치 파악을 동시에 수행하는 통합 평가 모델입니다.
- Sparse Grid Representation: 이미지를 $N \times N$ 그리드로 분할하여 결함 위치를 희소한 텍스트 시퀀스 형태로 표현하는 방식입니다.
- GRPO (Group Relative Policy Optimization): 모델이 생성한 여러 응답 중에서 더 높은 보상을 받은 응답을 강화하는 후속 학습(Post-training) 기법입니다.
- Parameter-Free Parser: 모델이 생성한 구조화된 텍스트 출력을 별도의 추가 학습 없이 자연어 설명으로 변환하는 규칙 기반 모듈입니다.
- Dice Reward: 결함 위치의 예측값과 정답(Ground Truth) 사이의 중첩도를 계산하여 모델 학습에 활용하는 지표입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 이미지 평가 모델들이 스칼라 점수만 제공할 뿐, 결함이 발생한 구체적인 이미지 영역을 명확히 설명하지 못하는 문제를 해결하고자 합니다. 대부분의 평가 방식은 전역적인 품질 점수(scalar score)에 의존하거나, 텍스트-이미지 생성 평가에만 국한되어 이미지 편집 및 조건부 생성 작업에서의 유연한 평가가 어렵다는 한계가 있습니다. 또한, 기존 공간 평가 기법들은 태스크별로 별도의 예측 헤드를 필요로 하는 경우가 많아 확장성과 범용성이 부족합니다 [Figure 2]. 이러한 맥락에서 저자들은 이미지 생성 및 편집 전반을 아우르는 통합적이고 공간적으로 근거가 확실한(spatially grounded) 평가 프레임워크인 VIEScore2를 제안합니다.
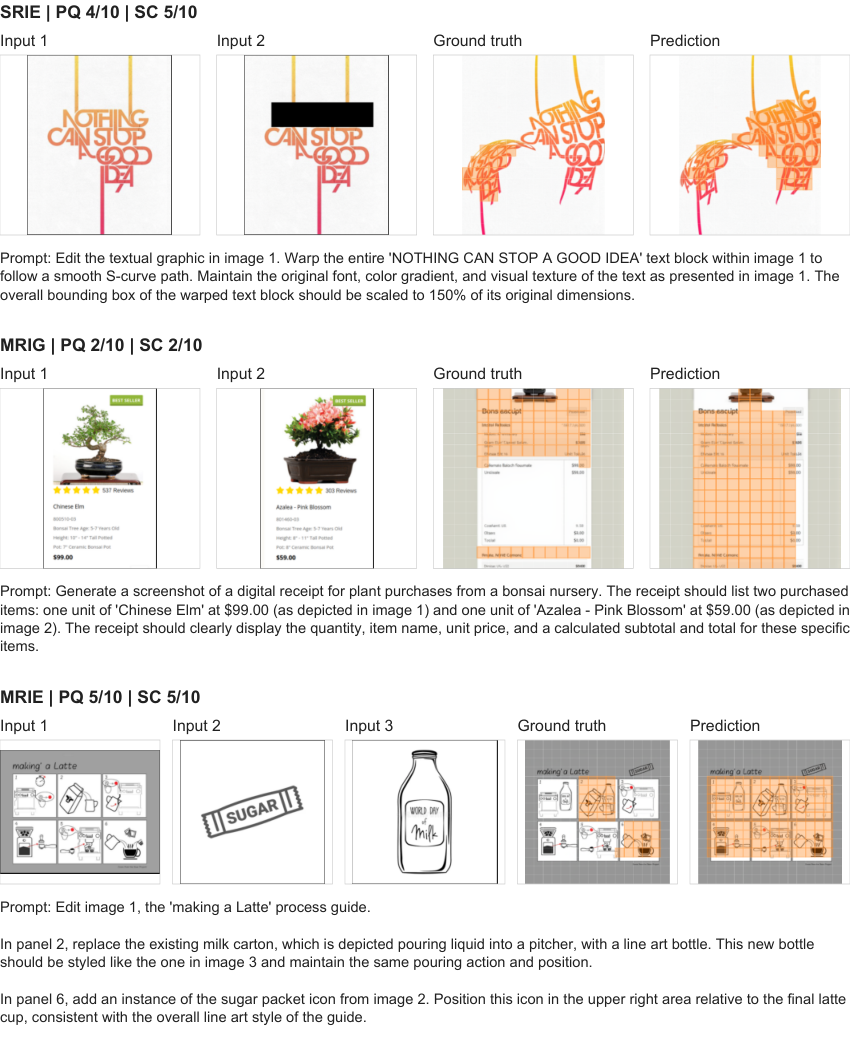
Figure 2 — VIEScore2 전체 파이프라인
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 VLM(Vision-Language Model) 기반의 VIEScore2를 도입하여 품질 점수와 결함 위치를 단일 모델에서 추론하는 통합 프레임워크를 구축하였습니다. 저자들은 먼저 Supervised Fine-Tuning(SFT)을 통해 다양한 데이터 소스로부터 품질 점수와 결함 그리드를 생성하도록 모델을 학습시킨 후, GRPO를 적용하여 결함 위치 정확도를 개선하였습니다 [Figure 2]. 특히, Sparse Grid Representation을 활용하여 시각적 결함과 의미적 불일치를 분리된 그리드로 예측하며, Dice reward를 통해 지역적 결함 위치 파악 능력을 최적화하였습니다. 주요 실험 결과, VIEScore2는 프라이머리 평가 셋에서 전체 점수 상관관계(SRCC) 0.601을 기록하며, 동일 조건 하의 Gemini-3-Flash(0.491) 대비 우수한 성능을 입증하였습니다. 결함 위치 파악 작업에서도 6개의 벤치마크 중 3개에서 최고의 IoU 성능을 보였으며, 전반적으로 상위권의 평가 정확도를 유지하였습니다 [Table 1], [Figure 3].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 통합된 공간적 근거 기반의 평가 방식이 이미지 생성 및 편집 모델의 품질 향상에 필수적임을 입증하며 VIEScore2라는 범용 평가 도구를 제시하였습니다. 학습된 Sparse Grid Representation과 GRPO 기반의 강화 학습은 복잡한 공간적 정보를 효율적으로 다룰 수 있는 프레임워크로서, 이미지 합성 분야의 정량적 평가를 한 단계 발전시켰습니다. 이러한 연구 결과는 자동화된 이미지 품질 평가뿐만 아니라, 향후 모델의 오류 진단 및 디버깅을 위한 필수적인 도구로 활용될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Program-Verified Self-Evolution for Vision-Language Models
- [논문리뷰] VaseMuseum: Digital Intelligent Museum for Ancient Greek Pottery
- [논문리뷰] Rank-Then-Act: Reward-Free Control from Frame-Order Progress
- [논문리뷰] Agent Explorative Policy Optimization for Multimodal Agentic Reasoning
- [논문리뷰] TRivia: Self-supervised Fine-tuning of Vision-Language Models for Table Recognition
Review 의 다른글
- 이전글 [논문리뷰] UniWAM: Unified World-Action Model
- 현재글 : [논문리뷰] VIEScore2: Unified Image Evaluation with Spatially Grounded Explanations
- 다음글 [논문리뷰] VepAgent: Bridging Causal-Transition via Tool-Augmented Reinforcement Learning for Video Event Prediction
댓글