[논문리뷰] VepAgent: Bridging Causal-Transition via Tool-Augmented Reinforcement Learning for Video Event Prediction
링크: 논문 PDF로 바로 열기
메타데이터
저자: Qiutong Chen, Yuchan Guo, Zhenlong Yuan, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- VEP (Video Event Prediction): 부분적으로 관찰된 시각적 정보를 바탕으로 미래의 이벤트를 예측하는 과제입니다.
- Causal-Transition Reasoning: 단순히 과거 데이터를 요약하는 대신, 관찰된 최종 상태에서 미래 이벤트로 이어지는 인과적 논리 과정을 명시적으로 모델링하는 추론 방식입니다.
- Diagnostic Tool Library: 상태 추적(State Tracking), 프레임 검색, 영역 확대 등을 수행하여 모델이 부족한 시공간적 증거를 보완하도록 돕는 외부 도구 모음입니다.
- GRPO (Group Relative Policy Optimization): 그룹 단위의 응답 비교를 통해 정책을 최적화하는 강화학습 알고리즘으로, 본 논문에서는 에이전트의 의사결정 과정을 개선하는 데 사용됩니다.
- Anti-Prior Reward: 모델이 데이터의 언어적 편향(Language-Prior)에 의존하는 것을 방지하고, 시각적 증거에 기반한 추론을 하도록 유도하는 보상 함수 구성 요소입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 MLLM 기반의 VEP 접근 방식이 가진 세 가지 근본적인 한계를 해결하고자 합니다. 첫째, 모델이 인과적 논리(Causal-Logic)를 제대로 모델링하지 못하고 단순히 과거의 사건을 되풀이하는 수준에 머무르는 'Causal-Logic Gap' 문제입니다. 둘째, 시각적 정보보다 문제와 선택지 간의 텍스트 유사성에 의존하는 'Language-Prior Shortcut' 현상이 심각합니다. 마지막으로, 실제 영상 데이터에서의 occlusions나 샘플링 문제로 인한 시각적 정보의 누락이 모델의 정확도를 저해합니다 [Figure 1]. 이러한 문제들은 모델이 정적인 관찰자에 머물게 하여 복잡한 미래 사건 예측을 어렵게 만듭니다.
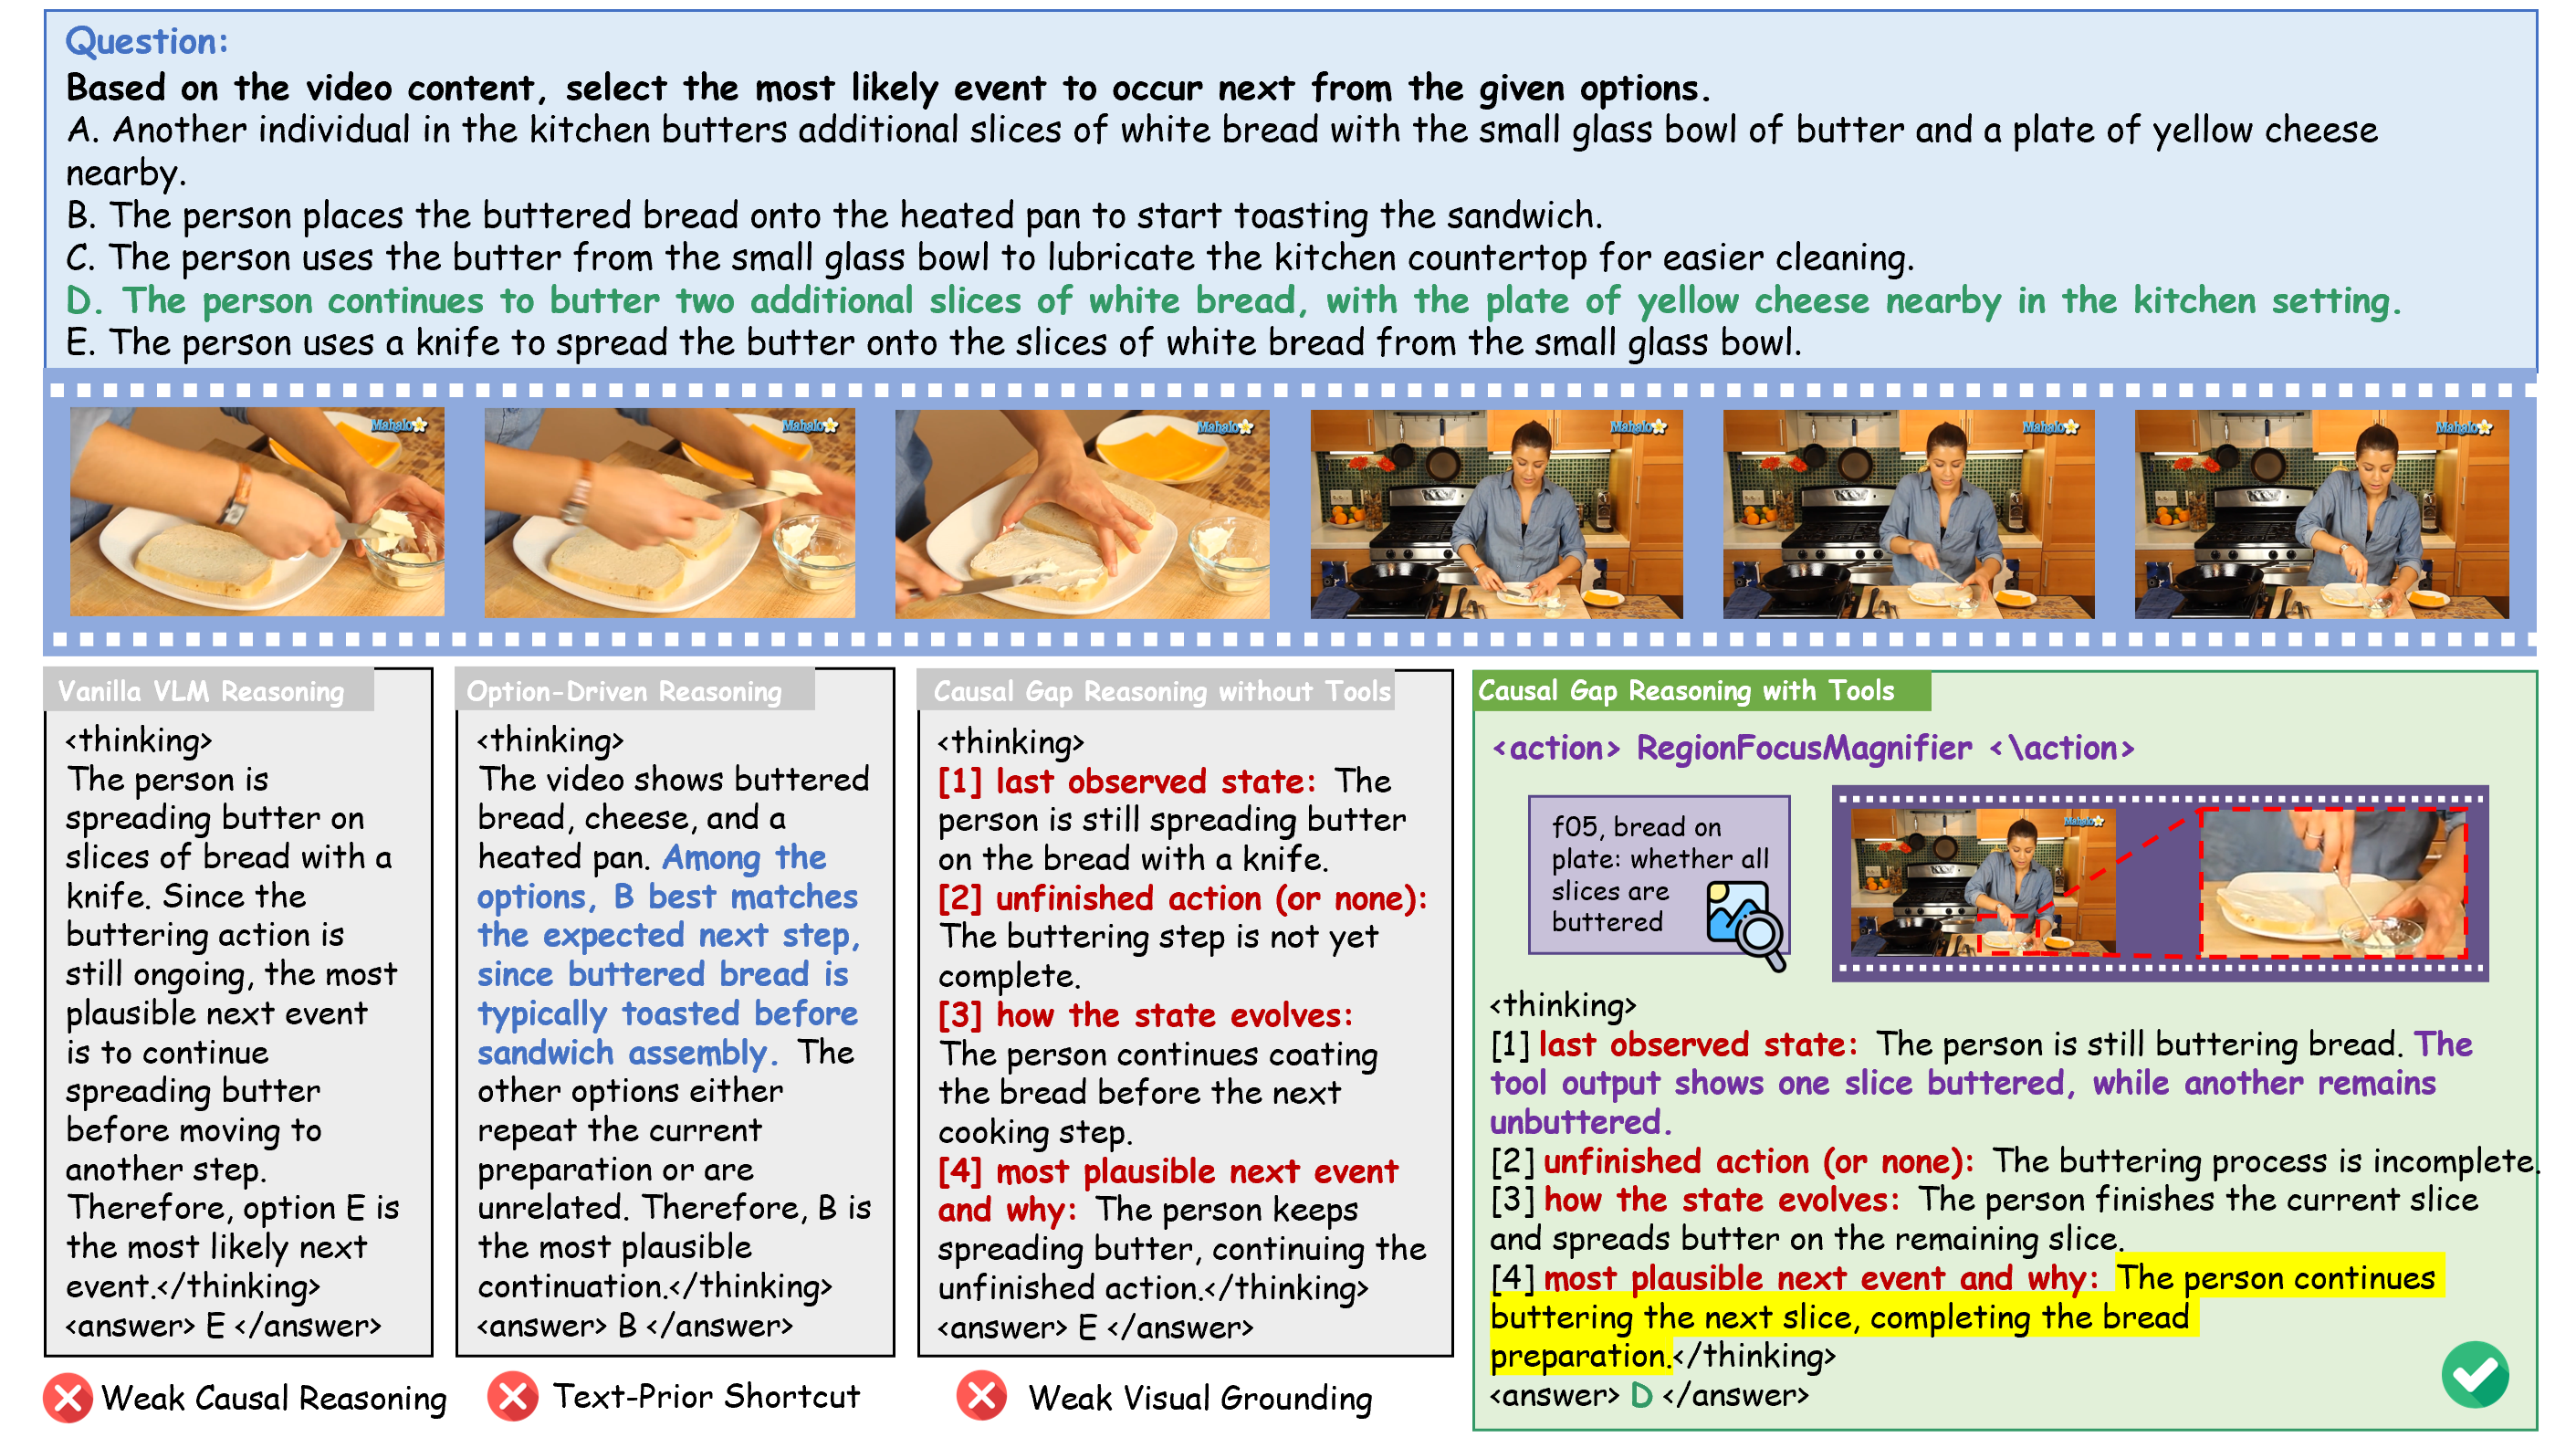
Figure 1 — VepAgent의 핵심 통찰
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 causal-transition reasoning과 tool-augmented RL을 결합한 에이전트 프레임워크인 VepAgent를 제안합니다 [Figure 2]. VepAgent는 먼저 futurebench-4K 데이터셋을 사용하여 SFT(Supervised Fine-Tuning)를 거친 후, GRPO를 기반으로 한 RL 학습을 진행합니다. 학습 과정에서 모델은 Diagnostic Tool Library [Figure 3]를 선택적으로 사용하여 필요한 시공간적 증거를 동적으로 확보합니다. 또한, Accuracy, Causal-Gap, Anti-Prior Reward를 조합한 복합 보상 체계를 통해 모델의 시각적 근거 기반 추론을 극대화합니다. 실험 결과, VepAgent (4B)는 FutureBench에서 평균 정확도 81.44%를 달성하여 기존 최상위 모델 대비 14.58%p 향상된 성능을 보였습니다 [Table 1]. NEPBench에서도 전체 정확도 70.20%를 기록하며 기존 최고 성능 모델 대비 22.70%p의 압도적인 우위를 점했습니다 [Table 2].
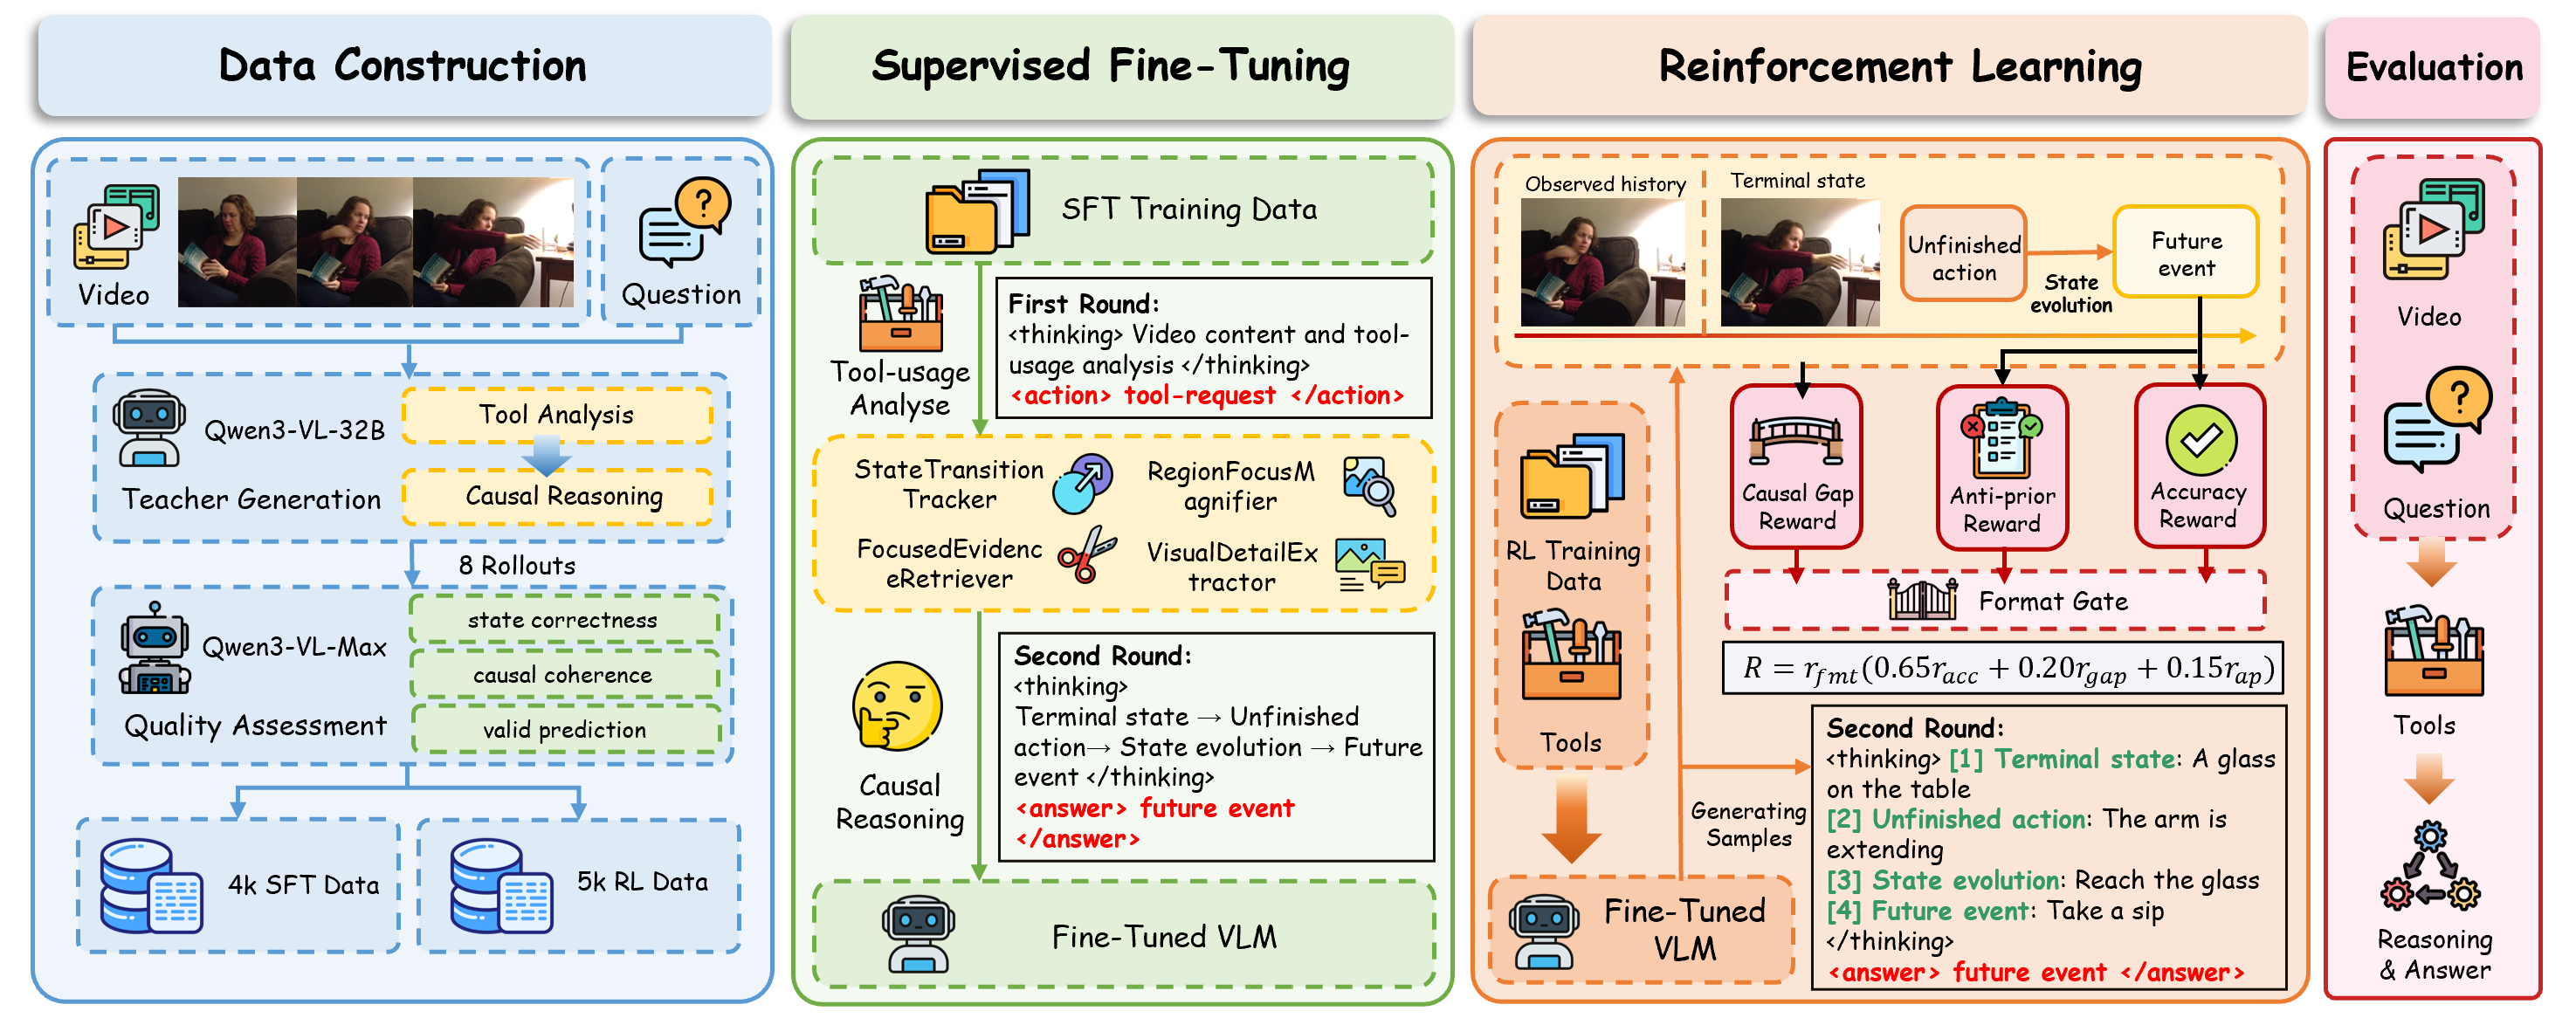
Figure 2 — VepAgent의 전체 파이프라인
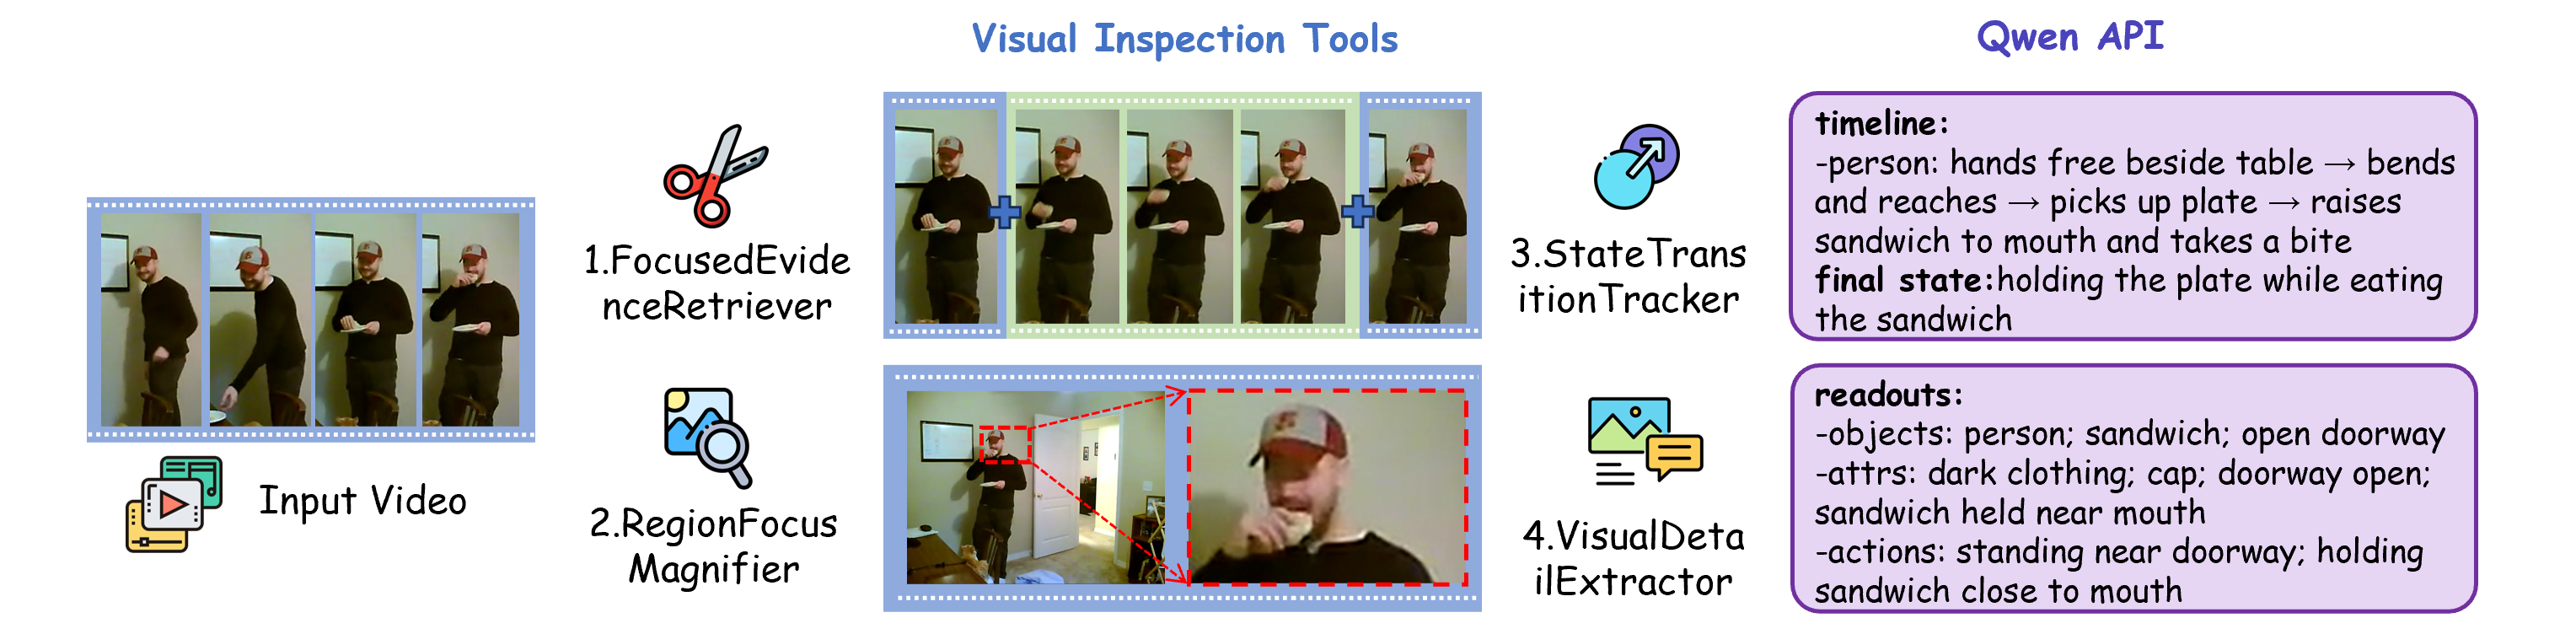
Figure 3 — VepAgent의 진단 도구 라이브러리
4. Conclusion & Impact (결론 및 시사점)
본 연구는 VEP를 단순한 미래 예측이 아닌, 인과적 추론과 도구 사용이 결합된 능동적인 과정으로 재정의하였습니다. VepAgent는 대규모 모델이 아님에도 불구하고 도구 활용과 강화학습을 통해 시각적 증거에 기반한 강력한 미래 예측 성능을 입증했습니다. 이 프레임워크는 MLLM이 언어적 편향에서 벗어나 실제 시각적 세계의 인과성을 이해하는 데 기여하며, 향후 로보틱스나 자율주행과 같이 동적인 환경에서의 비디오 이해 기술 발전에 중요한 토대를 제공할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Imagine Before You Predict: Interleaved Latent Visual Reasoning for Video Event Prediction
- [논문리뷰] IndusAgent: Reinforcing Open-Vocabulary Industrial Anomaly Detection with Agentic Tools
- [논문리뷰] OmniSeek: Native Tool Integration for Multi-turn Audio-Visual Reasoning
- [논문리뷰] Not All Prompts Are Equal: Exploration-Guided Prompt Scaffolding for Multimodal Reinforcement Post-Training
- [논문리뷰] Annotations as Rollouts: Efficient and Scalable Reinforcement Learning for Video MLLMs
Review 의 다른글
- 이전글 [논문리뷰] VIEScore2: Unified Image Evaluation with Spatially Grounded Explanations
- 현재글 : [논문리뷰] VepAgent: Bridging Causal-Transition via Tool-Augmented Reinforcement Learning for Video Event Prediction
- 다음글 [논문리뷰] WebFovea: When the Model Is Right but the Click Is Wrong -- Reliable Round Trips for Vision-Based Web Agents on Live Websites
댓글