[논문리뷰] SpaceCast-Bench: Evaluating Predictive Spatial Reasoning in Vision-Language Models
링크: 논문 PDF로 바로 열기
메타데이터
저자: Hongxing Li, Jinyue Su, Dingming Li, Wenqi Zhang, Weiming Lu, Jun Xiao, Yueting Zhuang, Yongliang Shen
1. Key Terms & Definitions (핵심 용어 및 정의)
- Predictive Spatial Reasoning: 단순히 관찰된 장면의 관계를 파악하는 것을 넘어, 특정 개입(Intervention)이 일어난 후의 결과를 시뮬레이션하고 추론하는 고차원적 공간 지능 능력입니다.
- Observe–Transform–Infer Framework: 관찰(Observe)을 통해 장면을 재구성하고, 변환(Transform)을 적용한 뒤, 보이지 않는 결과 상태에서 추론(Infer)을 수행하는 본 연구의 핵심 방법론입니다.
- Bridge Views: 공간적으로 분산된 여러 관찰 지점(Anchor views) 사이를 연결하며, 깊이 정보(Depth-verified)가 검증된 연속적인 뷰 시퀀스를 의미합니다.
- Spatial State Updating: 장면 내 물체의 움직임이나 물리적 개입이 발생했을 때, 모델이 기존의 내부 장면 표현을 최신 상태로 업데이트하는 과정을 지칭합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 Vision-Language Model(VLM) 평가 체계가 단순한 공간 지각(Spatial Perception)에 치중되어 있어, 실제 환경에서 필수적인 예측적 공간 추론 능력을 측정하지 못한다는 한계를 지적합니다 [Figure 1]. 기존 벤치마크들은 고정된 장면 내의 관계를 읽어내는 수준에 머물러 있어, 행동의 결과를 미리 시뮬레이션해야 하는 로봇 조작이나 계획 수립 등의 복잡한 과업을 평가하는 데 부족합니다. 저자들은 이를 해결하기 위해 SpaceCast-Bench를 제안하며, 3,862개의 질문을 통해 모델의 장면 이해, 공간 상태 업데이트, 추론 능력을 진단하고자 합니다 [Figure 3].
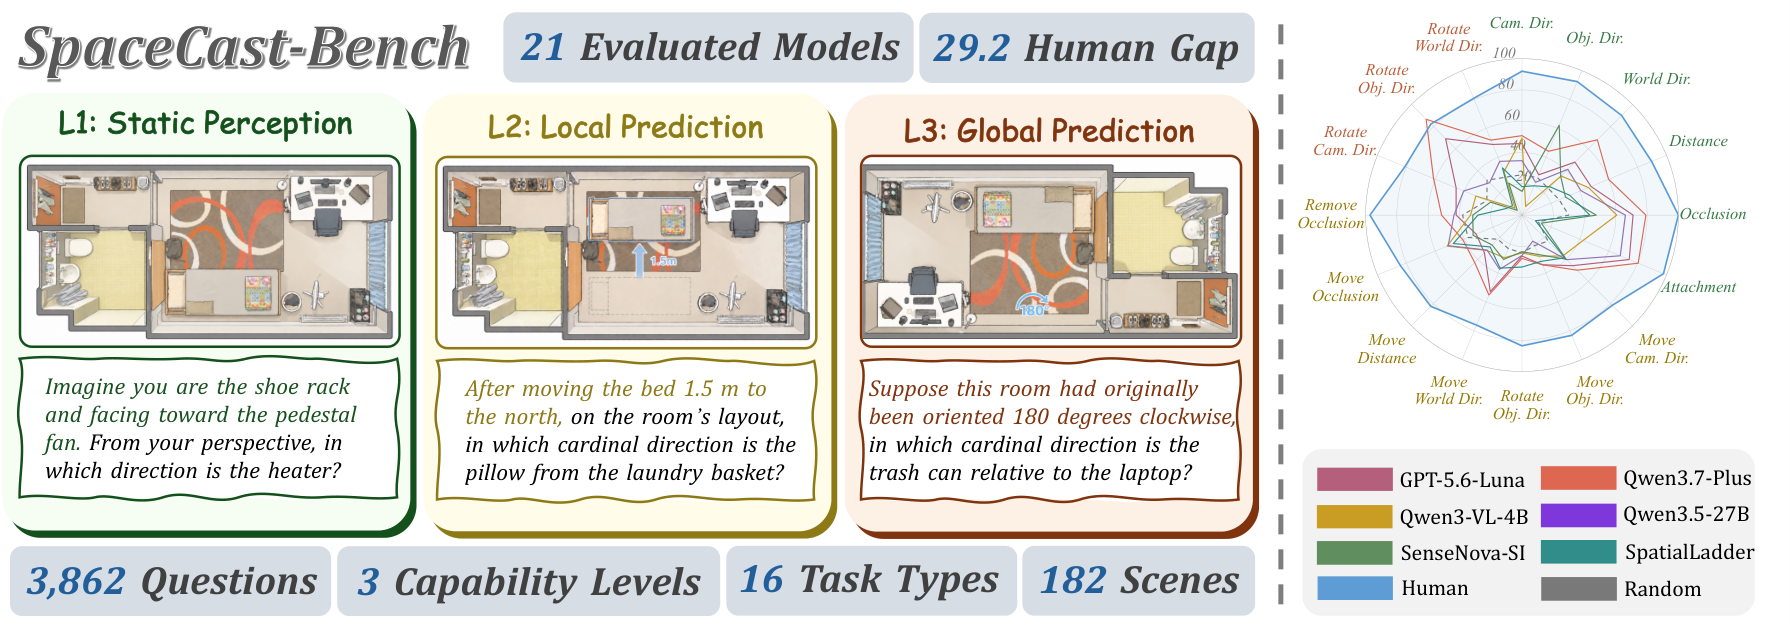
Figure 1 — SpaceCast-Bench 개요 및 과업 예시
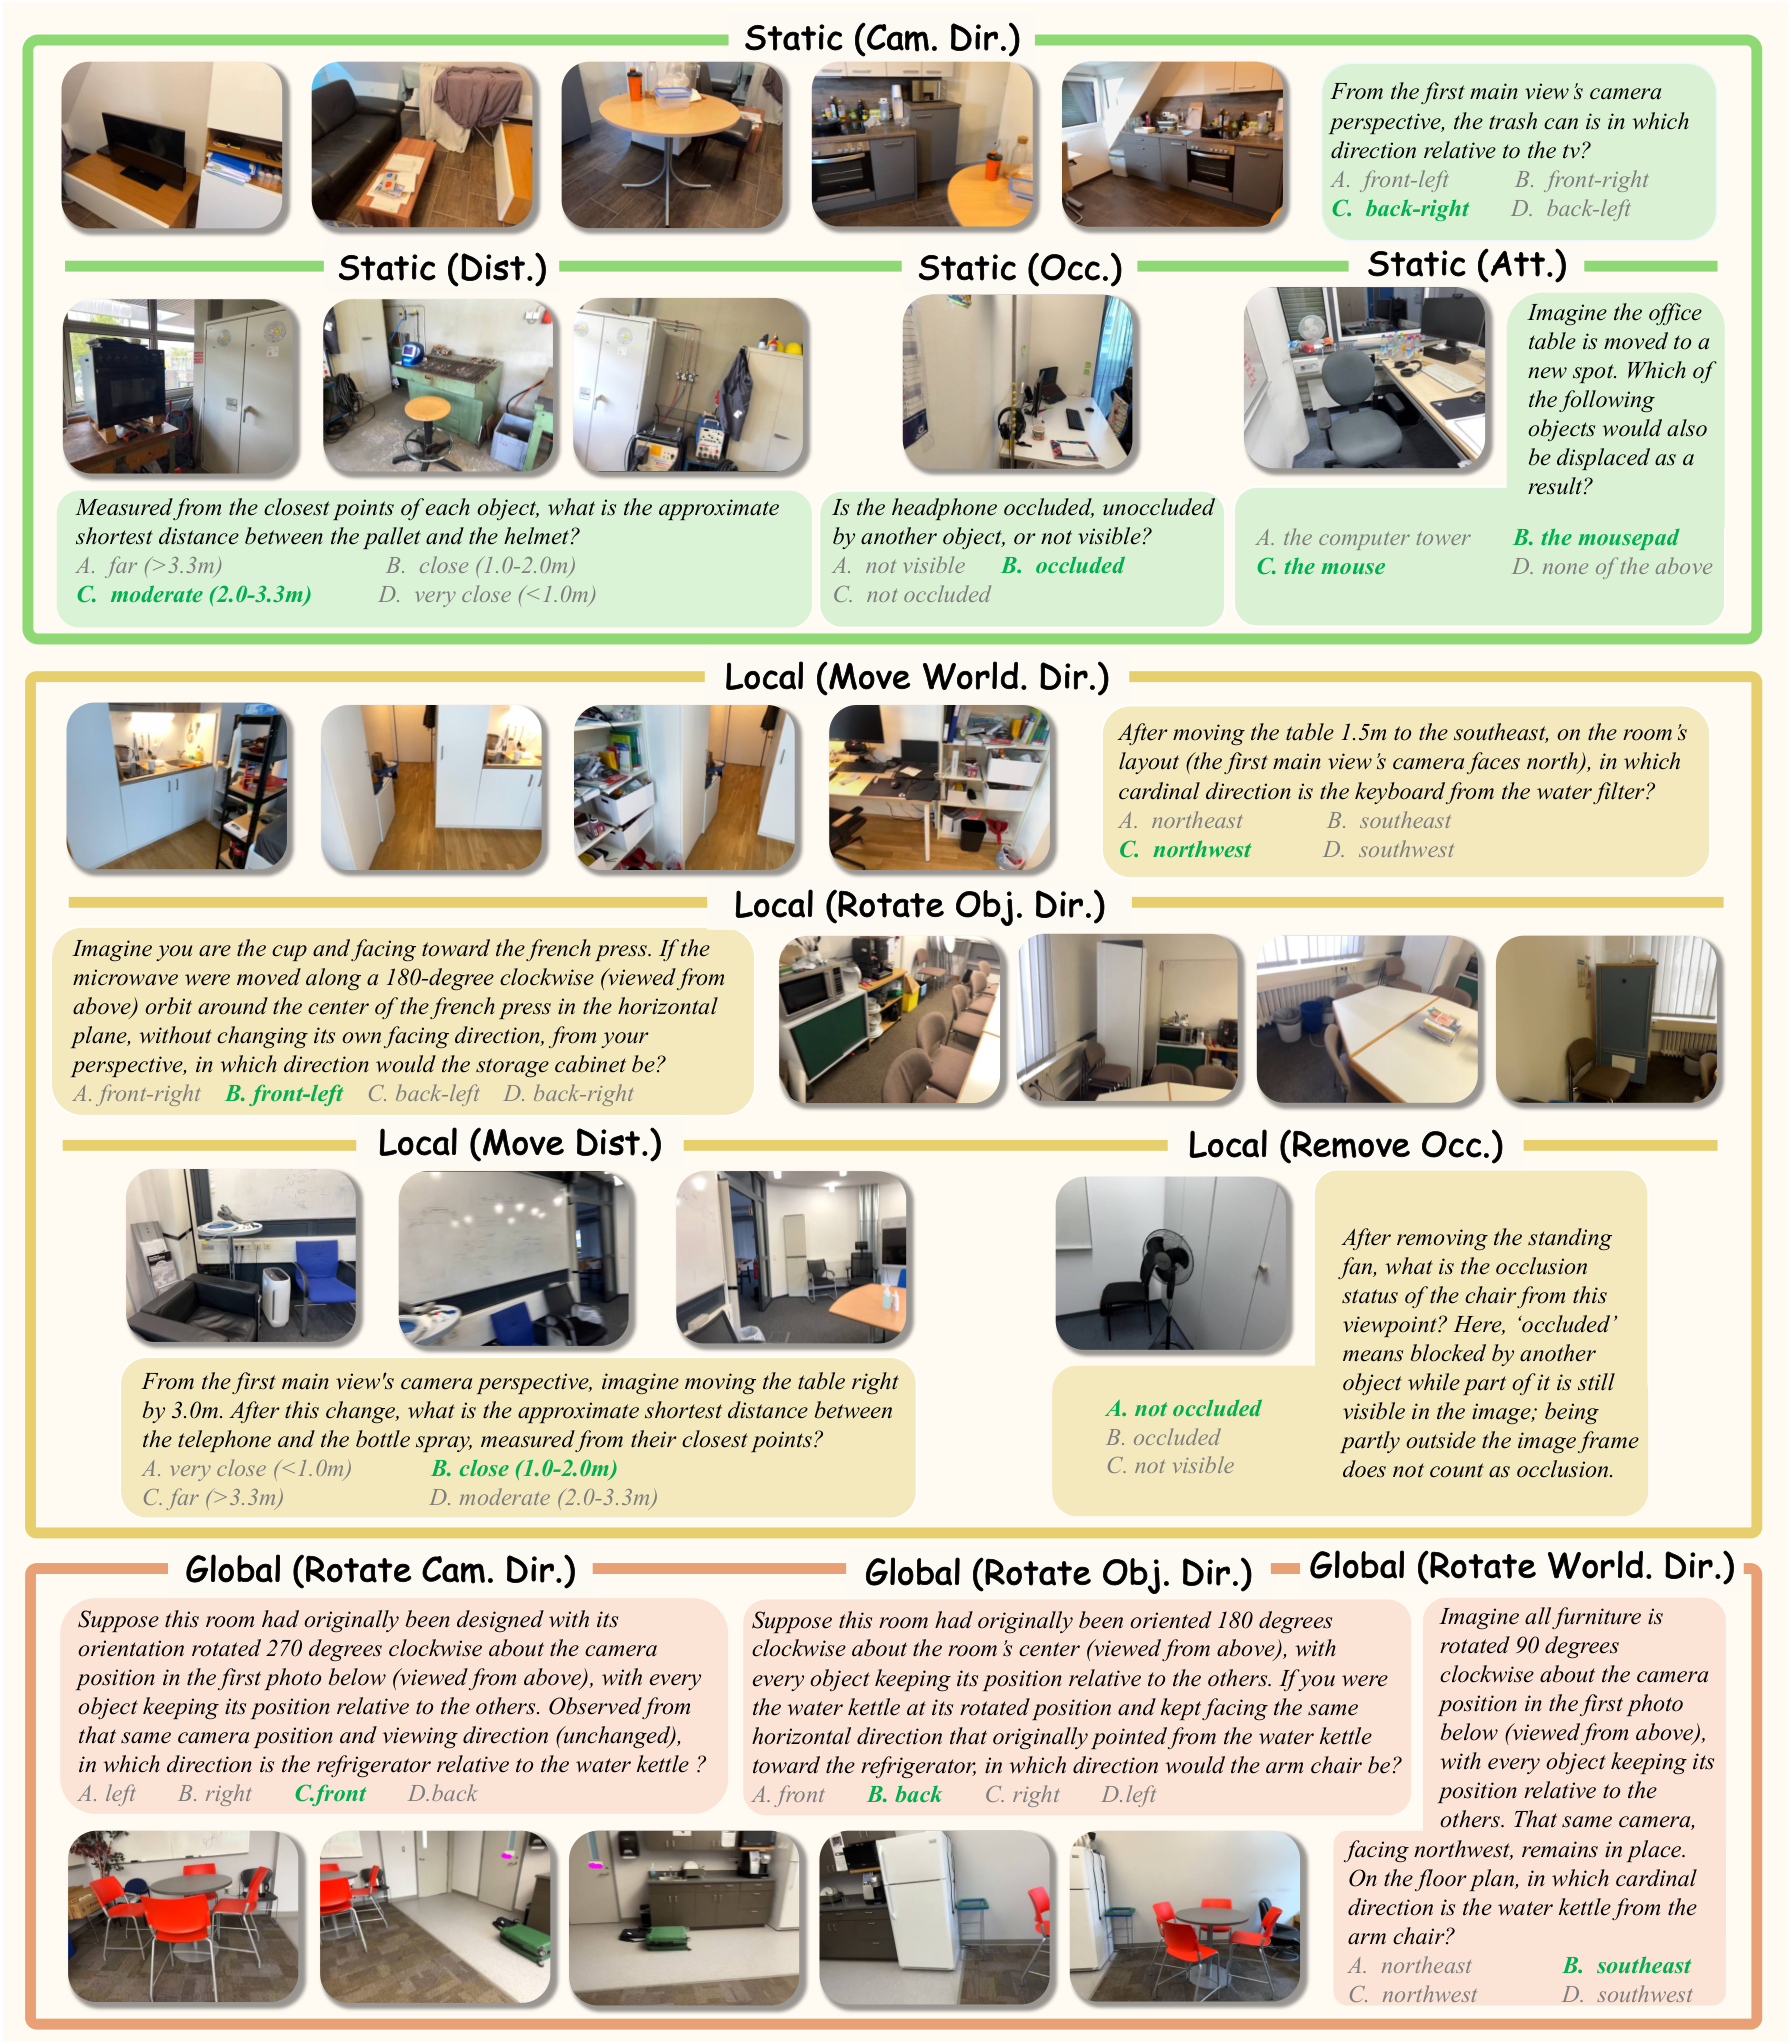
Figure 3 — 주요 과업 및 공간 추론 예시
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 ScanNet과 ScanNet++ 기반의 3D 지오메트리를 활용하여 16개 과업 유형을 포함하는 SpaceCast-Bench를 구축하였습니다. 이 벤치마크는 Static Perception(L1), Local Prediction(L2), Global Prediction(L3)의 3단계 난이도로 구성되며, 각 과업은 3D 변환을 포함하여 프로그래밍 방식으로 정답을 생성합니다 [Figure 2, Figure 4]. 21개 모델을 대상으로 실험한 결과, 최고 성능을 보인 모델조차 58.0%의 정확도를 기록하여 인간의 87.2%에 크게 미치지 못함을 확인했습니다 [Table 1]. 특히, Bridge View를 통해 정보를 통합하는 방식이 모델의 추론 성능을 향상시키는 데 필수적임을 증명하였습니다 [Figure 6]. 또한, Qwen3-VL-4B 모델에 본 데이터를 사용하여 Fine-tuning을 진행한 결과, 정확도를 기존 34.0%에서 65.7%까지 향상시켰으며, 다른 6개의 Out-of-domain 벤치마크에서도 일관된 성능 개선을 입증하였습니다 [Table 4].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 VLM의 예측적 공간 추론 능력을 최초로 체계적으로 평가하는 벤치마크를 제공하여, 현존하는 모델들의 공간 지각과 예측 능력 사이의 커다란 간극을 명확히 드러냈습니다. 연구 결과, 외부의 explicit 3D 증거를 활용하는 것이 모델의 추론 성능 향상에 매우 효과적임을 밝혔습니다. 이 연구는 향후 Embodied AI 및 Spatial World Model 연구에 있어 핵심적인 평가 지표와 학습 파이프라인을 제공함으로써, VLM이 물리 세계를 더 깊이 이해하고 조작할 수 있는 방향으로 발전하는 데 중요한 기여를 할 것으로 기대됩니다.
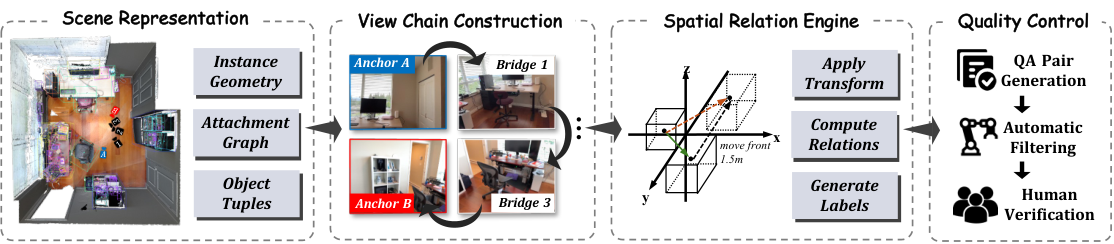
Figure 2 — 벤치마크 구축 파이프라인
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] WorldAuditBench: Interactive 3D World Auditing with Multimodal Agents
- [논문리뷰] Knowing What Not to Answer: Selective Non-Compliance in Vision-Language Models
- [논문리뷰] JigShape: Evaluating Visual-Geometric Reasoning in VLMs through Jigsaw Puzzles
- [논문리뷰] SmartMage: Dynamic Modality Orchestration for 3D Scene Understanding
- [논문리뷰] RoboDojo: A Unified Sim-and-Real Benchmark for Comprehensive Evaluation of Generalist Robot Manipulation Policies
Review 의 다른글
- 이전글 [논문리뷰] Scaling to Tens of Thousands of Test-Time Iterations with Loop-Native Attention Residuals
- 현재글 : [논문리뷰] SpaceCast-Bench: Evaluating Predictive Spatial Reasoning in Vision-Language Models
- 다음글 [논문리뷰] SpaceFlow: Locally Controllable 3D Generation
댓글