[논문리뷰] VABench: Measuring Embodied Spatial Intelligence through Visual Demonstrations, Active Perception, and Metric Control
링크: 논문 PDF로 바로 열기
저자: Zhongbo Zhang, Jiayi Jin, Yifan Wang, Zaibin Zhang, Haiwen Diao, Lijun Wang, Huchuan Lu
1. Key Terms & Definitions (핵심 용어 및 정의)
- Spatial Intelligence: 불완전한 관찰(partial observability) 환경에서 누락된 증거(missing evidence)를 식별하고 획득하며, 이를 공통 공간 프레임(common spatial frame)으로 해석하여 행동하는 능력. 특히 조작(manipulation) 작업에서 객체와 로봇 간의 metric 관계를 파악하는 데 필수적이다.
- VABench (Vision-Action Benchmark): MLLM이 시각적 데모를 통해 절차적 맥락(procedural context)을 학습하고, active camera viewpoint를 선택하며, metric Cartesian commands를 발행하고, 실행 피드백으로부터 이를 수정하는 observe–reason–act–revise 루프 전체를 평가하는 물리 시뮬레이션 기반의 벤치마크이다.
- Metric Cartesian Commands: MLLM이 직접 생성하는 세계 좌표계(world coordinates) 기반의 수치적 로봇 움직임 명령이다. 이는 미리 정의된 스킬(predefined skills)이나 학습된 액션 헤드(learned action heads) 없이 MLLM이 공간적 판단을 로봇의 metric motion으로 변환하는 능력을 평가한다.
- Active Perception: 모델이 태스크 관련 불확실성(task-relevant uncertainty)을 해결하기 위해 능동적으로 시점(viewpoint)을 선택하고, 시각적 증거(visual evidence)를 획득하는 능력이다. 이 과정에서 관찰은 공유된 액션 예산(shared action budget)을 소모한다.
- Demonstration-conditioned Re-grounding: 성공적인 RGB 데모 비디오를 통해 절차적 컨텍스트를 학습하지만, 현재 테스트 인스턴스에 대한 구체적인 기하학적 정보(geometry) 없이 새로운 장면에 절차를 재적용하여 모든 수치적 액션 파라미터를 생성하는 과정이다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존 연구들은 공간 추론(spatial reasoning), 조작 실행(manipulation execution), 또는 능동적 지각(active perception)을 개별적으로 평가하는 경향이 있었지만, 실제 Embodied AI 에이전트는 이 모든 능력을 통합하여 observe–reason–act–revise 루프를 닫아야 한다. Spatial Intelligence는 단순히 이미지 내 객체 위치를 설명하는 것을 넘어, 불완전한 관찰 환경에서 모델이 누락된 증거를 식별, 획득하며, 이를 공통 공간 프레임에서 해석한 후 행동해야 하는 복합적인 요구 사항을 가진다. 특히 로봇 조작 작업에서 단일 시점만으로는 로봇과 객체 간의 metric 관계가 모호할 수 있고, 픽셀 변위만으로 세계 좌표계에서의 움직임을 결정하기 어렵다. 이러한 한계점은 MLLM이 능동적으로 증거를 획득하고, contact-level spatial estimation을 수행하며, 공간적 판단을 metric robot motion으로 변환하고, 실행 피드백에 따라 행동을 수정하는 완전한 폐쇄 루프 상호작용(closed-loop interaction) 능력을 종합적으로 평가할 새로운 벤치마크의 필요성을 제기한다 [Figure 1]. 기존 벤치마크들은 종종 구조화된 공간 정보, 객체 상태 또는 미리 정의된 실행 구성 요소에 의존하여, 일반 목적 MLLM이 직접 관찰을 선택하고 metric arm commands를 grounding하는 능력을 충분히 테스트하지 못했다.
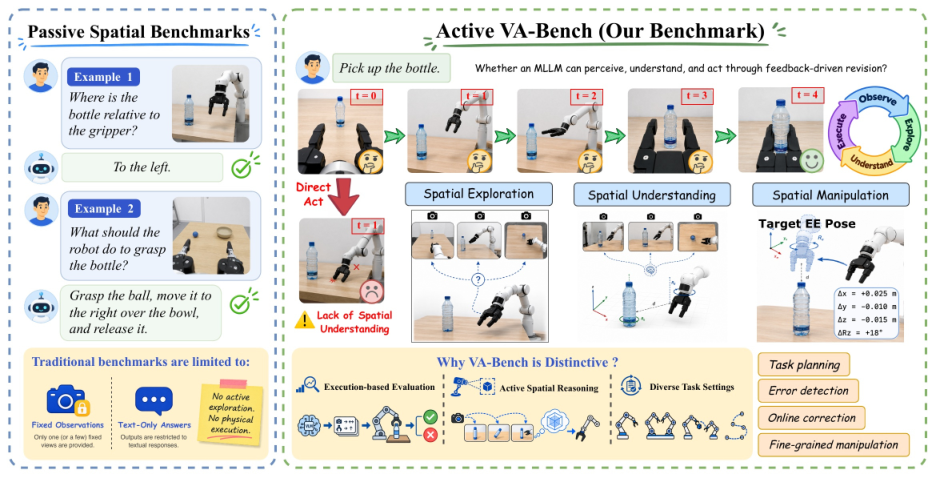
Figure 1 — 평가 목표 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 MLLM의 Embodied Spatial Intelligence를 측정하기 위해 Vision-Action Benchmark, 즉 VA-Bench를 제안한다. VA-Bench는 MLLM이 RGB 데모를 해석하고, 능동적으로 시각적 증거를 획득하며, 이를 metric single- 또는 dual-arm action으로 grounding하고, 실행 결과로부터 해당 action을 수정하는 전체 closed-loop interaction을 평가한다. 벤치마크는 11가지의 single-arm task와 3가지의 dual-arm task를 포함하는 총 14개의 base task family로 구성되며, 각각 20개의 physically verified scene seeds를 사용한다. 모델은 privileged object poses, oracle trajectories, 또는 learned action heads 없이 RGB 관찰과 task instructions만 수신하며, 고정된 model-agnostic controller가 MLLM이 지정한 target만 실행한다. agent harness의 schematic은 [Figure 4]에 도시되어 있다. 또한, 아홉 가지 trajectory-level behavioral diagnostics와 subtask progress measures는 closed loop 내에서 실패 지점을 파악하는 데 활용된다 [Figure 3].
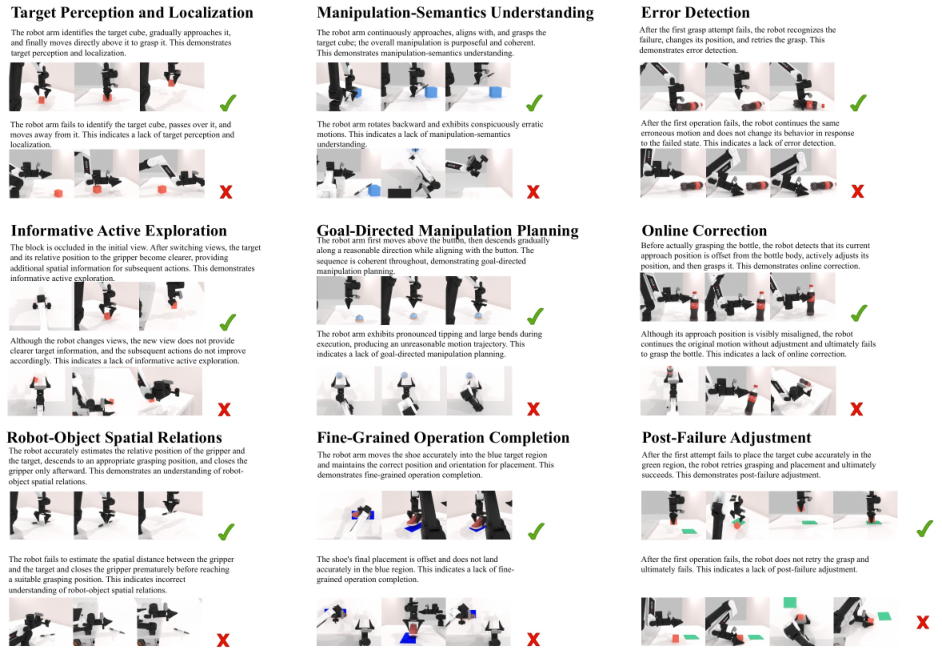
Figure 3 — 진단 기준 예시
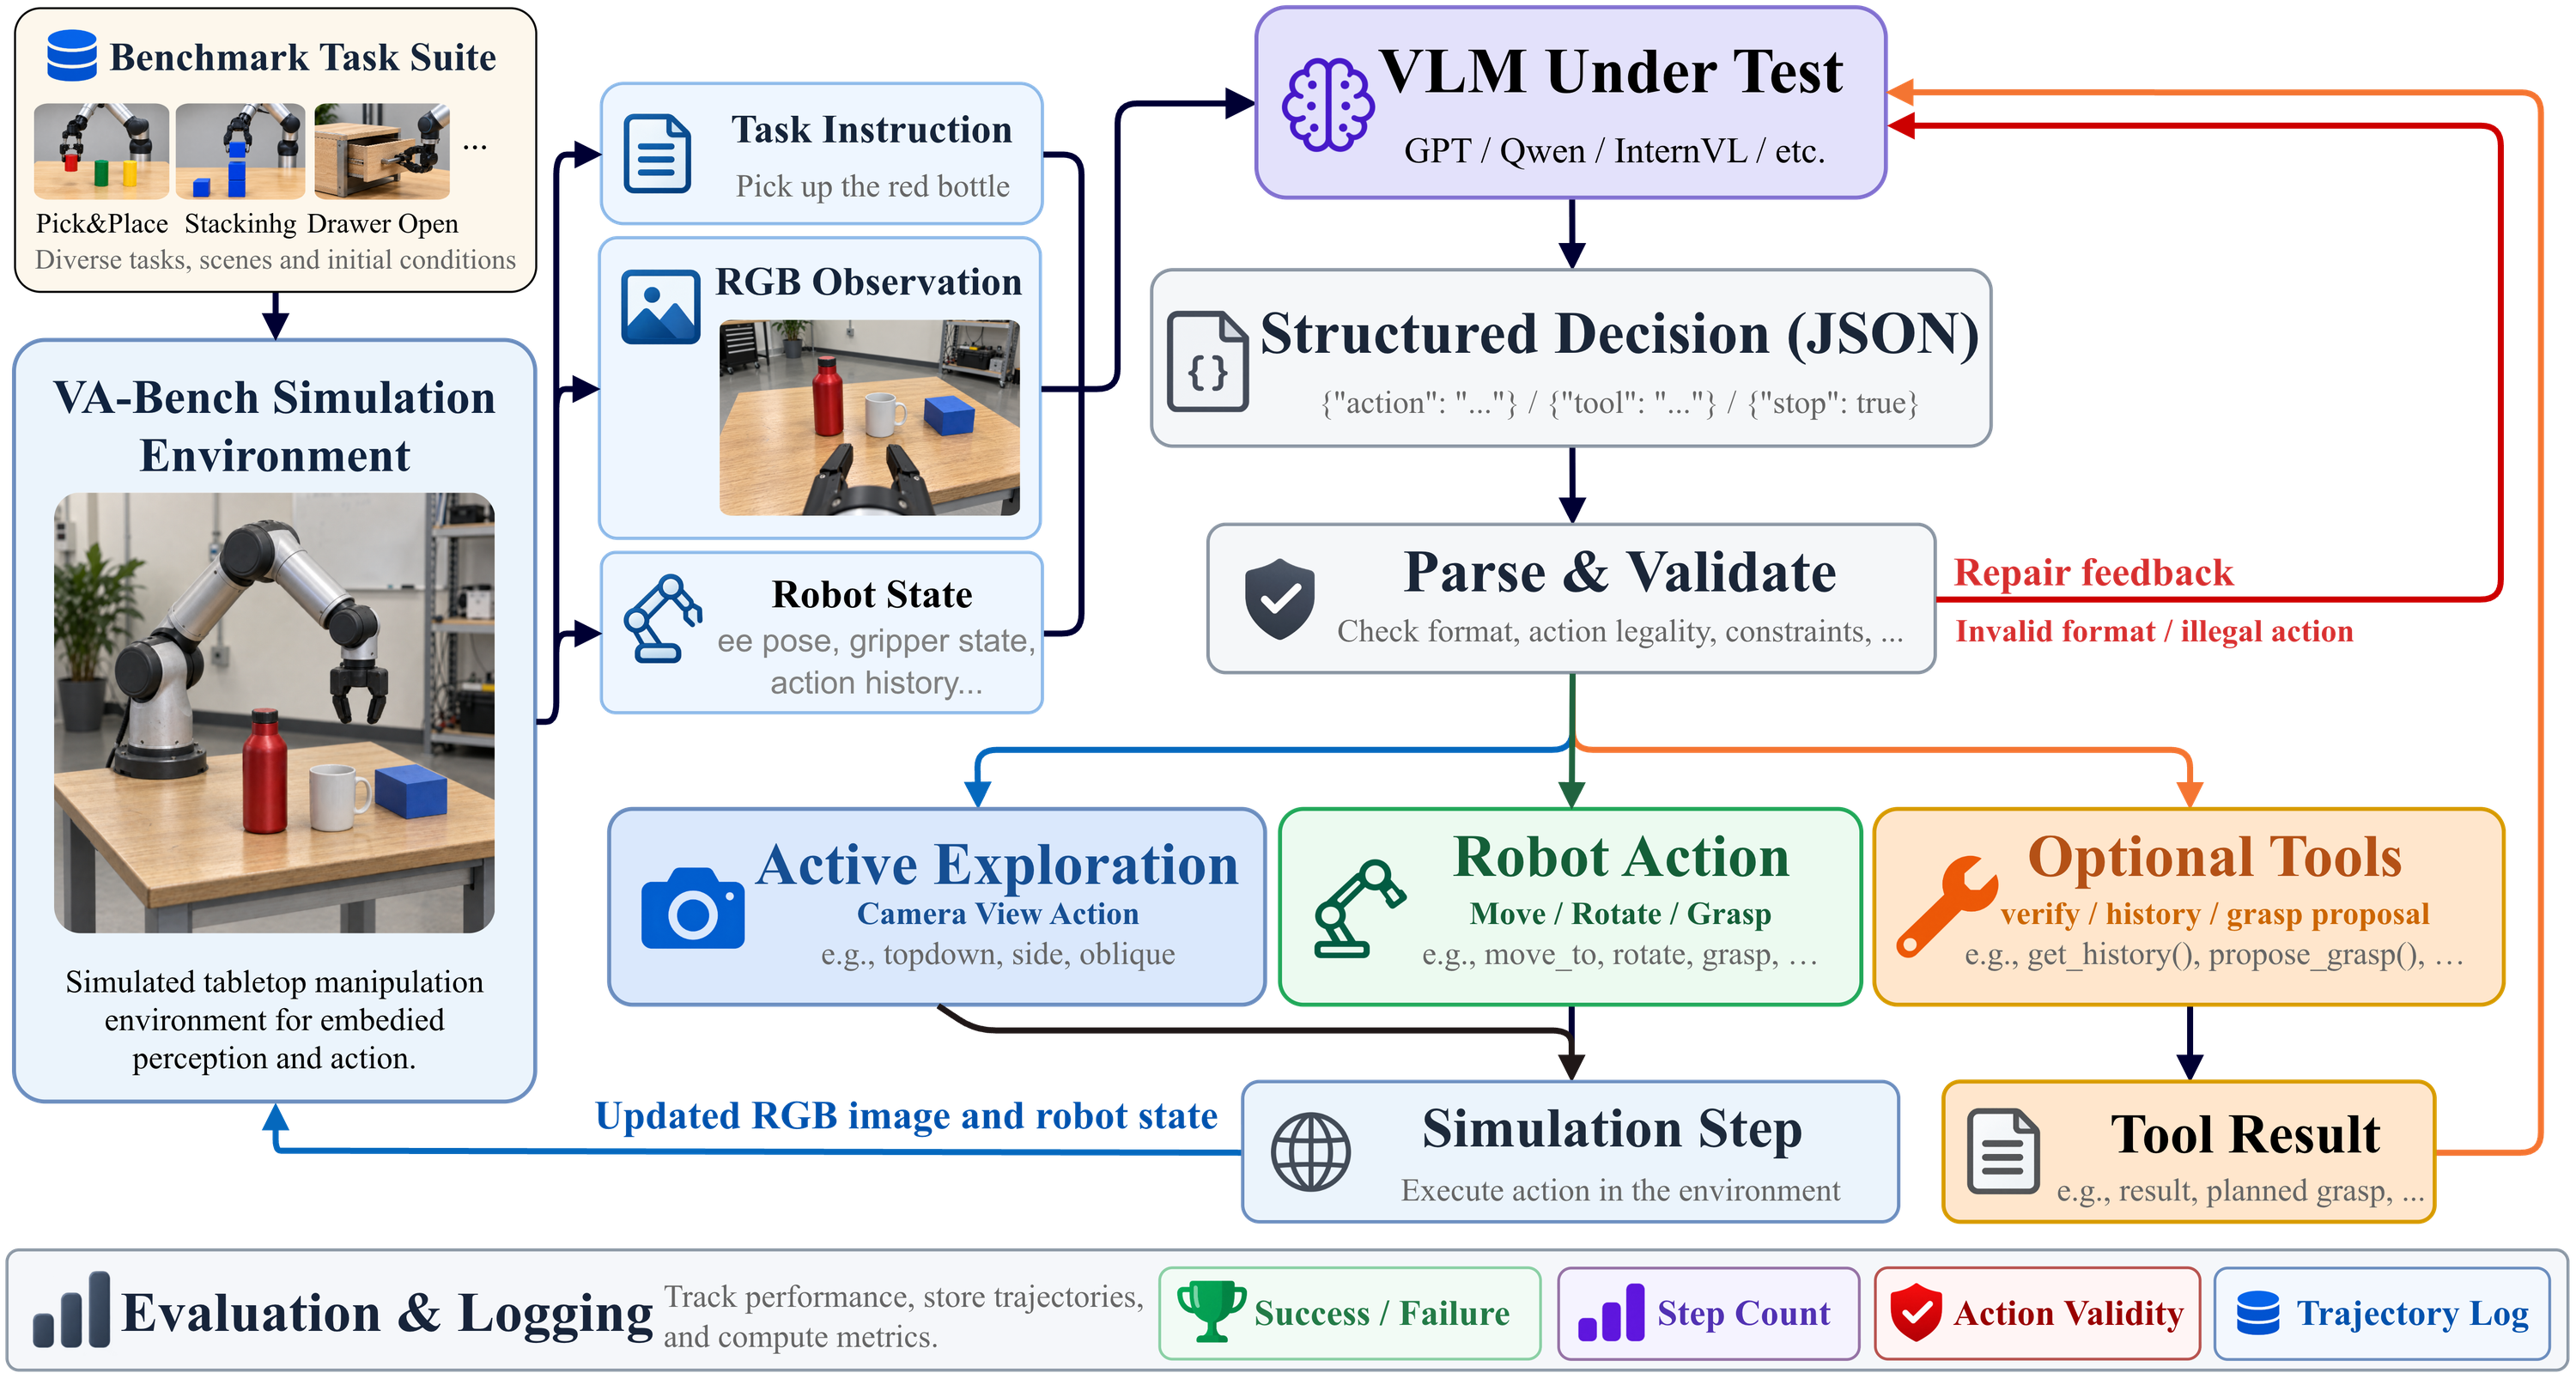
Figure 4 — 에이전트 하네스
핵심 결과는 다음과 같다. 첫째, 최상위 모델인 Qwen3.8-max는 target localization에서 100.0%, manipulation semantics (MS)에서 100.0%의 높은 진단 점수를 기록했지만, robot–object spatial relations (SR)에서는 78.9%, 그리고 14개 base task에 대한 3-run macro-average task success는 53.93% ± 3.17%에 그쳤다 [Table 3]. 이는 객체 식별 및 의도된 동작 선택 능력이 정확한 로봇–객체 기하학적 관계 설정으로 이어지지 않음을 보여준다. 둘째, active camera control은 passive multi-view observation 대비 task success를 유의미하게 향상시킨다. Qwen3.8-max의 경우 active camera control을 사용할 때 성공률이 57.50%였으나, passive multi-view observation으로 전환 시 27.86%로 29.64% 포인트 감소했다 [Table 4]. 이는 단순히 광범위한 시야를 제공하는 것보다 태스크 조건부 증거 획득(task-conditioned evidence acquisition)의 중요성을 강조한다. 셋째, held-out geometric transfer 및 long-horizon composition task는 여전히 도전 과제로 남아 있다. Qwen3.8-max는 held-out transfer에서 10.00% 포인트의 성공률 감소(77.86%에서 67.86%로)를 보였으며, GPT-5.6-sol은 32.14% 포인트 감소(80.00%에서 47.86%로)를 기록했다 [Table 5]. Long-horizon composition track에서는 어떤 모델도 strict long-horizon episode를 완료하지 못했으며, 최상위 모델인 Qwen3.8-max조차 100개 중 61개의 객체 배치(object placements)를 성공했을 뿐 완전한 태스크 성공은 0.00%였다 [Table 5].
4. Conclusion & Impact (결론 및 시사점)
VA-Bench는 일반 목적 MLLM이 metric robot commands를 통해 active observe–reason–act 루프를 성공적으로 완료할 수 있는지를 평가하는 중요한 벤치마크이다. 이 연구는 현재 MLLM이 target localization 및 manipulation semantics에서는 높은 점수를 달성하지만, robot–object spatial relations 진단과 online error correction 능력은 여전히 취약하다는 점을 명확히 보여준다. 즉, 강력한 시각 및 의미론적 이해가 정밀하고 구성 가능하며 복구 가능한 물리적 행동으로 직접적으로 이어지지 않고 있음을 시사한다. 능동적인 카메라 제어(active camera control)의 중요성이 확인되었는데, 카메라 제어 기능이 제거될 경우 태스크 성공률이 9.64%에서 29.64% 포인트 감소하는 것이 관찰되었다. 이는 단순히 넓은 시야를 제공하는 것만으로는 태스크에 필요한 증거를 능동적으로 획득하는 것을 대체할 수 없음을 강조한다. 본 연구는 현재 MLLM의 closed-loop 역량의 한계를 규명하고, 향후 연구가 공간 진단과 실제 조작 실행 간의 격차를 해소하고, held-out geometric transfer 및 long-horizon composition과 같은 도전적인 일반화 시나리오에서 성능을 향상시키는 데 집중해야 할 필요성을 제시한다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Show-Harness: Just a VLM Agent Can Play Robots
- [논문리뷰] LightNav-0: Eliciting VLM Spatial Intelligence for Generalist Embodied Navigation
- [논문리뷰] EVA-Client: A Unified Data Collection, Inference, and Deployment Framework for Embodied Policies on Real Robots
- [논문리뷰] ImageWAM: Do World Action Models Really Need Video Generation, or Just Image Editing?
- [논문리뷰] ACE-Ego-0: Unifying Egocentric Human and Robotic Data for VLA Pretraining
Review 의 다른글
- 이전글 [논문리뷰] UFO: Chain-of-Evaluation for Omni-Condition Alignment in Multi-Modal Image Generation
- 현재글 : [논문리뷰] VABench: Measuring Embodied Spatial Intelligence through Visual Demonstrations, Active Perception, and Metric Control
- 다음글 [논문리뷰] Video DeltaNet: A Video-Native Hybrid Attention for Livestream Video Generation
댓글