[논문리뷰] EmbodiedCLBench: Evaluating Continual Learning for Self-Evolving Embodied Agents
링크: 논문 PDF로 바로 열기
저자: Jie Huang, Yanan Chen, Ruixun Liu, Kaichen He, Xinyi He, Rui Huang, Zilong Zheng, Zhenliang Zhang, Yiwu Zhong
1. Key Terms & Definitions (핵심 용어 및 정의)
- EmbodiedCLBench: 자가 진화형 에이전트의 Continual Learning 능력을 평가하기 위해 고안된 최초의 embodied simulation 벤치마크.
- Compositional Generalization: 기본 작업(Basic tasks)에서 학습한 기술적 요소들을 재조합하여 이전에 본 적 없는 고급 작업(Advanced tasks)을 해결하는 능력.
- TongSim: 본 벤치마크에서 사용하는 시뮬레이션 플랫폼으로, 가사 환경에서의 다양한 물리적 상호작용과 객체-행동(object-action) 조합을 지원함.
- In-Context Learning (ICL): 학습 단계에서 관련 기본 작업들의 상호작용 궤적(trajectories)을 컨텍스트에 포함하여 테스트 단계에 활용하는 방식.
- Skill Learning: 학습한 경험을 바탕으로 Markdown 형식의 기술 요약(skill summary)을 생성하고, 이를 테스트 단계의 컨텍스트로 사용하는 방식.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 embodied 환경에서 에이전트가 과거의 경험을 누적하고 새로운 작업으로 전이하는 Continual Learning 능력을 체계적으로 평가하기 위해 EmbodiedCLBench를 제안한다. 기존의 Continual Learning 연구들은 주로 지식 집약적 환경이나 디지털 환경에 국한되어 있어, 공간적 복잡성과 물리적 제약이 존재하는 embodied 시나리오를 제대로 반영하지 못한다는 한계가 있다. 반면, 기존 embodied 벤치마크들은 특정 기술(탐색, 조작 등) 평가에는 적합하지만 에이전트의 지속적인 학습 및 전이 능력 평가에는 특화되어 있지 않다. 따라서 본 연구는 Compositional Generalization을 핵심 평가 원리로 삼아, 에이전트가 단순 작업에서 기술을 습득하고 이를 복잡한 미해결 작업에 어떻게 적용하는지 측정하고자 한다 [Figure 1].
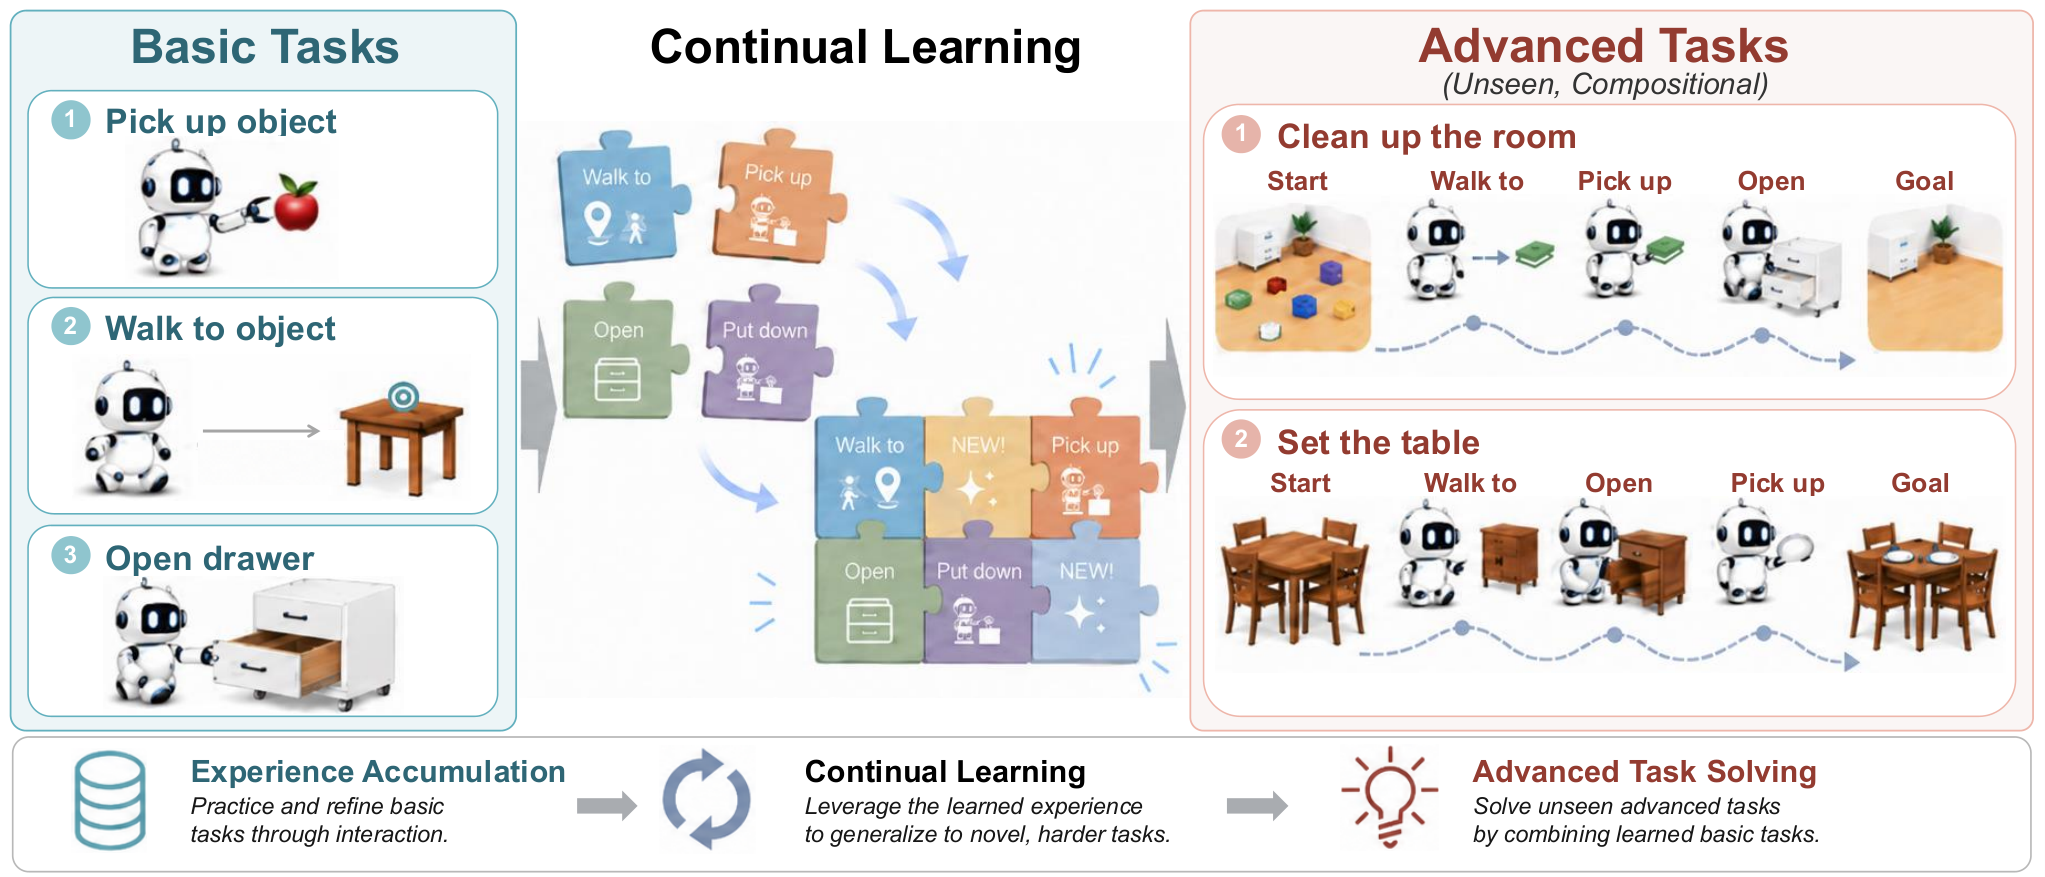
Figure 1 — 합성 일반화를 통한 Continual Learning 평가
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 환경 설정, 작업 생성, 그래프 구축, 평가 프로토콜의 4단계로 구성된 EmbodiedCLBench 프레임워크를 설계하였다 [Figure 2]. 특히, offline 환경에서도 결정론적이고 반복 가능한 평가를 위해 작업을 state-transition graph 형태로 구조화하였다 [Figure 2]. 실험 결과, Zero-shot 설정에서는 고급 작업의 성공률이 약 10%에 불과했으나, ICL 또는 Skill Learning을 통해 관련 기본 작업을 학습한 에이전트들은 성공률을 30% 이상으로 크게 향상시켰다 [Table 1]. 또한, 작업의 복잡도가 증가해도 지속적인 학습으로 얻은 이득은 안정적으로 유지되었으나, 학습 데이터인 기본 작업 샘플 수를 늘려도 성공률이 비례하여 증가하지는 않는다는 점이 확인되었다 [Figure 4, Figure 5]. 분석 결과, 학습 경험은 에이전트의 의사결정 과정에서 유효하지 않은 행동(invalid actions)을 대폭 감소시키고 최적 행동(optimal actions)의 선택을 유도하는 것으로 나타났다 [Figure 6].
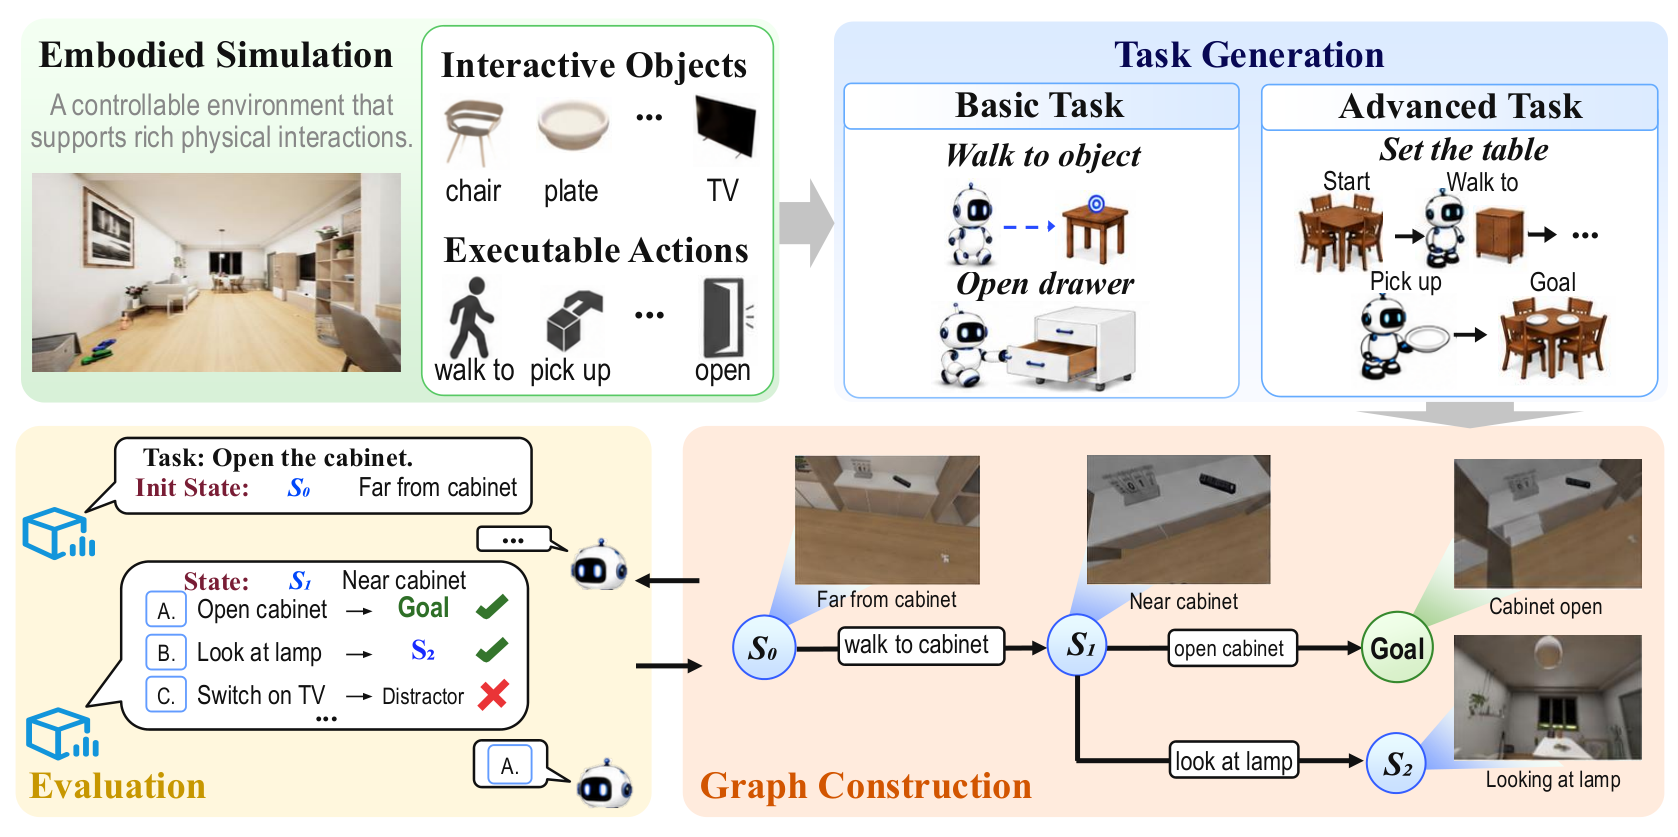
Figure 2 — EmbodiedCLBench 구축 파이프라인
4. Conclusion & Impact (결론 및 시사점)
본 연구는 embodied 에이전트의 Continual Learning을 평가하는 최초의 표준화된 테스트베드를 구축하고, Compositional Generalization이 이 능력을 측정하는 유효한 척도임을 입증하였다. 실험을 통해 현재의 에이전트들이 기초 경험을 전이할 수는 있지만, 데이터 효율성 측면에서 학습 샘플이 추가될 때의 성능 향상은 여전히 한계가 있음이 드러났다. 본 벤치마크는 자가 진화형 에이전트 설계를 위한 중요한 자원을 제공하며, 향후 embodied 지능의 학습, 유지, 재사용 능력을 극대화할 수 있는 더 강력한 프레임워크 개발을 촉진할 것으로 기대된다.
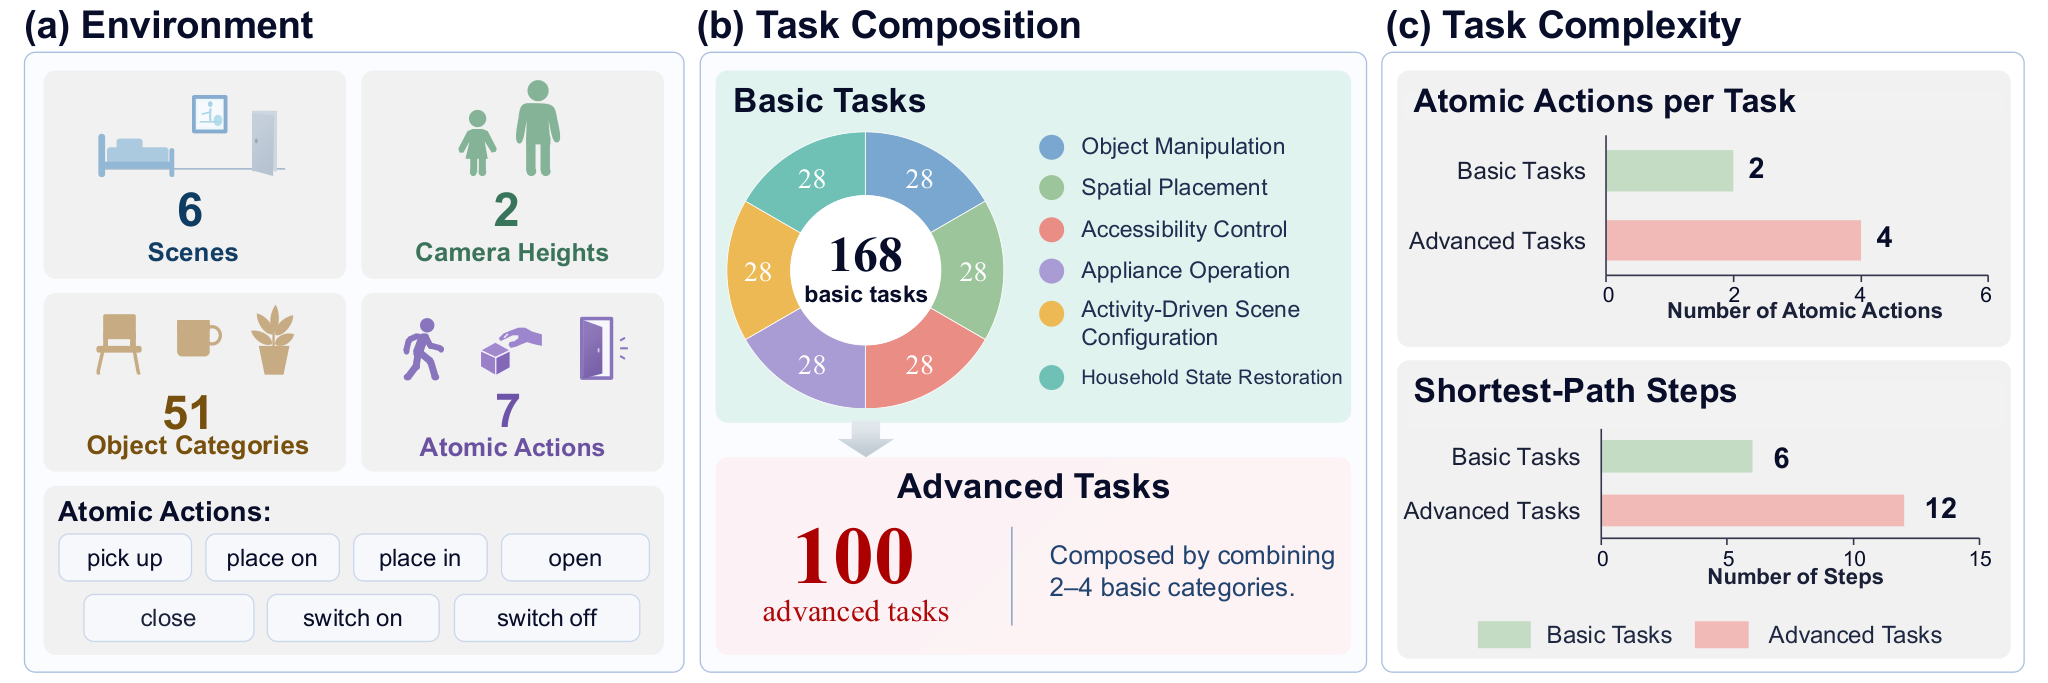
Figure 3 — 벤치마크 통계 요약
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Self-Evolving Coding Agents: From Digital Programs to Physical-World Intelligence
- [논문리뷰] ASPIRE: Agentic /Skills Discovery for Robotics
- [논문리뷰] Towards Agentic Robots: Model, Data, Environment, and Harness
- [논문리뷰] UNITAS: A 3D-Native World Action Model for Embodied Manipulation
- [논문리뷰] Systematic Multi-Agent Vision-and-Language Navigation: Formulation, Benchmark, and Method
Review 의 다른글
- 이전글 [논문리뷰] Distributionally Robust Mixture-of-Experts Training
- 현재글 : [논문리뷰] EmbodiedCLBench: Evaluating Continual Learning for Self-Evolving Embodied Agents
- 다음글 [논문리뷰] From Given to Gathered Evidence: Agentic Learning for Longitudinal Medical Reasoning
댓글