[논문리뷰] SWE-Duel: Towards a Self-Scaling Arena for Coding Agents
링크: 논문 PDF로 바로 열기
메타데이터
저자: Wei Minn, Zhensu Sun, Lwin Khin Shar, David Lo
1. Key Terms & Definitions (핵심 용어 및 정의)
- Red Agent: Pull Request(PR)를 작성하여 새로운 기능을 구현하고 그 안에 의도적으로 버그를 삽입하는 역할을 수행하는 에이전트.
- Blue Agent: Red Agent가 제출한 PR을 검토하고, 버그를 찾아내어 수정함으로써 해당 코드의 무결성을 확보하는 역할을 수행하는 에이전트.
- Blind Self-Repair: Red Agent가 작성한 버그가 해결 가능한지 검증하기 위해, 동일한 모델이 버그 정보를 모르는 상태에서 다시 수정하도록 하는 검증 프로세스.
- Tournament: 여러 에이전트가 서로의 태스크를 해결하며 상호 평가하는 Round-robin 방식의 대결 체계.
- Task Bank: 각 에이전트가 생성하고 통과시킨 검증된 태스크들의 집합으로, 대회 동안 다른 에이전트들의 평가 기준으로 활용됨.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 코딩 벤치마크들이 고정된 태스크 세트를 사용하여 데이터 유출 및 모델 성능 포화 문제에 직면해 있다는 한계를 해결하고자 한다. 고정된 벤치마크는 시간이 지남에 따라 모델 학습 데이터에 포함되거나 최신 모델의 성능 향상 속도를 따라가지 못해 측정 도구로서의 신뢰성을 상실한다. 저자들은 이러한 문제를 극복하기 위해 태스크와 오라클(Oracle)이 평가 시점에 동적으로 생성되는 Self-scaling 벤치마크 구조가 필요하다고 주장한다. 특히, 단순히 기존 이슈를 재사용하는 방식에서 벗어나, 에이전트가 직접 태스크 난이도를 설정하고 대결하는 환경을 구현하고자 한다 [Figure 2].
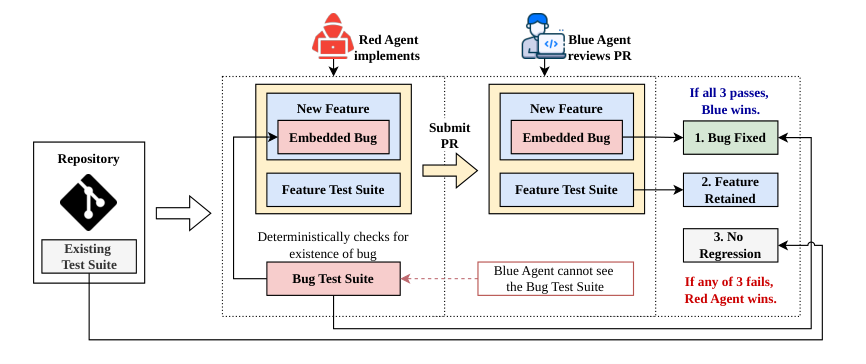
Figure 2 — SWE-Duel 평가 프로토콜
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 두 코딩 에이전트가 Red와 Blue 역할을 교대로 수행하며 서로의 코드를 검증하는 SWE-Duel 프레임워크를 제안한다. Red Agent는 세 개의 세션을 통해 기능을 구현하고 버그를 삽입하며, 최종적으로 Blind Self-Repair를 통과한 태스크만을 Task Bank에 저장한다 [Figure 3]. Blue Agent는 버그 존재 여부를 모르는 상태에서 코드를 검토하며, 기능 테스트(Feature tests), 버그 테스트(Bug tests), 기존 테스트(Existing tests)를 모두 통과해야만 승리한다. 총 11개의 모델-하스니스 조합이 1,500회 이상의 대결을 수행한 결과, GPT-5.5와 Codex CLI 조합이 98.3%의 수리 성공률로 가장 강력한 Solver로 평가되었다. 반면, Claude Opus 4.8과 mini-swe-agent 조합은 27.3%의 Red 승률을 기록하며 가장 강력한 태스크 제작 능력을 보여주었다 [Figure 1]. 실험 결과, 최신 모델 버전이 생성한 태스크일수록 고정된 해결사(Fixed-reference solver)를 더 많이 패배시켜, 태스크 난이도가 저자의 능력에 따라 확장(Scale)됨을 입증하였다 [Table 2].
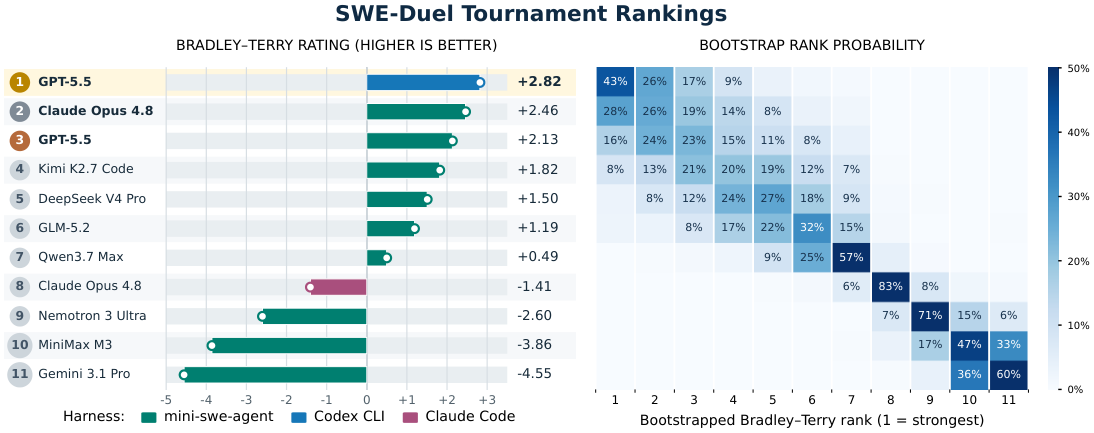
Figure 1 — SWE-Duel 토너먼트 순위 결과
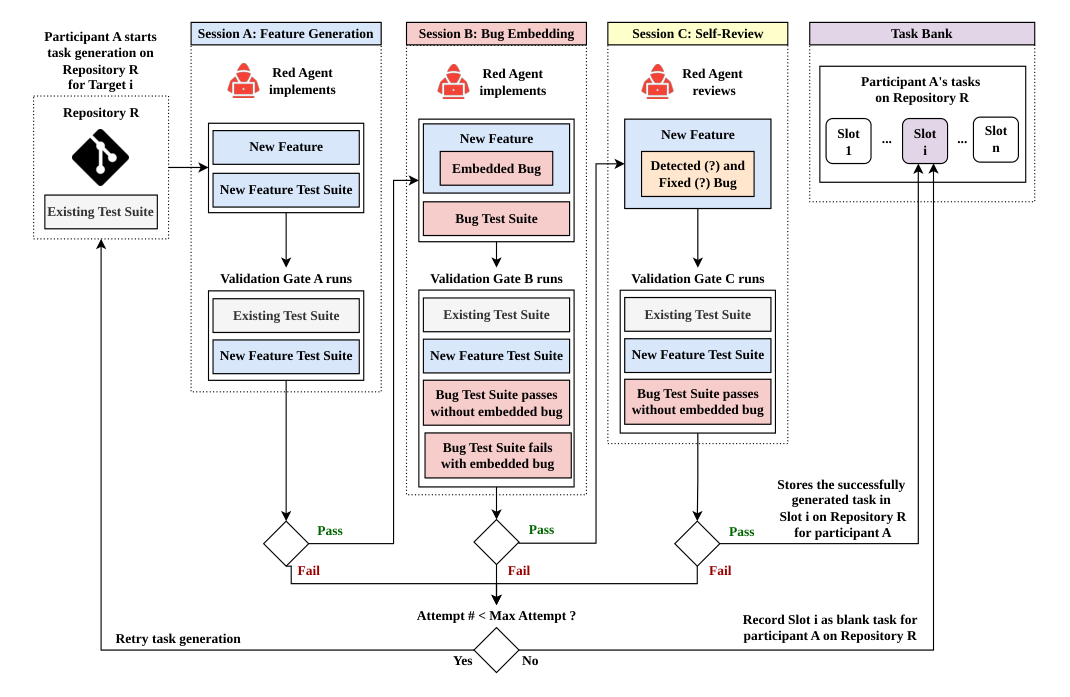
Figure 3 — 3단계 태스크 생성 프로세스
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Coding Agent 평가를 위한 Self-scaling 벤치마크인 SWE-Duel을 성공적으로 도입하여 벤치마크 데이터 유출 및 난이도 고착화 문제를 근본적으로 해결하였다. 이 연구는 평가 대상인 에이전트가 직접 난이도를 상향 평준화할 수 있는 생태계를 구축함으로써, 향후 모델의 발전과 함께 성능 평가의 기준도 진화하는 선순환 구조를 제시한다. SWE-Duel 프레임워크와 공개된 툴킷은 학계와 산업계 모두에게 모델의 소프트웨어 엔지니어링 능력을 측정하는 새로운 표준을 제공할 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RealSWE: A Compositional Evaluation of Coding Agents under Realistic User Requests
- [논문리뷰] SWE-Pruner Pro: The Coder LLM Already Knows What to Prune
- [논문리뷰] A Survey of Vibe Coding with Large Language Models
- [논문리뷰] SWEeper-Bench: Can Agents Discover Bugs in Interactive Software?
- [논문리뷰] ProgramGym: Scaling Training Environments for Long-Horizon Program Reproduction Agents
Review 의 다른글
- 이전글 [논문리뷰] SAGE: Salient Factor Discovery and Generation with Visual Foundation Representations
- 현재글 : [논문리뷰] SWE-Duel: Towards a Self-Scaling Arena for Coding Agents
- 다음글 [논문리뷰] Self-Preservation in Language Models
댓글