[논문리뷰] SPLATIFY: Reproduce, Discover, Innovate! From Papers and Ideas to Trainable 3DGS Code
링크: 논문 PDF로 바로 열기
저자: Seemandhar Jain, Keshav Gupta, Manmohan Chandraker
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문에서 다루는 핵심 기술 용어 및 개념은 다음과 같다.
- 3D Gaussian Splatting (3DGS): Kerbl et al.이 2023년에 제안한 실시간 Radiance Field 렌더링을 위한 기술로, 장면을 anisotropic Gaussian들의 집합으로 표현한다.
- gsplat: 3DGS 구현을 위한 오픈소스 라이브러리로, Nerfstudio 프레임워크와 통합되어 사용되는 경우가 많다.
- Context-Free Grammar (CFG): 대규모 언어 모델(LLM)의 코드 생성 출력을 제약하는 데 사용되는 형식 문법으로, 생성된 코드가 특정 아키텍처 규칙을 준수하도록 보장한다.
- Fork-aware Citation Recovery: 3DGS 생태계의 분산된(fork-dominated) 코드베이스에서 컴포넌트 수준의 코드 종속성을 식별하고 해결하기 위해, 인용된 논문의 저장소를 부모 저장소와 비교하여 구조화된
diff를 분석하는 메커니즘이다. - Graph-of-Thought (GoT): LLM의 추론 과정을 탐색 가능한 그래프 구조로 조직화하여 코드 생성 및 개선 프로세스를 체계화하는 접근 방식이다.
- PSNR, SSIM, LPIPS: 이미지 품질을 정량적으로 평가하는 데 사용되는 주요 Metric으로, 각각 Peak Signal-to-Noise Ratio, Structural Similarity Index Measure, Learned Perceptual Image Patch Similarity를 의미한다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 급증하는 3D Gaussian Splatting (3DGS) 연구 분야에서 논문을 실행 가능한 코드로 전환하고, 새로운 지식을 발견하며, 기존 방법을 혁신하는 데 필요한 막대한 노력과 병목 현상을 해결하고자 한다. 3DGS 분야는 2023년 Kerbl et al.이 도입한 이후 3년 만에 1,500편 이상의 논문이 발표될 정도로 빠르게 성장했지만, 새로운 방법론을 사용하기 위해 논문을 구현하는 과정은 수 주일이 소요되는 재구현 및 디버깅 작업으로 인해 매우 더디다.
기존의 일반적인 Paper-to-Code 파이프라인(예: Paper2Code, AutoP2C)은 3DGS와 같은 특정 도메인의 복잡한 특성(예: Gaussian attribute coupling, adaptive density control, CUDA kernel)을 이해하지 못해 훈련 가능한 코드를 생성하지 못한다. 또한, 3DGS 연구의 약 70%가 기존 INRIA 코드베이스를 fork하여 독립적인 저장소를 생성하는 fork-dominated 환경에서는 호환되지 않는 가정과 구현 방식으로 인해 코드 재사용이 어렵다. 이는 단지 코드 재현의 문제를 넘어, 2,000개 이상의 논문에 흩어진 방대한 지식을 효율적으로 discover하거나 compose하는 것조차 불가능하게 만든다. 수많은 기술 조합의 가능성에도 불구하고, 수동적인 탐색은 극히 일부만을 다룰 수 있으며, 광학적으로 얇은 성운(nebulae) 렌더링과 같은 새로운 응용 도메인은 높은 엔지니어링 장벽으로 인해 접근되지 못하고 있다. 따라서 해당 분야는 논문의 지식을 discovering, composing, extending 할 수 있는 인프라를 절실히 필요로 한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
Splatify는 3DGS 논문을 trainable gsplat-based 구현으로 전환하는 multi-agent framework를 제안하며, 이는 grammar-constrained synthesis, fork-aware citation recovery, closed-loop visual feedback을 통해 기존 generic paper-to-code methods 및 frontier models의 한계를 극복한다. [Figure 3] 는 Splatify의 상세한 아키텍처를 보여주며, 그 핵심은 다섯 가지 혁신에 기반한다.
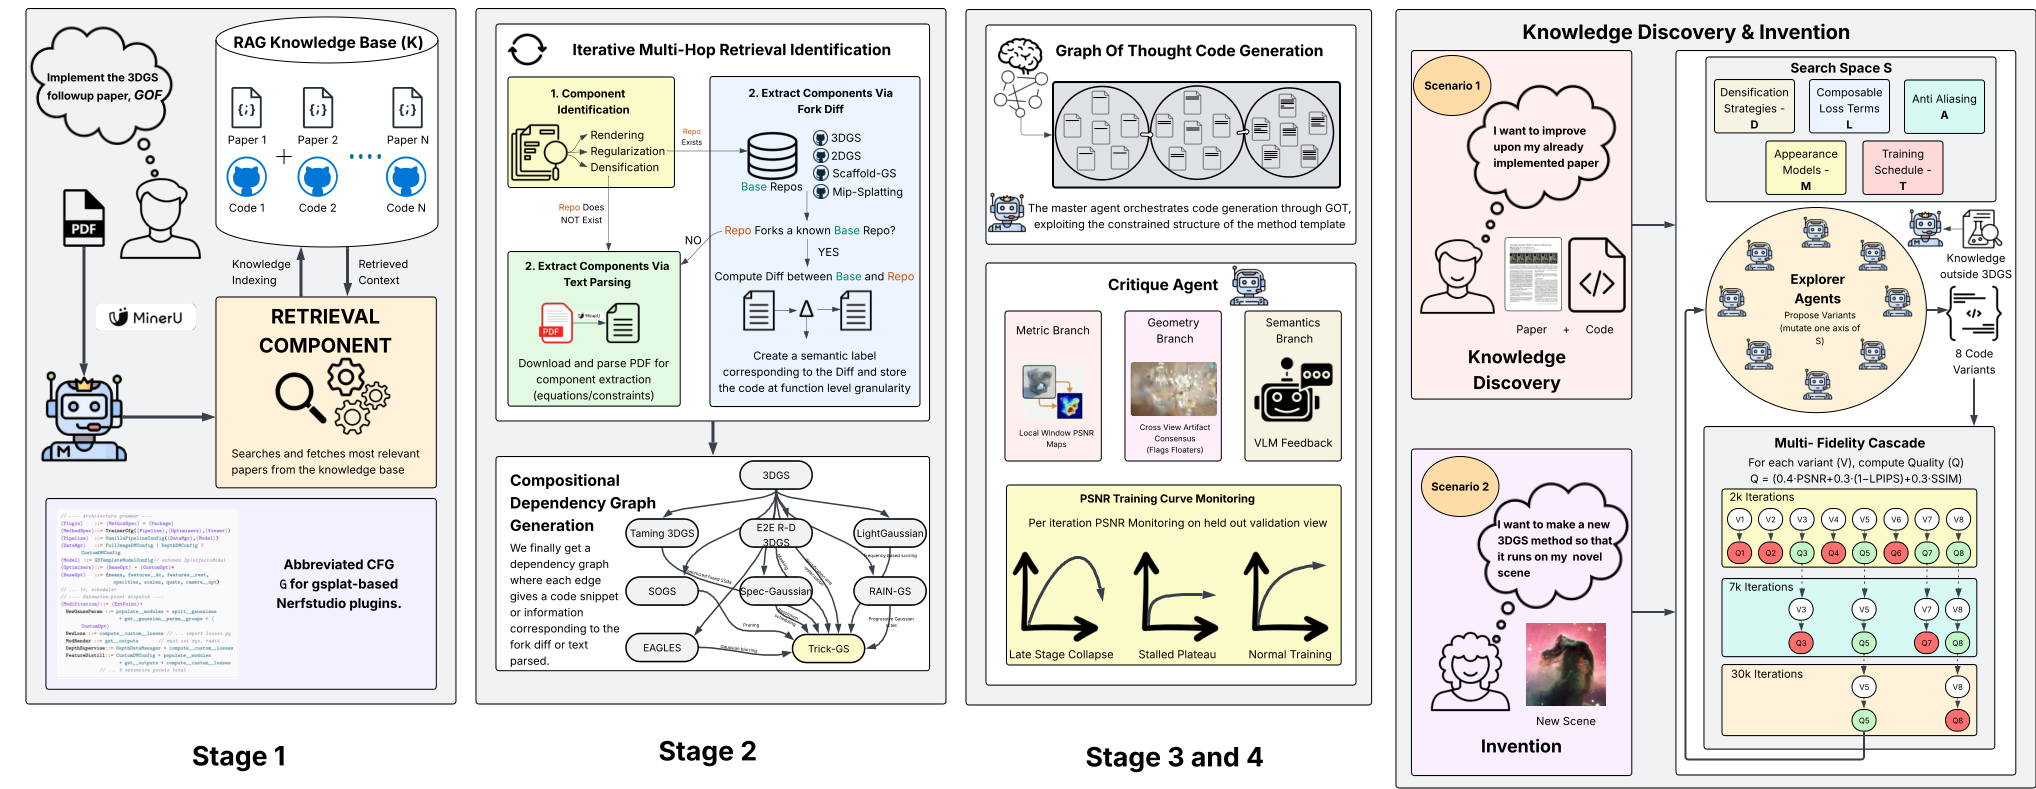
Figure 3 — Splatify 전체 아키텍처
첫째, Splatify는 gsplat의 모듈형 method template 위에 context-free grammar (CFG)를 정의하여 loss, densification, rendering, optimization 등 9가지 extension point를 제공한다. 이는 생성된 코드가 gsplat의 아키텍처 invariant를 구조적으로 만족하도록 synthesis를 제약한다. 둘째, faithful reproduction을 위해 function-level granularity의 fork-aware citation recovery와 Graph-of-Thought (GoT) 기반의 코드 synthesis, RAG-guided in-context learning을 결합하며, PSNR-guided regeneration, Gaussian-level structural checks, VLM-driven patching을 포함하는 visual feedback을 활용한다. [Figure 3]의 왼쪽 부분은 이러한 reproduction 파이프라인을 시각화한다. 셋째, knowledge-driven compositional improvement를 통해 agent가 기존 결과의 약점을 자율적으로 진단하고 보완적인 regularizer, loss, densification strategies를 compose하여 원본 논문의 성능을 향상시킨다. 넷째, interdisciplinary method discovery는 3DGS 외부 문헌에서 physical priors를 검색하고 렌더링 지식과 결합하여 previously unaddressed scene types를 위한 방법을 생성한다. 마지막으로, Splatify-Bench는 3DGS paper-to-code synthesis를 위한 30편의 논문으로 구성된 새로운 벤치마크이다.
실험 결과, public code가 없는 논문(Set 1)에서 Splatify는 expert implementations와 평균적으로 ±0.5 dB PSNR 및 ±0.02 SSIM 이내의 visual quality를 달성했으며, 개발 시간을 수 주에서 수 분으로 단축시켰다. [Table 1]은 대표적인 Set 1 논문에 대한 정량적 결과를 보여주며, [Figure 4]는 Splatify가 baselines와 비교하여 expert quality에 근접함을 시각적으로 입증한다. public code가 있는 논문(Set 2)에 대해서도 Splatify는 원본 저자의 저장소와 0.3 dB PSNR 미만의 평균 편차로 비슷한 성능을 보였다. 특히 compositional discovery 모드에서는 reproduction-only baseline 대비 최대 +2.4 dB PSNR 개선을 달성했으며, cross-domain invention은 volumetric nebula rendering (NebulaGS) 및 iridescent thin-film rendering (BubbleGS)과 같은 novel scene types에 대한 새로운 방법론을 성공적으로 생성했다. NebulaGS는 vanilla 3DGS 대비 +1.33 dB PSNR 및 +0.052 SSIM 개선을 보였고, BubbleGS는 +0.84 dB PSNR 및 +0.011 SSIM 개선을 달성했다. [Figure 5]는 cross-domain method creation의 정성적 결과를 보여주며, NebulaGS가 opaque shell artifacts를 해결하고 BubbleGS가 iridescent color variation을 포착함을 나타낸다.
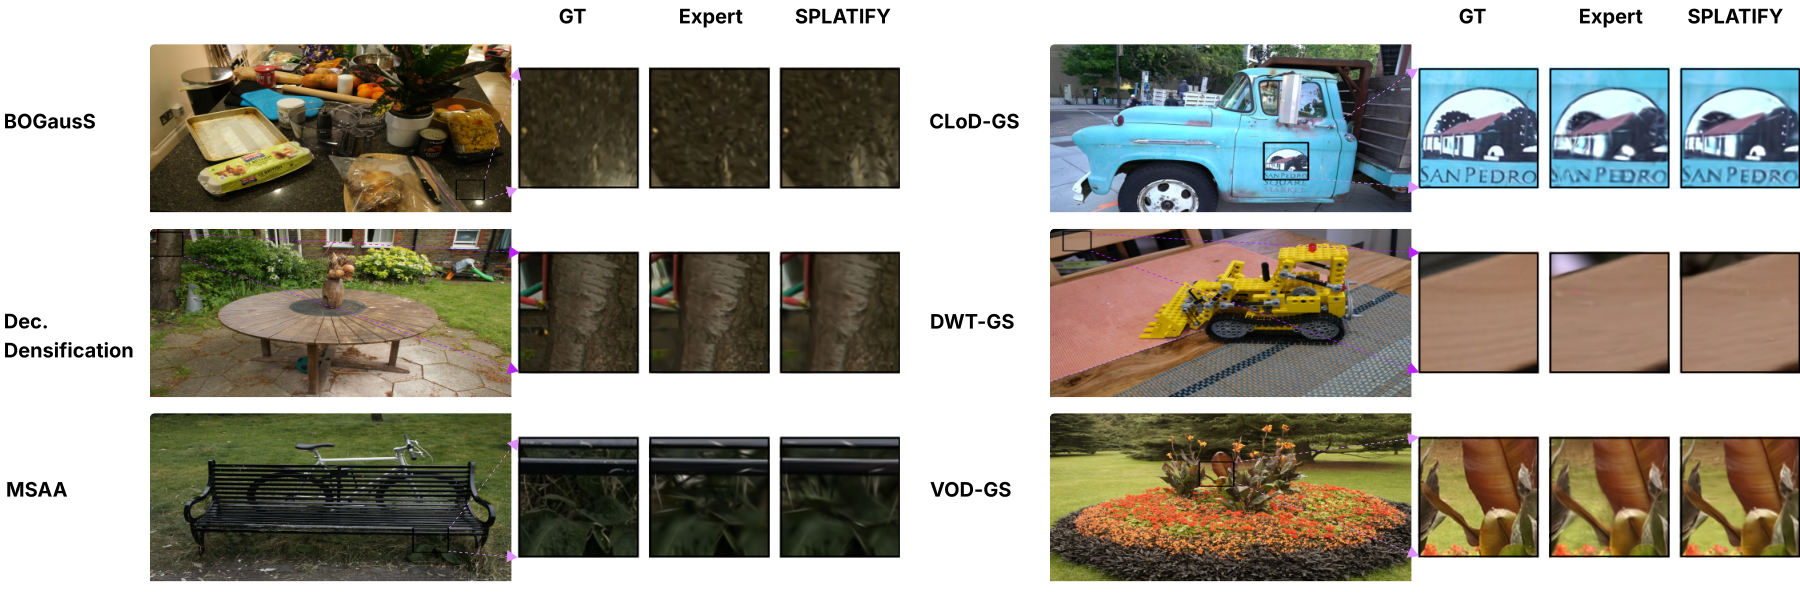
Figure 4 — 재현 결과 정성적 비교
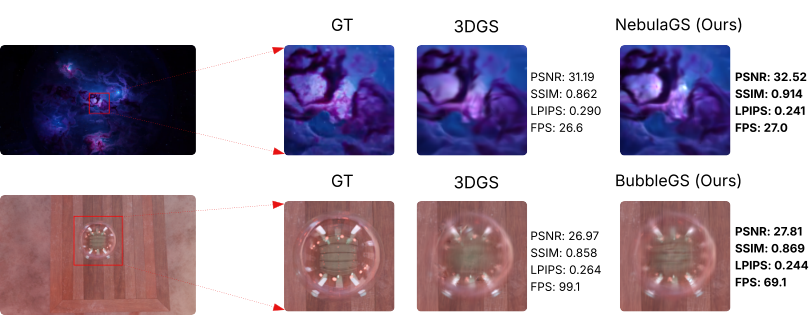
Figure 5 — 교차 도메인 생성 결과
4. Conclusion & Impact (결론 및 시사점)
결론적으로, 본 논문은 Splatify라는 multi-agent framework를 통해 3DGS 논문을 trainable gsplat implementations으로 성공적으로 전환하는 방법을 제시한다. 이 프레임워크는 grammar-constrained synthesis, fork-aware citation recovery, closed-loop visual feedback이라는 핵심 구성 요소를 통해 expert implementations에 필적하는 성능을 달성하며, 개발 시간을 대폭 단축시킨다.
Splatify는 단순한 논문 재현을 넘어 compositional discovery를 통해 기존 방법론의 성능을 자율적으로 향상시키고, cross-domain invention을 통해 이전에 다루지 않았던 scene types에 대한 새로운 방법론을 생성하는 등 knowledge discovery와 innovation을 가능하게 한다. 이러한 기능은 빠르게 성장하는 3DGS 분야에서 연구자들이 새로운 아이디어를 신속하게 탐색하고, prior work를 기반으로 구축하며, 학제 간 지식을 통합하여 새로운 응용 분야를 개척하는 데 중요한 impact를 미칠 것으로 기대된다. Splatify의 아키텍처는 3DGS에 국한되지 않고, CFG와 seed set을 정의하면 다른 3D reconstruction pipelines 또는 robotics simulation stacks와 같은 새로운 도메인으로 generalize될 수 있는 잠재력을 가진다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] InfiniSplat v2: Analyzing and Improving Feed-Forward 3DGS from Any Views
- [논문리뷰] OuroWorld: Bringing Any 3D World Alive as Diverse, Endlessly Looping 3D Cinemagraphs
- [논문리뷰] Can AI Agents Make Open-Ended Scientific Discovery? Evidence from Station
- [논문리뷰] Mobile-4DGS: Unified Static-Dynamic Real-time Mobile Gaussian Splatting
- [논문리뷰] DataMagic: Authoring Data Videos through Declarative Multi-Agent Orchestration
Review 의 다른글
- 이전글 [논문리뷰] Relevance Does Not Imply Applicability: Experience Activation for Personal GUI Agents
- 현재글 : [논문리뷰] SPLATIFY: Reproduce, Discover, Innovate! From Papers and Ideas to Trainable 3DGS Code
- 다음글 [논문리뷰] Same Output, Different Gold: Measuring How Reference Choice Moves a Multilingual Benchmark Score
댓글