[논문리뷰] Scaling Agentic Data for Long-Horizon Terminal Intelligence
링크: 논문 PDF로 바로 열기
The user wants me to summarize the paper. I have browsed the content. Now I need to extract the information and format it according to the specified constraints.
Part 1: Markdown Summary
- Metadata:
- Authors: Shun Zou, Ziyu Ma, Yi Zou, Yong Wang, Lin Chen, Zehui Chen, Guanhua Chen, Xiangxiang Chu, Feng Zhao
- Keywords: Need to read the paper and identify 5-8 core technical terms.
Agentic Data,Long-Horizon Tasks,Terminal Agents,Data Synthesis,Supervised Fine-tuning,Behavioral Patterns,Environment Reconstruction,Progressive Expansion.
- Key Terms & Definitions:
- Terminal Agents: LLM agents that operate within digital environments using a terminal interface for code, data, tools, and execution feedback.
- Long-Horizon Tasks: 복잡하고 여러 단계로 이루어져 있으며, 에이전트가 지속적인 문제 해결 과정에서 증거를 축적하고, 전략을 조정하며, 중간 결과를 최종 결과물로 전환해야 하는 작업.
- Agentic Behavioral Patterns: 문제 해결 과정에서 에이전트가 정보를 탐색하고, 문제를 진단하며, 솔루션을 구성하고, 정확성을 검증하는 방식과 관련된 구조화된 행동 패턴. (e.g., Exploration, Diagnosis, Construction, Verification, Strategy Coordination).
- Challenge-Guided Long-Horizon Synthesis: 독립적인 실행을 통해 환경 구축 시 간소화되거나 이미 완료된 작업을 식별하고, 에이전트가 해당 작업을 수행하도록 환경을 재구성하는 데이터 합성 단계.
- Progressive Horizon Expansion: 동일한 목표 하에 기존 태스크에 새로운 요구사항을 추가하여 태스크를 확장하고, 이전 결과 및 피드백에 따라 추가 작업이 연결되도록 하여 에이전트 행동 패턴이 여러 단계에 걸쳐 지속되도록 하는 데이터 합성 단계.
- Motivation & Problem Statement:
- LLM agents are moving towards autonomous work in digital environments, particularly in the terminal interface.
- Existing terminal training data often consists of short trajectories, which are insufficient for developing capabilities for complex, long-horizon tasks that require sustained problem-solving, continuous strategy adjustment, and integration of intermediate results.
- The synthesis of long-horizon trajectories faces two main challenges: (i) complex tasks don't always elicit intended agentic behavioral patterns if parts of the problem are pre-solved, and (ii) extending these patterns across stages meaningfully is difficult, as simply increasing task difficulty or interaction turns doesn't guarantee richer, interconnected behaviors.
- Therefore, a new approach is needed to generate high-quality long-horizon trajectories that explicitly capture these agentic behavioral patterns and their cross-stage connections.
- Method & Key Results:
- 본 논문은 Long-Horizon Terminal Intelligence를 위한 자동화된 데이터 합성 엔진인 TerminalHorizon을 제안한다. 이 엔진은 두 가지 주요 단계로 구성된다: Challenge-Guided Long-Horizon Synthesis와 Progressive Horizon Expansion.
- Challenge-Guided Long-Horizon Synthesis 단계에서는 실제 전문 작업을 실행 가능한 태스크로 변환하고, 태스크 구축에 관여하지 않은 Independent Challenger Agent가 이를 해결한다. 이 실행 궤적(trajectory)을 분석하여 의도된 Agentic Behavioral Patterns이 발생했는지 확인하고, 태스크 구축 과정에서 에이전트가 수행해야 할 분석, 구현 또는 검증 작업이 간소화되거나 이미 완료된 부분을 식별한다. 이 분석 결과는 환경 재구성(environment reconstruction)을 안내하여 에이전트가 해당 작업을 직접 수행하도록 한다.
- Progressive Horizon Expansion 단계에서는 동일한 목표 아래 원래의 태스크를 확장하여 새로운 요구사항을 도입한다. 이 추가 작업은 이전 결과와 실행 피드백에 의존하도록 설계되어, 의도된 패턴이 여러 단계에 걸쳐 지속적으로 발전하도록 지원한다. 이 두 단계를 통해 TerminalHorizon은 에이전트 행동 패턴이 나타나고 태스크 완료까지 여러 단계에 걸쳐 확장되는 Long-Horizon 궤적을 생성한다 [Figure 2, 3].
- 이 엔진을 사용하여 1,535개의 태스크 환경과 2,852개의 훈련 궤적을 포함하는 TerminalHorizon-3K 데이터셋을 구축했으며, 이 궤적들은 평균 52.8 Interaction Turns를 기록하여 다른 비교 방법론들보다 훨씬 길다.
- Qwen3.5-27B 모델에 TerminalHorizon-3K 데이터셋으로 Supervised Fine-tuning(SFT)을 수행한 결과, TerminalHorizon-27B는 12개의 벤치마크(코딩 에이전트, 실제 생산 환경 에이전트 태스크, 일반 추론 포함) 전반에서 상당한 성능 향상을 달성했다. 구체적으로, Terminal-Bench 2.0에서 기준 모델 대비 14.2% (41.6% → 55.8%) 및 Terminal-Bench 2.1에서 13.85% (46.82% → 60.67%) 성능이 향상되었다 [Table 1, 2]. 또한, AutomationBench의 Pass Rate는 11.7% 증가하고 Partial score는 23.3% 증가했으며, VitaBench에서는 11.3% 향상되었다 [Table 2]. 이러한 결과는 소량의 고품질 Long-Horizon 데이터가 에이전트 능력 향상에 매우 데이터 효율적임을 입증한다.
- Conclusion & Impact:
- 본 연구는 Agentic Behavioral Patterns을 연결하는 Long-Horizon Trajectories를 합성하기 위한 완전 자동화 엔진인 TerminalHorizon을 성공적으로 개발했다. 이 엔진은 Challenge-Guided Reconstruction과 Progressive Expansion을 통해 탐색(exploration), 전략 수정(strategy revision), 검증(verification)과 같은 핵심 행동을 단일 목표 아래 통합한다.
- TerminalHorizon-3K 데이터셋으로 훈련된 모델은 다양한 벤치마크에서 기존 모델 대비 일관된 성능 향상을 보였으며, 특히 12시간의 연구 예산이 주어진 Recursive Self-Improvement(RSI) 케이스 스터디에서 초기 솔루션을 넘어선 지속적인 실험, 피드백 기반의 방법 개선, 그리고 효과적인 개선 사항을 최종 결과물로 유지하는 능력을 입증했다 [Figure 7].
- 이는 Long-Horizon Behavioral Experience가 에이전트를 단순한 로컬 터미널 작업에서 벗어나 지속적인 자율 작업(sustained autonomous work)을 수행하는 방향으로 발전시키는 데 중요한 훈련 가치를 제공함을 시사한다. 이 연구는 복잡하고 실제적인 문제 해결 능력을 갖춘 차세대 AI 에이전트 개발에 핵심적인 기여를 한다.
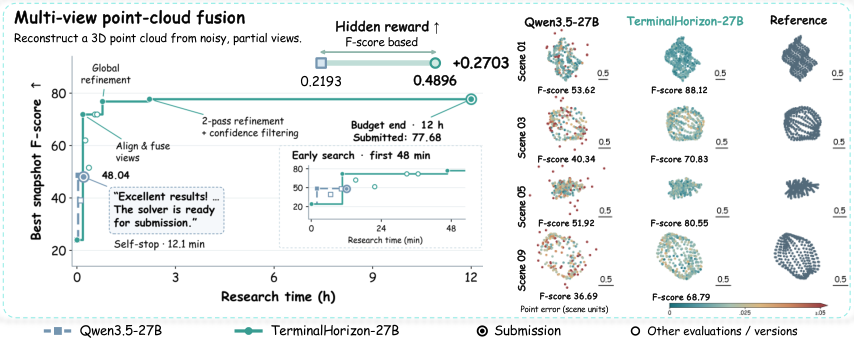
Figure 7 — RSI 태스크 최적화
Part 2: Important Figure Information (JSON) I need to check the HTML for image URLs and select up to 3 figures.
- Figure 1: Motivation for TerminalHorizon. This looks like a conceptual diagram, good for motivation.
2610.13166v1/teaser.png - Figure 2: Overview of TerminalHorizon. This is the pipeline/architecture diagram, very important.
2610.13166v1/pipline.png - Figure 3: Comprehensive analysis of task environments and trajectories in TerminalHorizon. This shows data analysis, including professional domains, feedback chains, and behavioral patterns.
2610.13166v1/data.png - Figure 4: Interaction turns per trajectory. This is a bar chart comparing length, good for key results. (However, Figure 3 has subfigures, and some of the data might be already covered there implicitly or explicitly.) Let's re-evaluate. Figure 3 actually includes several subfigures (a, b, c, d) related to data analysis. Figure 3d shows agentic behavioral patterns, which is a key concept. Figure 3a shows professional domain coverage. Figure 3c shows feedback chain length. Figure 4 is about interaction turns. It might be better to pick Figure 1, Figure 2, and maybe Figure 3 (as it is a comprehensive analysis of data, which is central to the method and results). If I choose Figure 3, I should reference its sub-parts or refer to it generally for data analysis.
Let's pick Figure 1 (Motivation), Figure 2 (Methodology Overview), and Figure 7 (RSI Case Study, showing impact). Figure 3 is very good for data analysis, but Figure 7 provides a strong qualitative result.
Let's check if Figure 7 has an image URL. Yes, 2610.13166v1/RSI-task.png.
Okay, plan for figures:
- Figure 1: Motivation for TerminalHorizon.
https://arxiv.org/html/2610.13166v1/teaser.png - Figure 2: Overview of TerminalHorizon.
https://arxiv.org/html/2610.13166v1/pipline.png - Figure 7: Long-horizon optimization on RSI-Exam.
https://arxiv.org/html/2610.13166v1/RSI-task.png
Now, construct the output.
**저자:** Shun Zou, Ziyu Ma, Yi Zou, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
본 섹션에서는 논문에서 핵심적으로 다루는 기술 용어와 개념을 정의한다.
- **Terminal Agents**: Large Language Model (LLM)을 기반으로 디지털 환경에서 터미널 인터페이스를 통해 코드, 데이터, 도구 및 실행 피드백을 활용하여 자율적으로 작업을 수행하는 에이전트.
- **Long-Horizon Tasks**: 단순한 단일 작업이 아닌, 여러 단계를 거쳐 오랜 시간 동안 지속되며 에이전트가 탐색, 전략 조정, 중간 결과 통합 등을 통해 최종 목표를 달성해야 하는 복잡한 문제 해결 태스크.
- **Agentic Behavioral Patterns**: 에이전트가 문제 해결 과정에서 정보를 탐색(exploration)하고, 문제를 진단(diagnosis)하며, 솔루션을 구성(construction)하고, 정확성을 검증(verification)하며, 전략을 조정(strategy coordination)하는 방식과 관련된 구조화된 행동 패턴. 이는 단순한 명령어 실행을 넘어선 지능적인 작업 조직 방식을 포함한다.
- **Challenge-Guided Long-Horizon Synthesis**: **TerminalHorizon** 엔진의 첫 번째 단계로, 독립적인 에이전트 실행을 통해 환경 구축 시 간소화되거나 미리 완료된 작업을 식별하고, 에이전트가 해당 핵심 작업을 직접 수행하도록 태스크 환경을 재구성하는 데이터 합성 방법론.
- **Progressive Horizon Expansion**: **TerminalHorizon** 엔진의 두 번째 단계로, 동일한 목표 하에 기존 태스크에 새로운 요구사항을 점진적으로 추가하여 태스크의 복잡성을 심화시키는 방법론. 이는 이전 결과와 실행 피드백에 따라 추가 작업이 유기적으로 연결되도록 하여 에이전트 행동 패턴이 여러 단계에 걸쳐 지속적으로 발전하도록 지원한다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM Agent들이 대화형 질의응답을 넘어 디지털 환경에서의 자율적인 작업을 수행하는 단계로 발전함에 따라, Terminal Interface 기반의 복잡한 Long-Horizon Task 처리에 대한 필요성이 증대되고 있음을 지적한다. 기존 연구들은 주로 단기 궤적(short trajectories)을 통해 명령어 실행 및 도구 호출을 학습시켜왔으나, 이러한 짧은 궤적 데이터는 에이전트가 탐색을 통해 증거를 축적하고, 판단에 활용하며, 피드백에 기반하여 전략을 지속적으로 조정하고, 중간 결과를 최종 결과물로 전환하는 Long-Horizon Task에 필요한 Agentic Behavioral Patterns을 완전히 학습시키기에는 한계가 있다 [Figure 1].
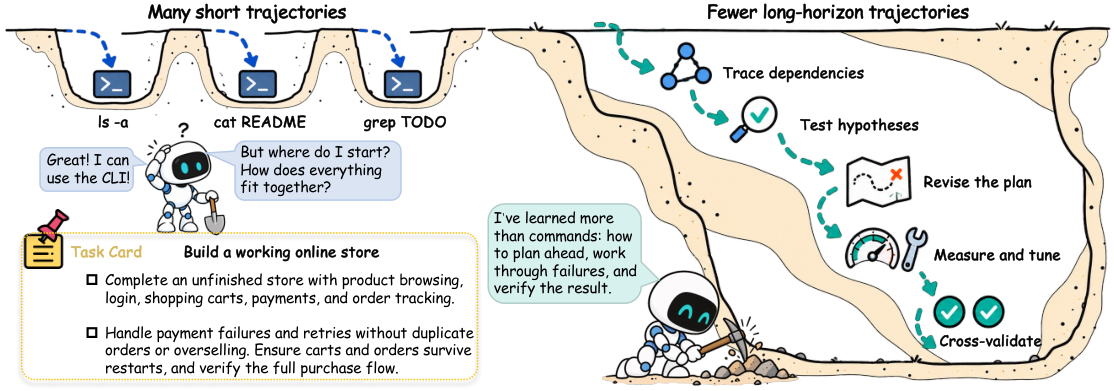
*Figure 1 — TerminalHorizon 동기 부여*
고품질 Long-Horizon 궤적 데이터는 이러한 Agentic Behavioral Patterns과 단일 문제 해결 과정 내에서의 연결성을 포착하여 지속적인 자율 작업을 위한 풍부한 경험을 제공한다. 그러나 Long-Horizon 궤적을 합성하는 데에는 두 가지 주요 과제가 존재한다. 첫째, 복잡한 태스크가 반드시 의도된 Agentic Behavioral Patterns을 유발하지는 않는다. 환경 합성 과정에서 핵심적인 분석, 구현, 검증 작업이 미리 완료되거나 간소화될 경우, 에이전트의 탐색이나 구현 노력이 생략되어 의도된 행동 패턴이 충분히 발현되지 못할 수 있다. 둘째, 이러한 패턴이 나타나더라도, Long-Horizon 훈련 데이터는 여러 단계에 걸쳐 패턴이 전개되고 연결되는 방식을 포착해야 한다. 단순히 태스크의 난이도를 높이거나 상호작용 턴(interaction turns) 수를 늘리는 것만으로는 이러한 패턴의 확장이나 연결성이 강화되지 않는다. 따라서, 기존 솔루션의 한계를 넘어서는 새로운 요구사항을 도입하면서도 동일한 목표를 유지하고, 초기 판단, 행동, 결과에 기반하여 패턴이 지속적으로 발전하도록 하는 새로운 데이터 합성 접근 방식이 절실히 요구된다.
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Long-Horizon Terminal Intelligence를 위한 완전 자동화된 데이터 합성 엔진인 **TerminalHorizon**을 제안한다. 이 방법론은 크게 두 단계인 **Challenge-Guided Long-Horizon Synthesis**와 **Progressive Horizon Expansion**으로 구성된다.
첫 번째 단계인 **Challenge-Guided Long-Horizon Synthesis**는 실제 전문 문제를 실행 가능한 태스크 환경으로 변환하는 것으로 시작한다. 이후, 태스크 구축에 참여하지 않은 Independent Challenger Agent가 이 태스크를 해결하는 궤적(trajectory)을 생성한다. 이 궤적에 대한 분석을 통해, 태스크 환경 설계 과정에서 에이전트가 수행해야 할 탐색, 진단, 구현, 검증 등의 핵심 작업이 의도치 않게 간소화되거나 이미 완료된 부분이 있는지 식별한다. 이러한 분석 결과를 바탕으로 환경 재구성(environment reconstruction)을 진행하여, 에이전트가 해당 작업을 직접 수행해야만 태스크를 완료할 수 있도록 환경을 수정한다. 이를 통해 에이전트의 실제 문제 해결 과정에서 필요한 Agentic Behavioral Patterns이 발현되도록 유도한다 [Figure 2].
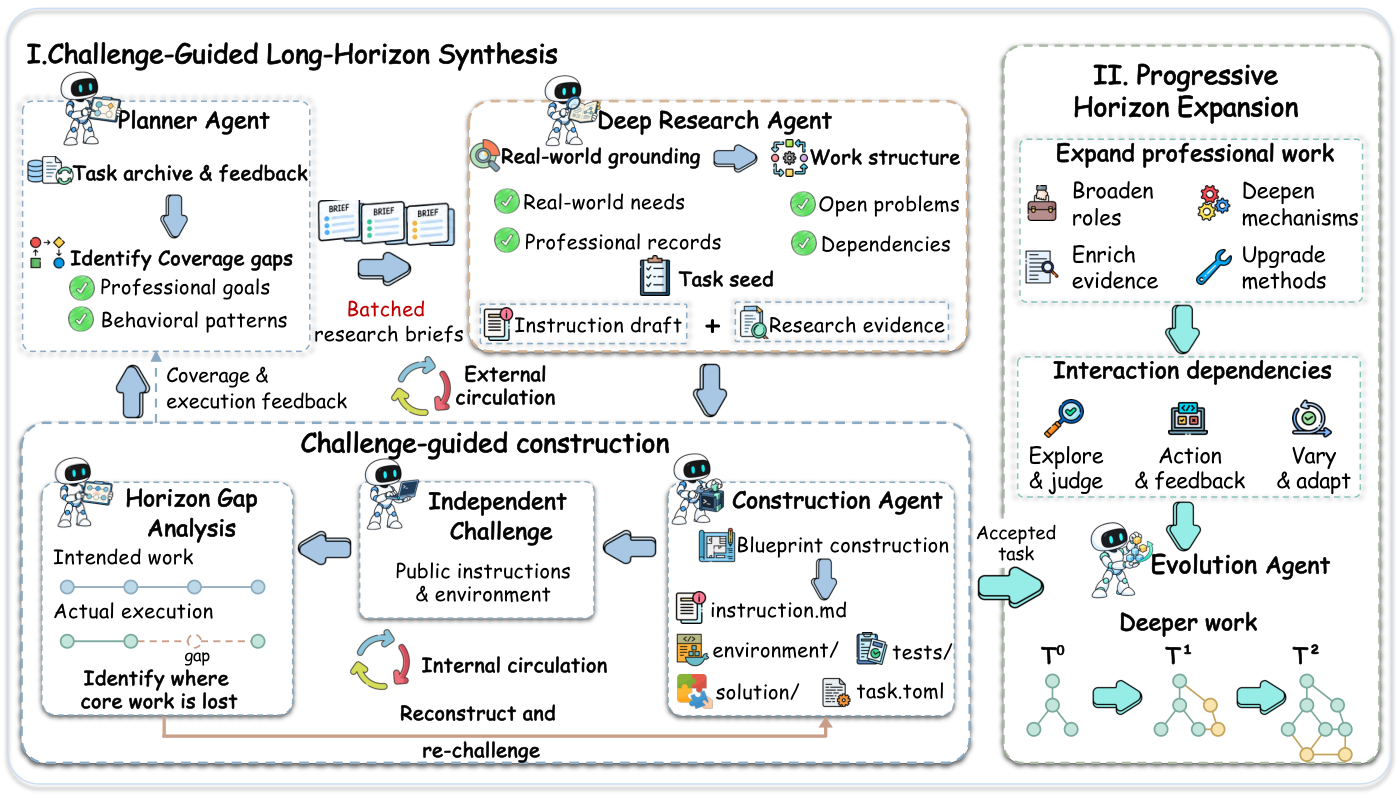
*Figure 2 — TerminalHorizon 개요*
두 번째 단계인 **Progressive Horizon Expansion**에서는 승인된 태스크를 동일한 목표 하에 점진적으로 확장한다. Evolution Agent는 기존 태스크의 확장 가치를 평가하고, 새로운 요구사항을 도입한다. 이 때, 새로운 요구사항은 이전 단계의 판단, 행동 및 결과에 의존하도록 설계되어, 에이전트가 Long-Horizon Task 전반에 걸쳐 Agentic Behavioral Patterns을 지속적으로 발전시키도록 유도한다 [Figure 2]. 이러한 두 단계의 통합적인 접근 방식은 에이전트의 탐색, 전략 수정, 검증 등의 행동이 태스크의 여러 단계에 걸쳐 연결되고 진화하는 고품질의 Long-Horizon 궤적을 효과적으로 생성한다 [Figure 3].
**TerminalHorizon** 엔진을 사용하여 **TerminalHorizon-3K** 데이터셋을 구축했으며, 이는 1,535개의 태스크 환경과 2,852개의 훈련 궤적으로 구성된다. 이 궤적들은 평균 **52.8** Interaction Turns를 기록하여, 비교 대상인 다른 터미널 태스크 합성 방법론들의 궤적보다 훨씬 길고, **25개**의 광범위한 전문 도메인을 포괄한다. 또한, 궤적은 평균 **8.6개**의 핵심 Agentic Behavioral Patterns을 포함하여 탐색, 구축, 오류 수정, 검증 등 다양한 행동 경험을 제공한다.
Supervised Fine-tuning(SFT)을 통해 **Qwen3.5-27B** 모델을 **TerminalHorizon-3K** 데이터셋으로 훈련하여 **TerminalHorizon-27B**를 얻었다. **TerminalHorizon-27B**는 **Terminal-Bench 1.0, 2.0, 2.1**, **AutomationBench**, **τ2-bench Airline/Retail**, **VitaBench Cross-domain**, 그리고 다섯 가지 일반 추론 벤치마크(MATH-500, GSM8K, AIME 2024/2025, KOR-Bench Cipher)를 포함한 총 **12개**의 벤치마크에서 기준 모델인 **Qwen3.5-27B** 대비 상당한 성능 향상을 달성했다. 특히, **Terminal-Bench 2.0**에서는 기준 모델 대비 **14.2%** 향상된 <strong>55.8%</strong>를 기록했으며, **Terminal-Bench 2.1**에서는 **13.85%** 향상된 <strong>60.67%</strong>를 달성했다 [Table 1, 2]. **AutomationBench**에서는 Pass Rate가 **11.7%**, Partial score가 **23.3%** 증가했으며, **VitaBench Cross-domain**에서도 <strong>11.3%</strong>의 성능 향상을 보였다 [Table 2]. 이러한 결과는 소량의 고품질 Long-Horizon 궤적 데이터가 에이전트의 능력을 효율적으로 확장하고, 코딩, 실제 생산성, 일반 추론 등 광범위한 영역에서 강력한 Transferability를 제공함을 입증한다.
## 4. Conclusion & Impact (결론 및 시사점)
본 연구는 Agentic Behavioral Patterns을 연결하는 Long-Horizon Trajectories를 자동으로 합성하는 엔진인 **TerminalHorizon**을 성공적으로 제시했다. **Challenge-Guided Reconstruction**과 **Progressive Expansion**이라는 독창적인 방법론을 통해, 이 엔진은 에이전트의 탐색, 전략 수정, 그리고 검증 행동을 단일의 공유된 목표 아래 유기적으로 연결한다. 이로 인해 에이전트는 복잡한 문제 해결 과정에서 실제적인 피드백을 활용하여 지속적으로 학습하고 발전할 수 있게 된다.
**TerminalHorizon-3K** 데이터셋으로 훈련된 **TerminalHorizon-27B** 모델은 코딩 에이전트 태스크, 실제 생산성 태스크, 일반 추론 태스크를 아우르는 **12개**의 벤치마크에서 기존 기준 모델 대비 모든 항목에서 성능 향상을 달성하며 그 효과성을 입증했다. 특히, **12시간**의 연구 예산이 주어진 Recursive Self-Improvement (RSI) 케이스 스터디에서, 모델은 초기 솔루션을 넘어 지속적으로 실험하고, 피드백에 기반하여 방법론을 개선하며, 이러한 효과적인 개선 사항을 최종 결과물에 반영하는 뛰어난 능력을 보였다 [Figure 7].
이러한 연구 결과는 Long-Horizon Behavioral Experience가 에이전트의 훈련에 있어 매우 중요한 가치를 지니며, 단순한 로컬 터미널 작업 실행을 넘어 지속적인 자율 작업(sustained autonomous work)을 수행하는 고도화된 에이전트로 발전시키는 데 핵심적인 역할을 함을 강력히 시사한다. **TerminalHorizon**은 복잡하고 실제적인 문제 해결 능력을 갖춘 차세대 AI 에이전트 개발을 위한 중요한 기반을 제공하며, 학계 및 산업계 전반에 걸쳐 자율 에이전트 기술의 발전에 크게 기여할 것으로 기대된다.
> ⚠️ **알림:** 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] CoVe: Training Interactive Tool-Use Agents via Constraint-Guided Verification
- [논문리뷰] GUI-Libra: Training Native GUI Agents to Reason and Act with Action-aware Supervision and Partially Verifiable RL
- [논문리뷰] A Goal Without a Plan Is Just a Wish: Efficient and Effective Global Planner Training for Long-Horizon Agent Tasks
- [논문리뷰] WebResearcher: Unleashing unbounded reasoning capability in Long-Horizon Agents
- [논문리뷰] ProgAgent: Learning Tool Orchestration through Programmatic Training
Review 의 다른글
- 이전글 [논문리뷰] Same Output, Different Gold: Measuring How Reference Choice Moves a Multilingual Benchmark Score
- 현재글 : [논문리뷰] Scaling Agentic Data for Long-Horizon Terminal Intelligence
- 다음글 [논문리뷰] SpatialASM: Internalizing Active Mentalization for Spatial Reasoning
댓글