[논문리뷰] Systematic Multi-Agent Vision-and-Language Navigation: Formulation, Benchmark, and Method
링크: 논문 PDF로 바로 열기
메타데이터
저자: Yunzhe Xu, Zhe Liu
1. Key Terms & Definitions (핵심 용어 및 정의)
- MAVLN: Systematic Multi-Agent Vision-and-Language Navigation의 약어로, 종속성(Dependency) 및 자원(Resource) 제약이 존재하는 환경에서 다수의 에이전트가 협력하여 임무를 수행하는 과제를 지칭합니다.
- TRISS: Topological Memory-based Collaborative Navigation and Subtask Scheduling의 약어로, 본 논문에서 제안하는 LLM 기반 다중 에이전트 네비게이션 및 협력 시스템입니다.
- Dependency & Resource Constraints: 다중 에이전트 작업에서 발생하는 제약 조건으로, 특정 하위 작업의 순서를 규정하는 DAG 구조의 종속성과, 특정 물체를 운반하거나(Holding chain) 특정 지점에 머물러야 하는(Presence lock) 자원 제약을 의미합니다.
- Topological Memory: 환경의 탐색된 노드와 공유 시각 정보를 포함하는 그래프 기반 메모리 구조로, 여러 에이전트가 팀 지식을 공유하여 효율적으로 탐색하고 계획을 세울 수 있도록 합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 기존의 Vision-and-Language Navigation (VLN) 연구가 주로 단일 에이전트나 단순한 협력 방식에 국한되어, 복잡한 현실 세계의 제약 조건을 반영하지 못한다는 문제 의식에서 출발합니다. 기존의 다중 에이전트 접근 방식은 작업 종속성이나 에이전트 간 물리적 충돌 해결을 간과하거나, 혹은 이미 알고 있는 환경 내에서의 계획에만 집중하여 미지의 환경으로의 일반화가 어렵다는 한계가 있습니다. 이러한 간극을 메우기 위해 본 논문은 미지의 환경에서 복잡한 다중 에이전트 협력을 요구하는 새로운 과제를 공식화하고 이를 위한 벤치마크와 시스템을 제안합니다 [Figure 1].
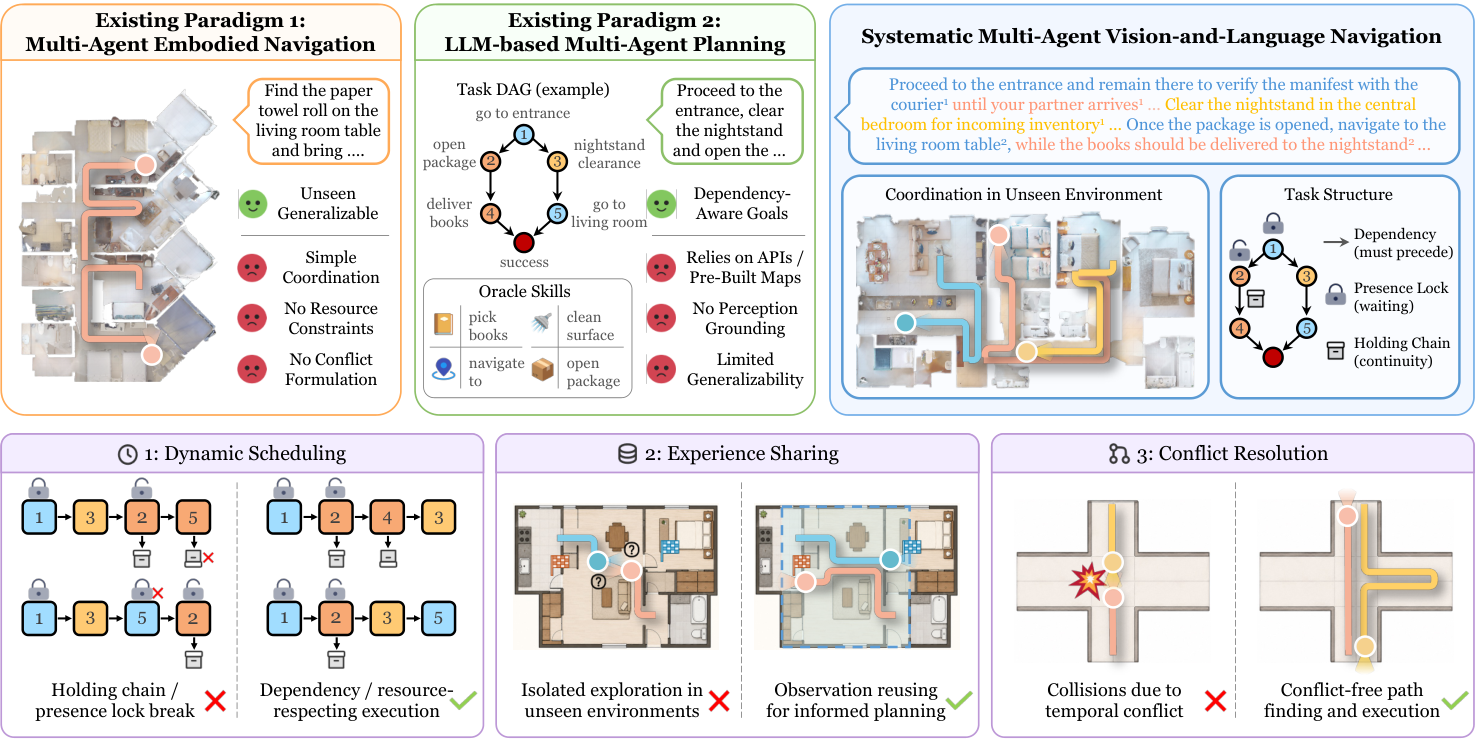
Figure 1 — 다중 에이전트 VLN 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 다중 에이전트의 효율적인 협력을 위해 TRISS 프레임워크를 제안합니다. TRISS는 크게 3가지 모듈로 구성됩니다: (1) LLM을 기반으로 작업 제약을 식별하고 원자적 지시사항(Atomic instruction)을 동적으로 할당하는 Subtask Scheduler, (2) 모든 에이전트가 공유하는 Topological Memory를 사용하여 경험을 통합하고 최적의 경로를 탐색하는 Navigation Planner, (3) 물리적 충돌을 방지하며 동시적인 의도를 충돌 없는 경로로 전환하는 Conflict-Aware Execution Mechanism입니다 [Figure 4]. 제안된 MAVLN 벤치마크는 11,724개의 에피소드와 145개의 환경을 포함하며, 기존 벤치마크 대비 복잡한 종속성 및 자원 제약을 도입하였습니다 [Table I]. 실험 결과, TRISS는 제안된 환경에서 효과적인 베이스라인으로서의 성능을 입증하였으나, 스케줄링, 계획, 실행의 각 단계에서 여전히 상당한 개선의 여지가 있음을 보여주며 다중 에이전트 협력의 난이도를 시사합니다.
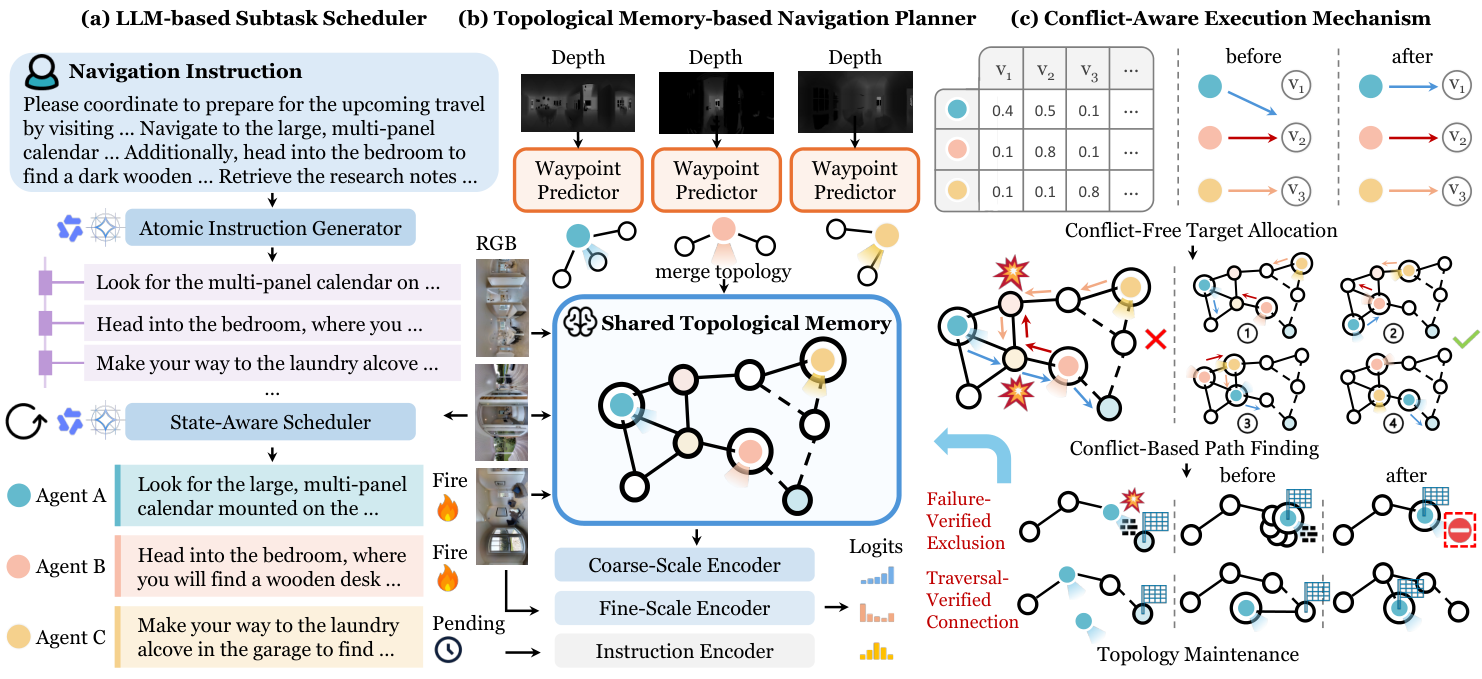
Figure 4 — TRISS 프레임워크 아키텍처
4. Conclusion & Impact (결론 및 시사점)
본 논문은 다중 에이전트 VLN을 종속성 및 자원 제약이 있는 협력 문제로 체계화하고, 이를 위한 새로운 벤치마크 MAVLN과 시스템 TRISS를 성공적으로 구축하였습니다. 이 연구는 embodied AI 분야에서 다중 에이전트 간의 정교한 조율과 경험 공유의 중요성을 강조하며, 향후 더 복잡한 실제 환경에서의 협동 로봇 시스템 설계를 위한 기초 연구로서 중요한 기여를 합니다. 특히 LLM 기반의 스케줄링과 topological memory의 결합은 미지의 환경에서 로봇 팀의 자율성을 크게 향상시킬 수 있는 가능성을 제시합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] MA-EgoQA: Question Answering over Egocentric Videos from Multiple Embodied Agents
- [논문리뷰] OmniEAR: Benchmarking Agent Reasoning in Embodied Tasks
- [논문리뷰] 3DCodeVerse: Exploring 3D Worlds as Code
- [논문리뷰] Towards Agentic Robots: Model, Data, Environment, and Harness
- [논문리뷰] UNITAS: A 3D-Native World Action Model for Embodied Manipulation
Review 의 다른글
- 이전글 [논문리뷰] SpatialASM: Internalizing Active Mentalization for Spatial Reasoning
- 현재글 : [논문리뷰] Systematic Multi-Agent Vision-and-Language Navigation: Formulation, Benchmark, and Method
- 다음글 [논문리뷰] T3lescope: Arbitrary-Resolution High-Fidelity Generative Surface Reconstruction from Images
댓글