[논문리뷰] VIS-Ground: Video Interactive Storytelling with Contextual Grounding
링크: 논문 PDF로 바로 열기
저자: Bingxuan Li, Yiwen Song, Xueqing Wu, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- VIS-Ground: 비디오 인터랙티브 스토리텔링을 위해 heterogeneous input(Grounding source, Video prefix, Viewer request)을 executable constraint model로 변환하는 프레임워크입니다.
- Structured Context Abstraction: 원시 입력 데이터를 entity, event, state transition이 포함된 구조화된 모델 M으로 추상화하는 과정입니다.
- Generation Constraints Induction: 추상화된 모델 M에서 파생된 dependency를 candidate continuation script에 맞게 generation constraint C로 변환하는 메커니즘입니다.
- VIS-Bench: Grounding source, video prefix, viewer intervention을 포함하는 비디오 인터랙티브 스토리텔링 평가를 위한 벤치마크입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 인터랙티브 비디오 생성 시 발생하는 복합적인 context 간의 의존성 문제를 해결하고자 합니다. 사용자의 요구사항은 단순히 단일 입력에 의존하는 것이 아니라, 이미 렌더링된 비디오 역사와 grounding source 간의 잠재적 의존성을 포괄해야 합니다. 기존의 생성 방식은 이러한 관계를 명시적으로 고려하지 않아 일관성 없는 상태 변화나 논리적 오류를 범하기 쉽다는 한계가 있습니다. [Figure 1]에서 제시하듯, Grounding source, Video prefix, User request가 공동으로 고려될 때만 비로소 일관성 있는 비디오 생성이 가능합니다.
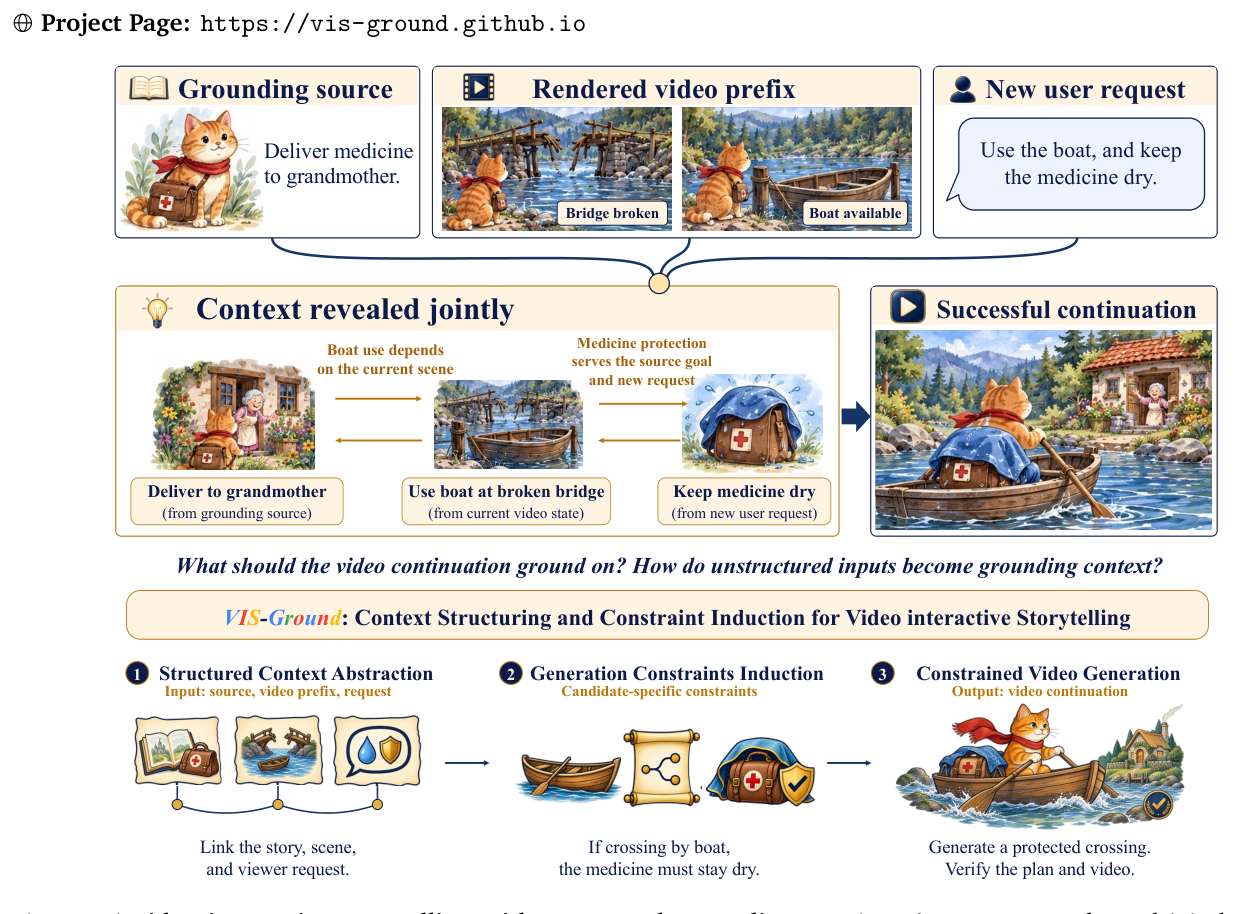
Figure 1 — 본 연구가 해결하고자 하는 핵심 문제와 프로세스 흐름을 보여주는 아키텍처 다이어그램
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 논문은 contextual grounding을 하나의 context compilation 문제로 정의하고, Structured Context Abstraction, Generation Constraints Induction, 그리고 Constrained Video Generation이라는 3단계 프로세스를 통해 이를 해결합니다. [Figure 3]은 제안된 프레임워크의 전반적인 구조를 보여주며, 이는 정교한 계획 수립과 검증, 수정 과정을 반복하는 iterative plan-verify-revise-render 루프를 통해 작동합니다. 특히, 생성된 스크립트와 영상이 grounded dependency를 위반할 경우, 구체적인 feedback을 통해 script를 수정함으로써 높은 일관성을 유지합니다. 실험 결과, Omni-1.1-Flash, Veo 3.1, MiniMax-H3의 세 가지 비디오 생성 백본에서 VIS-Ground는 가장 높은 composite score를 달성했습니다. 특히 가장 강력한 baseline 대비 평균 10.3점의 절대적 성능 향상을 기록하였으며, [Table 1]에 명시된 바와 같이 SF(Source Faithfulness), SC(Story Continuity), IF(Interaction Fulfillment) 등 모든 주요 지표에서 우수한 성능을 보였습니다.
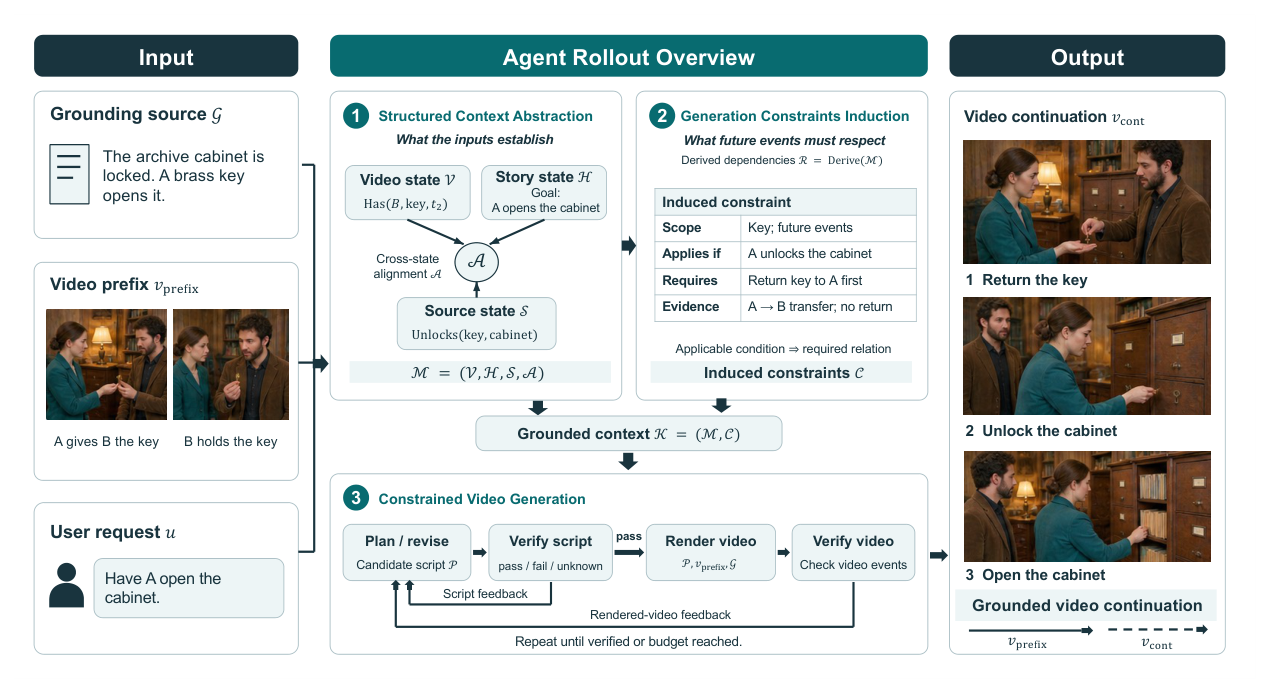
Figure 3 — VIS-Ground 프레임워크의 상세 단계별 구조를 나타내는 핵심 다이어그램
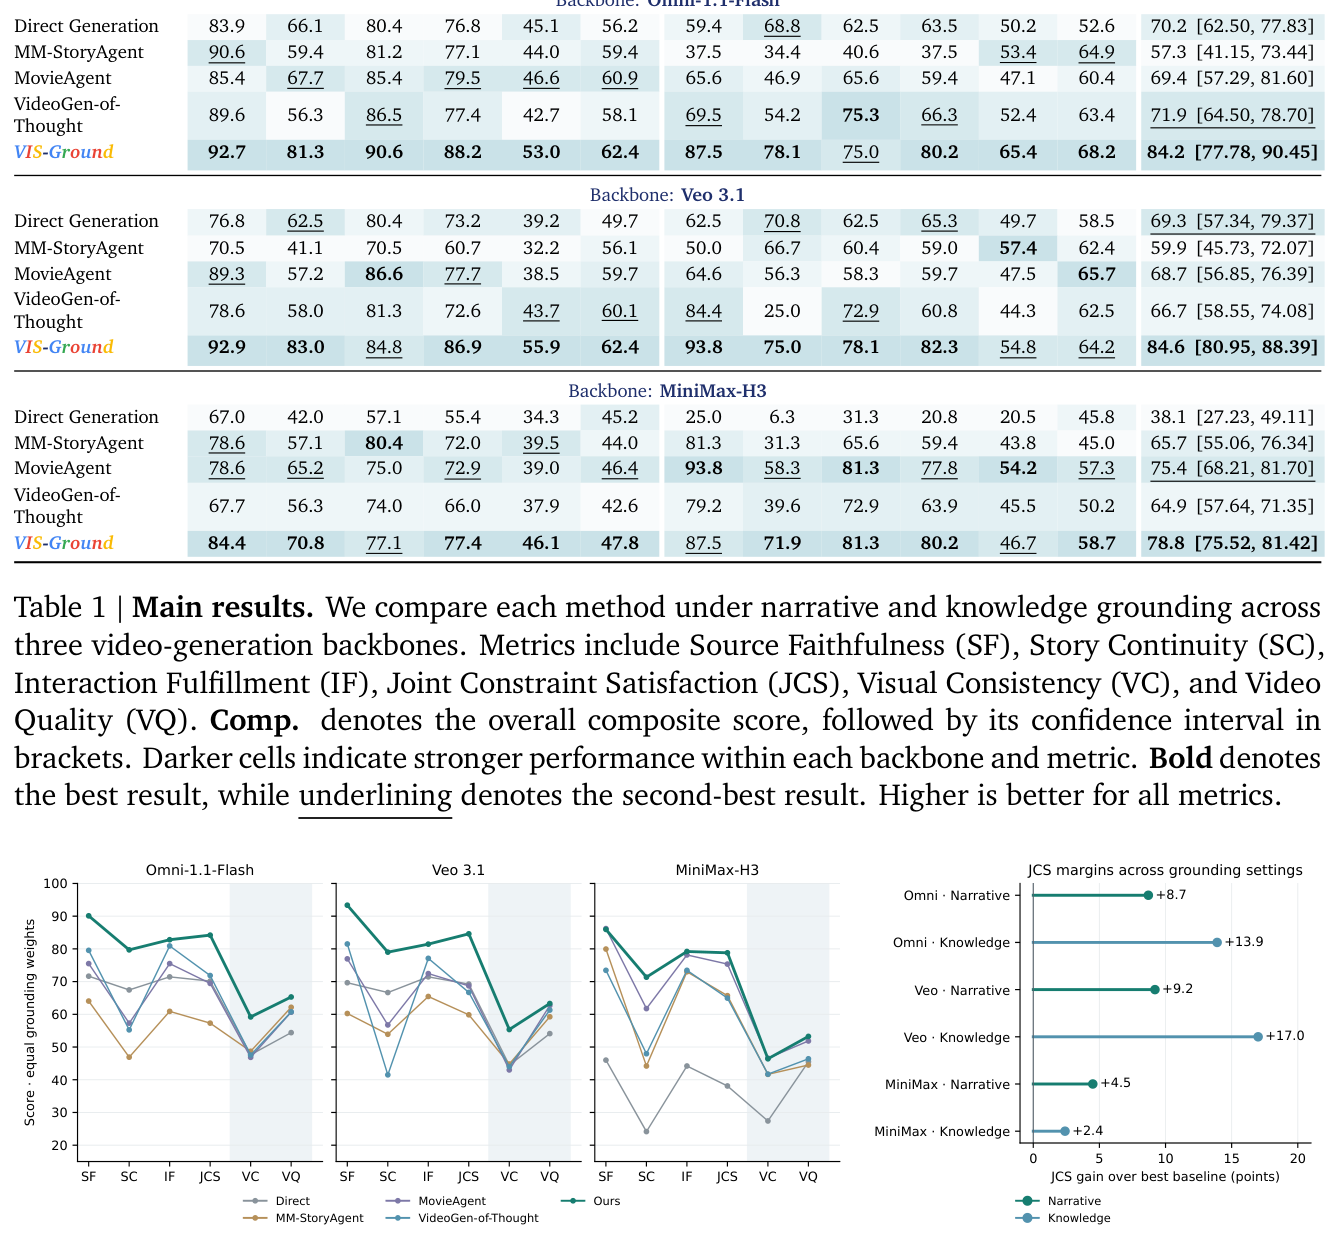
Table 1 — 3개 백본에 대한 실험 정량 결과 비교를 담은 핵심 테이블
## 4. Conclusion & Impact (결론 및 시사점) 본 연구는 비디오 인터랙티브 스토리텔링을 위한 효과적인 프레임워크인 VIS-Ground와 전용 벤치마크인 VIS-Bench를 도입하여 생성 일관성을 획기적으로 향상시켰습니다. 제안된 방법론은 복합적인 입력을 실행 가능한 제약 모델로 변환함으로써, 기계적 생성을 넘어선 agentic planning의 가치를 증명했습니다. 본 연구는 향후 사용자와 능동적으로 상호작용하는 복합 멀티미디어 시스템의 발전에 중요한 기초를 제공하며, 학계와 산업계 모두에서 요구되는 고품질, 다목적 비디오 콘텐츠 생성 기술의 핵심 지침이 될 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Quality-Guided Semi-Supervised Learning for Medical Image Segmentation
- [논문리뷰] AstroReason-Bench: Evaluating Unified Agentic Planning across Heterogeneous Space Planning Problems
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] WorldCast: Exploring Intelligent Visual Generation in World State Prediction
- [논문리뷰] Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
Review 의 다른글
- 이전글 [논문리뷰] UNITAS: A 3D-Native World Action Model for Embodied Manipulation
- 현재글 : [논문리뷰] VIS-Ground: Video Interactive Storytelling with Contextual Grounding
- 다음글 [논문리뷰] Visual Grounding Safety in Vision-Language Models
댓글