[논문리뷰] VITAL: From Visual Motion to Precise Action
링크: 논문 PDF로 바로 열기
메타데이터
저자: Alan Liang, Youquan Liu, Mingxiao Li, Wei Chow, Lingdong Kong, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- VITAL (Vision-Induced Tokens for Action Learning): 시각적 움직임 스캐폴드(visual motion scaffold)와 잔차(residual) 코드를 결합하여 주행 궤적을 정밀하게 재구성하고 예측하는 새로운 액션 토크나이저 프레임워크입니다.
- Visual Motion Scaffold: 기록된 시각적 데이터로부터 추출된 주행 궤적의 기본 골격으로, 전반적인 기동(maneuver)을 포착하지만 세부적인 미터법 오차를 포함합니다.
- Metric Residual: 시각적 스캐폴드와 실제 주행 궤적 사이의 오차를 인코딩한 정규화된 코드입니다. 이는 스캐폴드가 잡아내지 못한 centimeter-scale의 미세한 주행 세부 사항을 보정합니다.
- Flow Matching: 노이즈를 데이터로 변환하는 속도 필드를 학습하는 방식으로, VITAL에서는 시각적 조건(현재 이미지, 상태, 명령)으로부터 액션 코드를 효율적으로 예측하는 데 사용됩니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 기존 World-action 모델들이 시각적 예측과 실제 주행 액션 사이의 표현 격차(representation gap)를 효과적으로 메우지 못하는 문제를 해결하고자 합니다. 기존 연구들은 비디오 전문가와 액션 전문가가 독립적인 표현을 학습하도록 설계되어, 시각적 정보와 제어 액션 간의 정밀한 연결이 부족하다는 한계가 있습니다. 특히, 단순한 궤적 재구성을 넘어 실제 주행에 필요한 미터 단위의 정밀한 위치 보정이 필수적이나, 기존 모델들은 이를 달성하기 어렵습니다 [Figure 1]. 이를 해결하기 위해 저자들은 시각적 움직임에서 직접 액션 타겟을 도출하고, 이를 정밀하게 보정할 수 있는 구조적 접근 방식이 필요하다고 판단하였습니다.
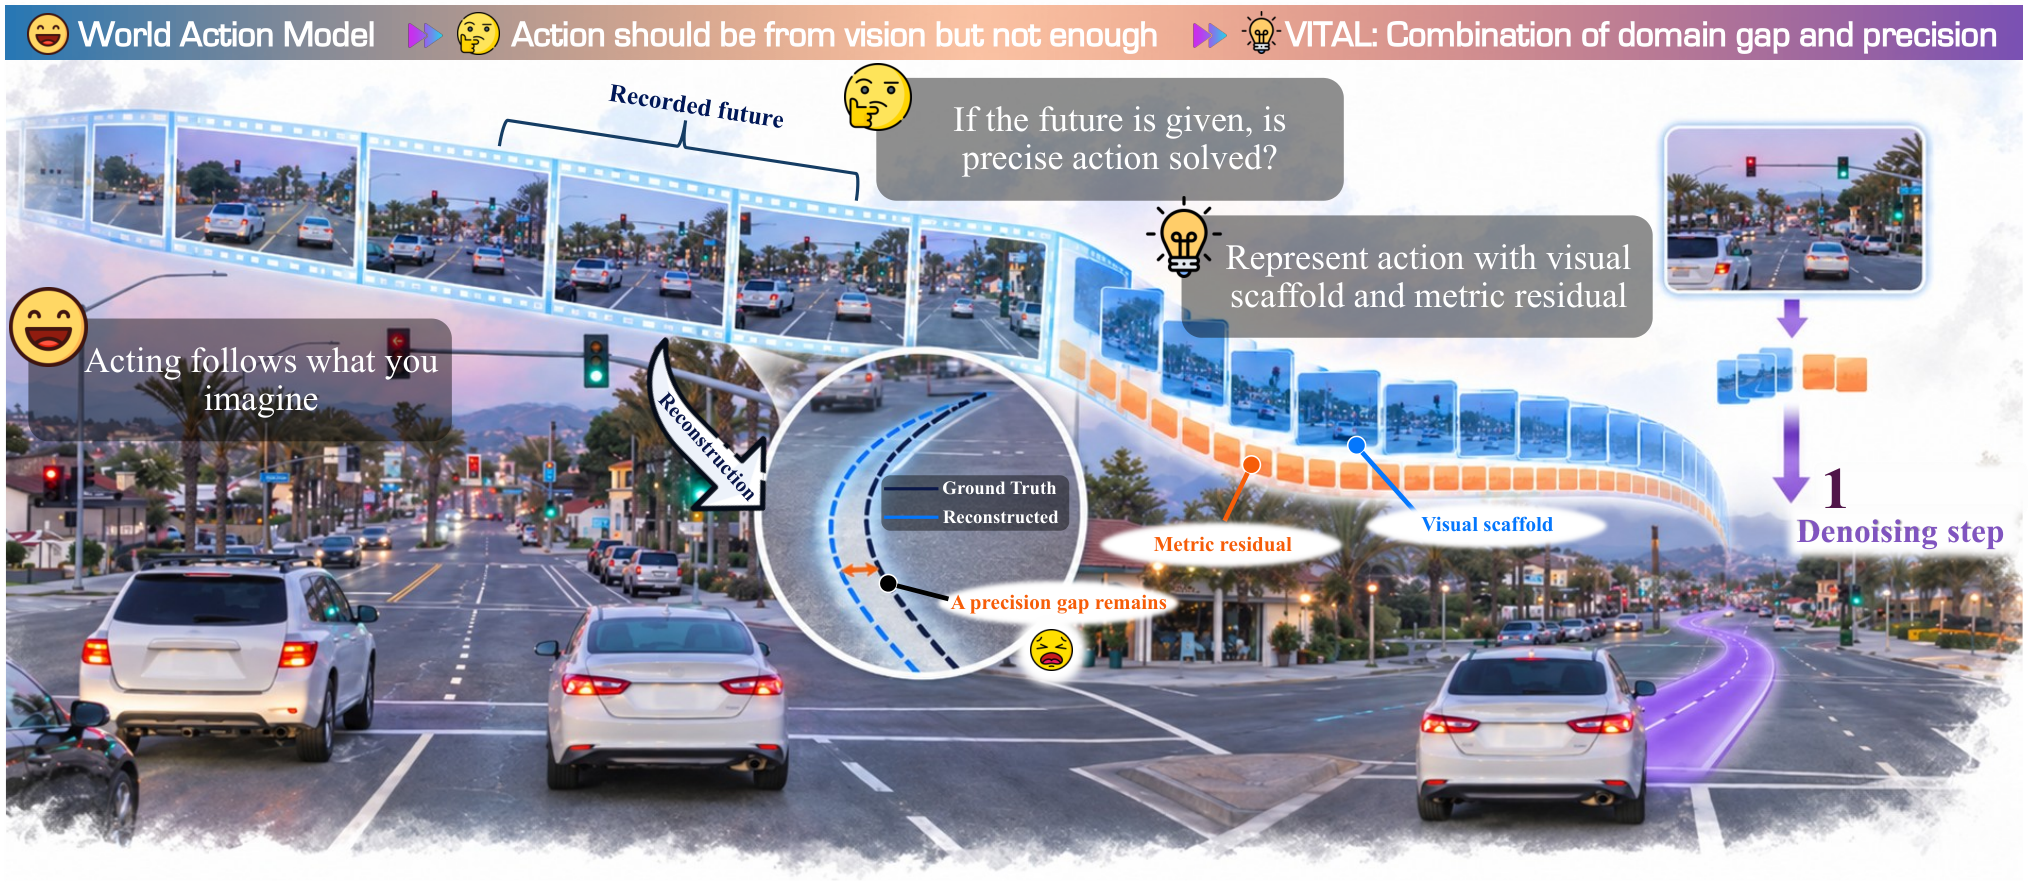
Figure 1 — World-action 모델의 시각적 움직임 기반 액션 학습 구조
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 시각적 움직임과 잔차를 분리하여 학습하는 VITAL 방법론을 제안합니다. 제안 모델은 비전 인코더를 통해 추출된 모션 스캐폴드를 기본 경로로 설정하고, 이에 대응하는 미터법 잔차(metric residual)를 함께 학습하여 액션 정밀도를 극대화합니다 [Figure 3]. Flow matching 기법을 통해 현재의 이미지, ego state, 내비게이션 명령만으로 두 구성 요소를 공동으로 예측하며, 별도의 미래 이미지 생성 과정 없이 추론이 가능합니다. 실험 결과, NAVSIM v1 navtest 기준 90.8 PDMS를 달성하였으며, 이는 10단계 추론 성능과 불과 0.13 포인트 차이임에도 불구하고 3.29배 빠른 End-to-End 추론 속도를 보입니다. 또한, 잔차 기반의 강화학습(Residual reinforcement learning)을 적용하여 사전 학습 없이도 NAVSIM v2 navtest에서 91.1 EPDMS, navhard 환경에서 38.6 EPDMS를 기록하며 우수한 정량적 지표를 확보하였습니다.
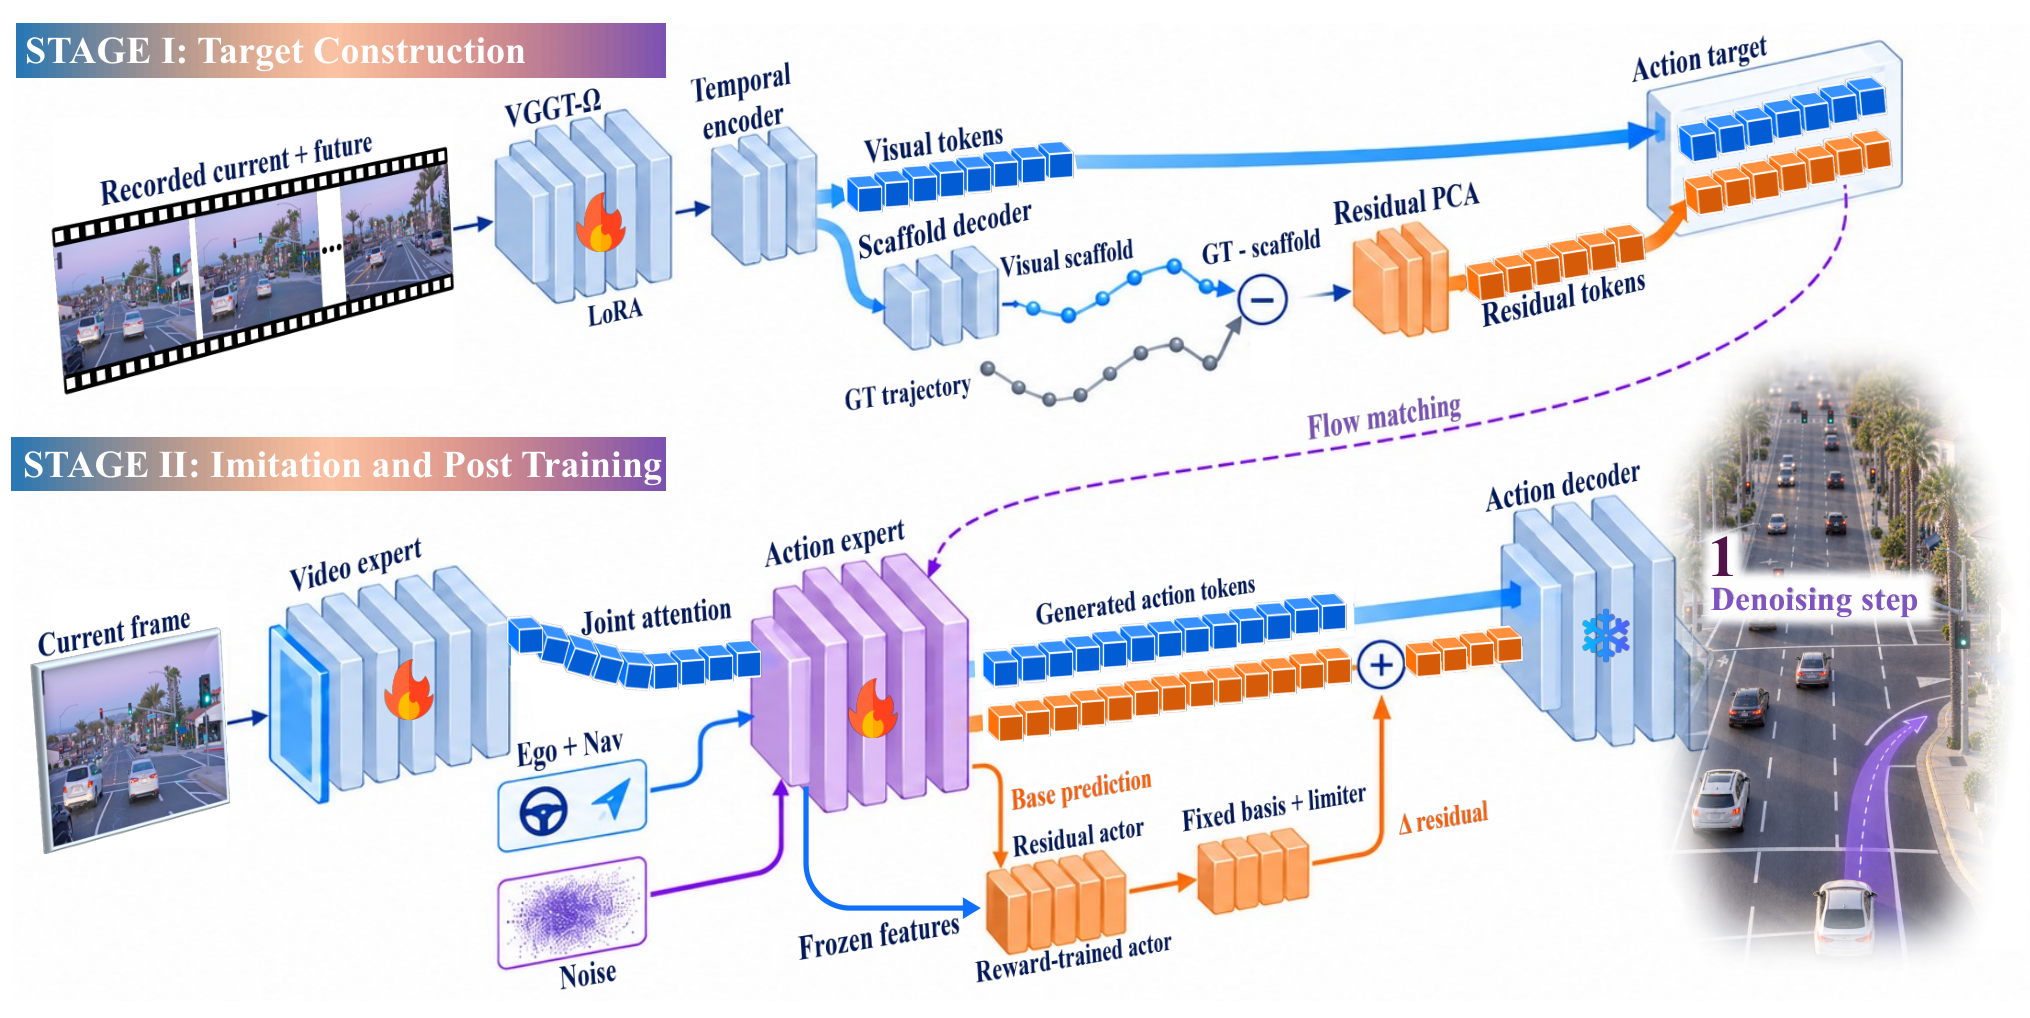
Figure 3 — VITAL의 전체 아키텍처 및 잔차 보정 흐름
4. Conclusion & Impact (결론 및 시사점)
본 연구는 시각적 움직임에서 파생된 모션 스캐폴드와 미터법 잔차를 분리하여 예측하는 VITAL을 통해 자율주행 액션 학습의 효율성과 정밀도를 동시에 달성했습니다. 잔차 기반의 보정 메커니즘은 추가적인 추론 비용 없이 정밀한 궤적 제어를 가능하게 하여, 복잡한 주행 환경에서의 실행 능력을 향상시킵니다. 이 연구는 학계에 시각적 기반 제어(vision-induced control)의 새로운 표준을 제시하며, 향후 더 효율적이고 안전한 자율주행 에이전트 구현을 위한 토대를 마련했습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Retrieve, Don't Retrain: Extending Vision Language Action Models to New Tasks at Test Time
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] WorldCast: Exploring Intelligent Visual Generation in World State Prediction
- [논문리뷰] Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
- [논문리뷰] Virtual Head Attention
Review 의 다른글
- 이전글 [논문리뷰] Towards Agentic Robots: Model, Data, Environment, and Harness
- 현재글 : [논문리뷰] VITAL: From Visual Motion to Precise Action
- 다음글 [논문리뷰] What Makes a Social Agent's Interactions Effective? Learning from Verifiable Outcomes in Paired Worlds
댓글