[논문리뷰] Do Better Visual Representations Always Lead to Better End-to-End Autonomous Driving?
링크: 논문 PDF로 바로 열기
저자: Zihao Zhang, Haochen Tian, et al.
키워: Visual Foundation Models (VFMs), End-to-End Autonomous Driving, Representation Alignment, Planner-Agnostic Framework, Auxiliary Perception Supervision, NAVSIM v2, HUGSIM
1. Key Terms & Definitions (핵심 용어 및 정의)
- Visual Foundation Models (VFMs): Semantic understanding 및 3D geometry에 뛰어난 성능을 보이는 대규모 비전 모델로, end-to-end autonomous driving 시스템에 점점 더 많이 통합되고 있습니다.
- End-to-End Autonomous Driving: 센서 입력으로부터 직접 planning 및 control을 학습하는 패러다임으로, cascading error를 줄이고 real-world deployment의 확장성을 목표로 합니다.
- EPDMS (Extended Predictive Driver Model Score): NAVSIM v2 벤치마크에서 사용되는 rule-based planning metric으로, driving quality score의 가중 평균과 multiplicative penalty를 결합하여 autonomous driving 성능을 평가합니다.
- ViRA (VFM-guided representation alignment framework): Planner의 architecture 및 inference cost를 변경하지 않고, planner의 intermediate feature를 frozen VFM target의 feature와 align하도록 돕는 planner-agnostic framework입니다.
- Auxiliary Perception Supervision: Planner 학습 시 detection, segmentation 또는 depth estimation과 같은 추가적인 perception task supervision을 사용하여 planner의 representation quality를 향상시키는 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 Visual Foundation Models (VFMs)의 강력한 representation이 end-to-end autonomous driving 성능을 항상 일관되게 향상시키는지에 대한 불확실성을 해결하고자 합니다. 기존 연구들은 주로 단일 planner-VFM 조합에 초점을 맞춰, 다양한 planner와 VFM pairing 간의 planning gain을 체계적으로 비교하는 데 한계가 있었습니다. 특히, VFM이 visual task에서 보여주는 장점이 driving performance로 일관되게 이어지는지 명확하지 않아, VFM을 autonomous driving 시스템에 통합하는 과정에서 VFM target 선택 및 supervision 전략의 중요성에 대한 이해가 부족했습니다. 이러한 불확실성은 VFM의 잠재력을 최대한 활용하고 안전하며 신뢰할 수 있는 autonomous driving 시스템을 개발하는 데 중요한 과제로 작용합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 이러한 문제를 해결하기 위해 ViRA (VFM-guided representation alignment framework)를 제안합니다 [Figure 1(a)]. ViRA는 planner의 architecture와 inference cost를 변경하지 않고, planner의 intermediate feature를 frozen VFM target의 feature와 align시킵니다. 방법론은 Spatial Dependency Alignment (SDA)와 Scene Semantic Alignment (SSA)라는 두 가지 objective를 통해 VFM의 강력한 representation을 planner encoder로 전이시키는 데 중점을 둡니다. SDA는 spatial attention distribution을, SSA는 global semantic embedding을 정렬합니다. 실험은 regression-based TransFuser, diffusion-based DiffusionDrive, scoring-based Rap* 등 다양한 end-to-end planner와 DINOv3, VGGT, DA3, SAM3, DVGT 등 여러 VFM target을 사용하여 NAVSIM v2 및 zero-shot HUGSIM 벤치마크에서 수행되었습니다.
주요 실험 결과는 다음과 같습니다:
- ViRA를 통한 VFM-guided visual representation은 다양한 end-to-end planner 전반에 걸쳐 driving performance를 일관되게 향상시켰으며, NAVSIM v2 navtest에서 평균 7.9 EPDMS points, navhard에서 평균 8.6 EPDMS points의 gain을 보였습니다 [Table 1, Table 2]. 특히, ViRA-Diffusion은 NAVSIM v2 navtest에서 92.3 EPDMS를 달성하며 최신 기술 대비 1.9 points 높은 성능을 기록했습니다 [Table 7].
- VFM target의 선택이 planning performance에 중요하게 작용함을 확인했습니다. Rap*의 경우, VFM target에 따라 EPDMS gain이 6.6에서 12.1 points까지 다양하게 나타났으며, DINOv3가 가장 큰 gain을 보였습니다 [Table 6]. 심지어 DINOv3 backbone을 사용하는 경우에도 VGGT와 alignment하면 EPDMS가 추가로 2.5 points 향상되었습니다.
- Auxiliary perception supervision이 VFM target 선택에 대한 민감도를 감소시킴을 발견했습니다 [Figure 1(c-iii)]. auxiliary supervision이 없는 경우, TransFuser의 EPDMS gain spread가 0.5에서 2.7 points로 증가하여, supervision이 없는 경우 VFM target 선택에 더욱 민감해집니다. 이 연구는 inference cost 증가 없이 VFM representation의 이점을 활용하는 실용적인 방법을 제시합니다 [Figure 4].
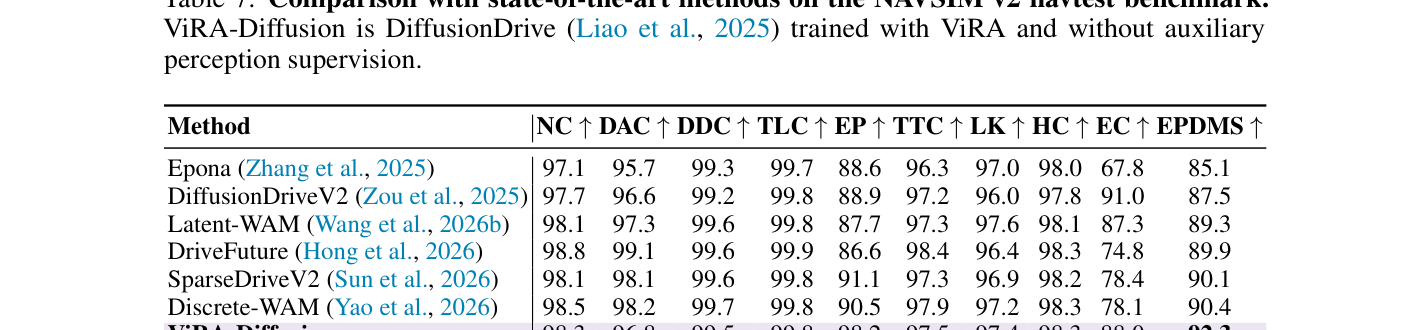
Table 7 — ViRA-Diffusion이 auxiliary perception supervision 없이 NAVSIM v2 navtest에서 달성한 최신 기술 대비 성능 우위를 보여주는 핵심 결과 테이블
4. Conclusion & Impact (결론 및 시사점)
본 연구는 VFM-guided visual representations가 다양한 planner와 벤치마크에서 end-to-end autonomous driving 성능을 지속적으로 향상시키지만, 그 효과는 VFM target의 선택과 auxiliary perception supervision의 유무에 크게 좌우된다는 점을 명확히 밝혔습니다. ViRA framework는 planner-agnostic하면서도 inference cost를 추가하지 않고 강력한 VFM representation을 통합하는 효과적인 방법을 제공합니다. 이러한 연구 결과는 VFM target 선택과 planner supervision 전략을 통합적으로 고려하는 것이 최적의 autonomous driving 성능을 달성하는 데 필수적임을 시사합니다. 특히, ViRA-Diffusion은 auxiliary perception supervision 없이 DINOv3 alignment만으로 최고 수준의 성능을 달성하여, 실용적인 자율주행 시스템 개발에 중요한 지침을 제공하고 VFM 통합의 새로운 방향을 제시합니다.
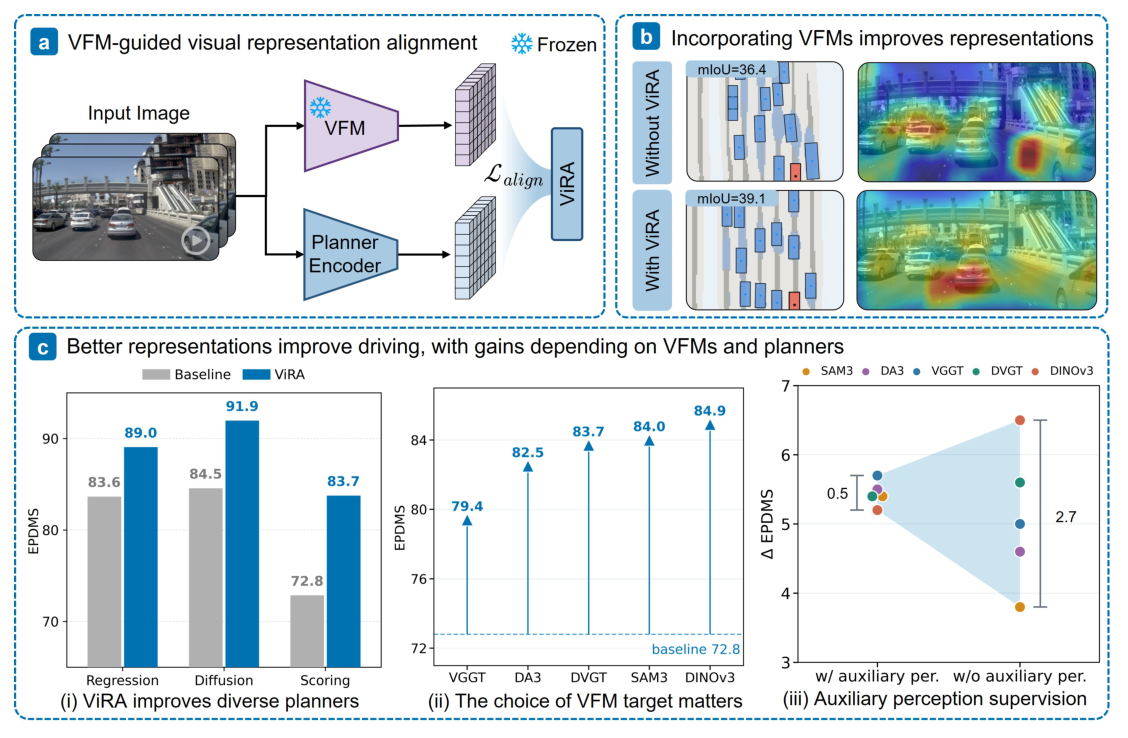
Figure 1 — ViRA 프레임워크의 전체적인 개념, VFM 통합 효과 및 주요 정량적 결과 요약을 보여주는 핵심 다이어그램
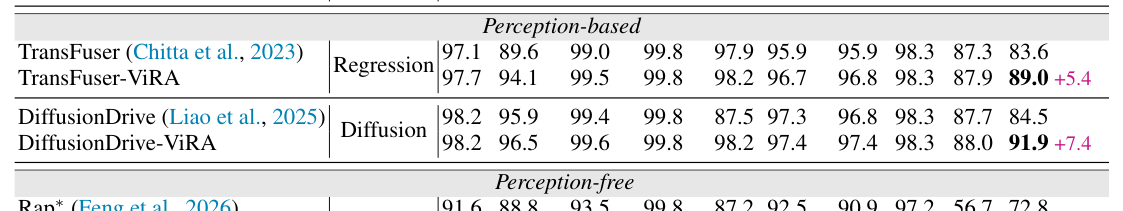
Table 1 — ViRA를 적용한 다양한 Planner들의 NAVSIM v2 navtest 벤치마크 성능 향상을 보여주는 핵심 결과 테이블
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] WorldCast: Exploring Intelligent Visual Generation in World State Prediction
- [논문리뷰] Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
- [논문리뷰] Virtual Head Attention
- [논문리뷰] VLA-Δ: Learning Physical State Transition for Vision-Language-Action Models
Review 의 다른글
- 이전글 [논문리뷰] DeltaStreamer: Towards Human-Like Agentic Streaming Video Understanding
- 현재글 : [논문리뷰] Do Better Visual Representations Always Lead to Better End-to-End Autonomous Driving?
- 다음글 [논문리뷰] EdgeWise: Bringing Long-Horizon Agents to the Edge via Selective Cloud Delegation
댓글