[논문리뷰] Learning Where to Split: Dynamic Band Splitting for Audio Source Separation
링크: 논문 PDF로 바로 열기
저자: Bingzhe Zhang, Kai Li, Xiaolin Hu et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Dynamic Band Splitting (DBS): Audio mixtures에 대해 고정된 band-token budget 내에서 frequency boundary 위치와 band width를 적응적으로 학습하는 end-to-end framework.
- Band-Split Architectures: 계산 비용을 줄이기 위해 스펙트럼을 미리 정의된 frequency bands로 나누고 각 band를 token으로 인코딩하는 기존 오디오 소스 분리 모델 아키텍처.
- Hard Top-KK: DBS에서 content-conditioned boundary scores를 기반으로 fixed frequency blocks 내에서 지정된 수의 band boundaries를 선택하는 메커니즘.
- SI-SDR (Scale-Invariant Signal-to-Distortion Ratio): 오디오 소스 분리 품질을 평가하는 데 사용되는 주요 objective metric으로, 데시벨(dB) 단위로 측정되며 값이 높을수록 더 나은 분리 성능을 의미한다.
- STFT (Short-Time Fourier Transform): 오디오 신호를 주파수-시간 영역의 complex spectrogram으로 변환하여, 시간 경과에 따른 주파수 콘텐츠를 분석하는 데 사용되는 수학적 변환.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 오디오 소스 분리 모델이 미세한 spectral structure를 효율적으로 보존해야 하지만, 기존 band-split architectures의 고정된 frequency boundaries가 성능에 한계를 가짐을 지적한다. 기존의 BSRNN, BS-RoFormer, TIGER와 같은 대다수의 band-split method들은 모든 mixture에 동일한 frequency layout을 적용하고 있다. 이러한 고정된 frequency resolution 할당 방식은 source content에 따라 informative spectral structure가 달라진다는 점을 반영하지 못한다. 결과적으로, 넓은 band가 여러 discriminative component들을 하나의 representation으로 압축하거나, 불필요하게 세분화된 band가 정보가 적은 콘텐츠를 커버하여 비효율성을 초래할 수 있다. 이로 인해 고정된 band representation 수 내에서 각 mixture에 맞게 frequency resolution 할당을 적응시키는 것이 중요한 도전 과제로 남아 있다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 mixture-dependent frequency partitions를 학습하는 end-to-end framework인 Dynamic Band Splitting (DBS)을 제안한다. DBS는 spectrogram의 frequency axis를 fixed frequency blocks로 나누고, 각 block 내에서 content-dependent boundary scores를 예측한다 [Figure 2]. 이후 Hard Top-KK selection을 통해 정해진 수의 contiguous bands를 형성하며, 이들의 위치와 폭은 mixtures에 따라 동적으로 변화한다 [Figure 1, Figure 3]. Band tokenization 과정에서는 variable width를 가진 bands를 content-dependent pooling을 통해 fixed-dimensional tokens로 변환하며, 분리(separation) 후에는 separated tokens를 original STFT grid로 확장하고 frequency refinement를 거쳐 complex masks를 디코딩하여 full-resolution reconstruction을 수행한다 [Figure 4]. 특히, hard boundary decision으로 인한 미분 불가능성 문제는 Straight-Through Estimator와 boundary-density regularizer를 활용한 end-to-end training으로 해결한다.
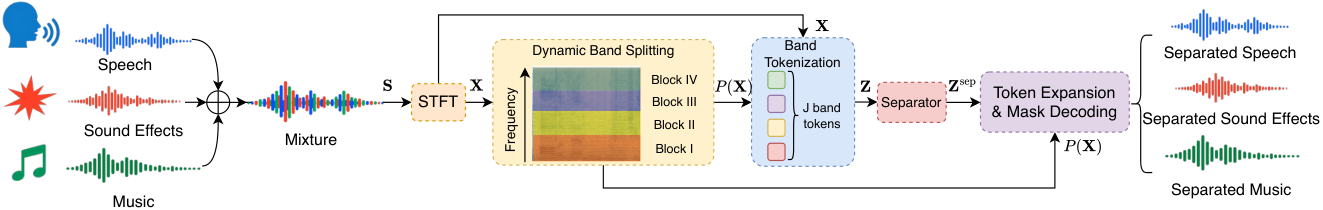
Figure 2 — DBS 전체 아키텍처 개요
주요 실험 결과에 따르면, DBS는 여러 벤치마크와 backbone 모델에서 우수한 성능 향상을 입증했다. DnR v2 데이터셋에서 DBS-BSRNN은 BSRNN 대비 평균 SI-SDR을 7.69 dB에서 9.07 dB로 1.38 dB (상대적으로 29.0% 상당) 향상시켰으며, DBS-TIGER 또한 평균 SI-SDR에서 1.39 dB의 이득을 보였다. MUSDB18-HQ 데이터셋에서는 DBS가 BSRNN, BS-RoFormer, MelRoFormer 세 가지 backbone 모두에서 평균 four-stem SDR을 개선했으며, 특히 DBS-BS-RoFormer는 4.50 dB에서 6.34 dB로 1.84 dB의 가장 큰 폭의 성능 향상을 달성했다. EchoSet 데이터셋에서도 DBS-BSRNN은 기존 BSRNN baseline 대비 SDRi 0.46 dB, SI-SDRi 0.43 dB의 개선을 보였다. 이러한 결과들은 DBS가 고정된 band-token budget 하에서 content-adaptive frequency partitioning을 통해 다양한 소스 분리 태스크에서 성능을 향상시킬 수 있음을 명확히 보여준다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 고정된 band-token budget 내에서 mixture에 따라 frequency boundaries를 적응적으로 조정하는 Dynamic Band Splitting (DBS) 프레임워크를 성공적으로 제안했다. DBS는 DnR v2, MUSDB18-HQ, EchoSet 데이터셋에서 BSRNN, TIGER, BS-RoFormer, MelRoFormer 등 다양한 band-split backbones의 오디오 소스 분리 성능을 일관되게 향상시켰다. 특히, boundary placement의 최적화가 소스 분리 품질에 중요한 영향을 미치며, per-block budgets, boundary scoring, frequency refinement와 같은 DBS의 핵심 구성 요소들이 성능 향상에 기여함을 ablation study를 통해 확인했다. 이 연구는 기존 band-split 아키텍처의 고정된 주파수 분할 방식의 한계를 극복하고, 입력 오디오 콘텐츠에 맞춰 주파수 대역을 동적으로 조정함으로써 소스 분리 성능을 크게 개선할 수 있음을 입증했다. 이는 오디오 소스 분리 분야에서 컴퓨팅 비용을 증가시키지 않으면서도 더욱 효율적이고 유연한 spectral representation 학습의 가능성을 제시하며, 다양한 음향 환경과 소스 유형에 대한 모델의 적응성을 높이는 데 중요한 시사점을 제공한다.
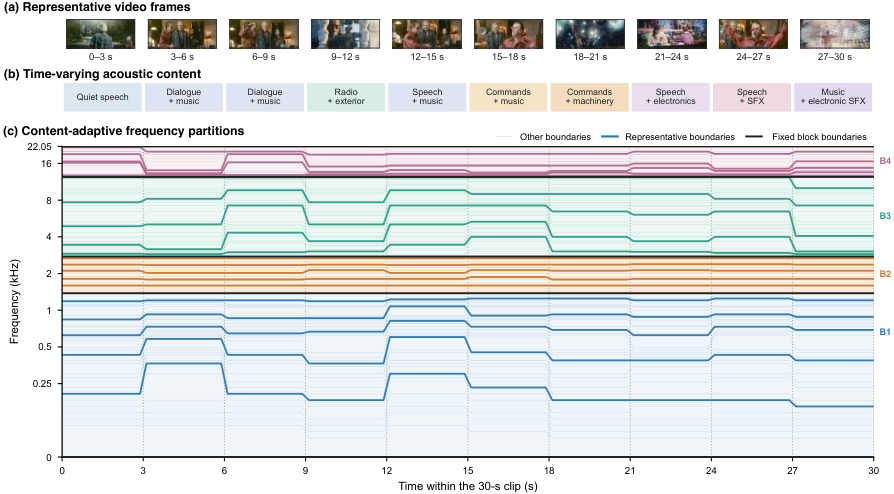
Figure 1 — DBS의 동적 주파수 분할 예시
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LeWAM: End-to-End World and Action Modeling with JEPAs
- [논문리뷰] Latent On-Policy Self-Distillation
- [논문리뷰] See like a Robot: Robot-Centric Pointmaps for Vision-Language-Action Models
- [논문리뷰] Representation Forcing for Bottleneck-Free Unified Multimodal Models
- [논문리뷰] From Pixels to Words -- Towards Native One-Vision Models at Scale
Review 의 다른글
- 이전글 [논문리뷰] Intern Lumina U2: A Multi-Codebook Diffusion Large Language Model for Omni-Visual Understanding and Image Generation
- 현재글 : [논문리뷰] Learning Where to Split: Dynamic Band Splitting for Audio Source Separation
- 다음글 [논문리뷰] MAI-Gym: An Open All-in-One Platform for GUI Agent Evaluation and RL Training across Mobile and Computer Environments
댓글