[논문리뷰] MAI-Gym: An Open All-in-One Platform for GUI Agent Evaluation and RL Training across Mobile and Computer Environments
링크: 논문 PDF로 바로 열기
The browsing was successful. I now have the content of the paper. I will proceed to extract the necessary information and format the output as requested.
Part 1: Summary - Information Extraction
- Authors: Panrong Tong, Quyu Kong, Pengxiang Li, Tianyu Xia, Hanzhang Zhou, Lei Wang, Chenglin Cai, Long Li, Long Chen, Jianan Zhang, Zhengwen Zeng, Xu Zhang, Gongjie Zhang, Yue Wang, Steven Hoi (from prompt and section 7 Contributions)
- Keywords: From abstract and introduction:
GUI Agent,Reinforcement Learning,Online RL,Environment Synthesis,Task Synthesis,Scalable Platform,Mobile Environments,Computer Environments,Mocked Apps,Cross-App World. I will choose 5-8.GUI Agents,Online Reinforcement Learning,Scalable Infrastructure,Environment Synthesis,Task Synthesis,Mobile UI,Desktop Automation.
Key Terms & Definitions:
- GUI Agent: Graphical User Interface (GUI)를 통해 모바일, 컴퓨터, 웹 환경에서 사용자와 상호작용하는 소프트웨어 에이전트.
- Online Reinforcement Learning (RL): 현재 Policy에서 Rollout을 수행하여 얻은 경험을 바탕으로 Policy를 실시간으로 업데이트하는 학습 방식.
- Environment Manager: MAI-Gym 플랫폼 내에서 다양한 GUI 환경 인스턴스(모바일, 컴퓨터, 웹)를 프로비저닝, 격리, 초기화 및 관리하는 핵심 컴포넌트.
- Mocked Apps: 실제 앱의 사용자 흐름을 재현하지만, Side-Effect 없이 Rollback 가능한 Backend를 가진 시뮬레이션 애플리케이션.
Real-World Clones와Novel Apps두 가지 유형이 있다. - Cross-App World: 여러 애플리케이션과 파일에 걸쳐 상호 연결된 정보와 기록을 포함하며, 일관된 Persona와 Scenario에 기반하여 구축되는 복합적인 초기 환경 상태.
Motivation & Problem Statement:
- Problem: Online Reinforcement Learning (RL)이 수학, 코딩, Tool-Use 분야에서 큰 발전을 이루었음에도 불구하고, GUI Agent 영역에서는 Scalability와 Realistic Training Task 부족으로 인해 어려움을 겪고 있다.
- Challenge 1: GUI 환경은 확장에 Cost가 많이 들고 일관성을 유지하기 어렵다. 각 Agent 시도는 격리된 환경 인스턴스를 필요로 하며, 대규모 Training Run은 수천 개의 인스턴스를 동시에 운영해야 하므로 높은 비용과 복잡성을 초래한다. 또한, 평가(Evaluation)와 훈련(Training)이 다른 Agent 구현체로 진행될 경우 성능 측정에 일관성이 저하될 수 있다.
- Challenge 2: Realistic한 GUI 학습을 위해서는 일관되고 초기화 가능한 환경 상태에 기반한 다양한 Task가 요구된다. 기존 Task Synthesis 방식은 주로 단일 파일 또는 공유 Sample Data에 의존하여 생성된 Task의 다양성과 현실성이 제한적이다. 또한, 실제 Transaction을 포함하는 애플리케이션은 Training에 부적합하거나 비현실적이며, 익숙하지 않은 Interface에 대한 Agent의 적응성 평가를 위한 새로운 애플리케이션의 필요성도 존재한다.
- Existing Limitations: 기존 GUI Gym들은 이러한 문제의 일부만 다루며, Scalable한 Infrastructure를 제공하는 Gym들은 주로 단일 플랫폼에 초점을 맞추고 수백 개의 환경만 병렬로 실행 가능하다. Data 중심의 Gym들은 새로운 앱과 Task를 제공하지만, Training Code나 기존 Benchmark를 실행하는 방법을 제공하지 않는다.
Method & Key Results:
- Proposed Method: MAI-Gym은 모바일, 컴퓨터, 웹 환경 전반에 걸쳐 GUI Agent 평가, 데이터 수집, 온라인 RL Training을 통합하는 All-in-One Platform을 제안한다. 핵심 설계 원칙은 Shared Rollout Path로, 동일한 Agent Harness를 사용하여 평가, 데이터 수집, 훈련 간의 일관된 Agent Behavior를 보장한다. MAI-Gym은 20,000개의 병렬 환경 인스턴스로 확장 가능하며, 10개의 기존 Benchmark를 지원한다. 시스템 아키텍처는 EnvClient를 통해 Instance를 얻고 Inference Engine에 질의하여 Rollout을 수행하는 Rollout Worker를 포함한다.
- Automated Synthesis: Scalable한 Infrastructure 외에도, MAI-Gym은 다양한 GUI 애플리케이션과 Challenging Task의 자동화된 Synthesis를 가능하게 한다. 이는 Reset 가능한
Mocked Apps(Real-World Clones 및 Novel Apps)와 실행 검증된 Task Verifier를 포함하는 일관된Cross-App World생성을 지원한다.Window-wise history관리 방식을 통해 Inference Engine의 KV Cache 재사용을 극대화하여 Multi-Turn Inference의 효율성을 높였다. - Key Results (MAI-Gym-9B):
- MAI-Gym을 사용하여 Mobile 및 Computer 사용을 위한 Unified 9B Agent인 MAI-Gym-9B를 훈련시켰다.
- MAI-Gym-9B는 MobileWorld에서 78.4%, OSWorld-Verified에서 76.2%의 성공률을 달성하여, 10B 미만의 오픈 GUI Agent 중 State-of-the-Art 성능을 기록했다. 이는 UI-Venus-2-9B (75.2%/70.8%) 및 SCALECUA-Qwen3.5-9B (12.8%/68.7%)와 같은 기존 오픈 Baseline을 크게 앞선다.
- Synthesized Task를 통한 RL Training은 SFT Warm-up Checkpoint 대비 모든 5개 Env OOD Benchmark에서 성능을 일관되게 향상시켰으며, 이는 Train Environment 외부로의 Generalization 능력을 입증한다.
- 특히,
Train-Ticketing App의Real-World Clone에서의 RL Training은 실제 물리적 Phone의 Real App에서 Task Success Rate를 28.8%에서 48.1%로 향상시키는Sim-to-Real Transferability를 보여주었다. Novel Apps에서의 Training 또한 Held-out Task Success를 25.8%에서 45.2%로 개선시켜, Synthesized Environment가 일반화 가능한 GUI Capability 학습에 미치는 긍정적인 영향을 시사한다.- Infrastructure는 모바일 환경에서 1,000개 인스턴스
Bring-up Time이 328.4초로 기존 추정치보다 6배 이상 빠르며,Window-wise history는Prefix-cache Hit Rate를 85.9%까지 높이고Training Input Token수를 84.7% 감소시켜Training Update Time을 62.6% 단축했다.
Conclusion & Impact:
- 본 논문은 모바일, 컴퓨터, 웹 환경 전반에 걸쳐 GUI Agent 평가 및 온라인 RL을 위한 All-in-One Open Platform인 MAI-Gym을 성공적으로 제시했다. Shared Rollout Path와 Agent Harness를 통해 평가와 훈련 간의 일관성을 확보하고, 최대 20,000개의 병렬 환경 인스턴스를 지원하는 뛰어난 Scalability를 입증했다.
- MAI-Gym이 제공하는 자동화된
Mocked Apps및Cross-App WorldSynthesis 기능은 Online RL에 필요한 다양하고 검증된 Task를 안정적으로 공급하여, 기존 GUI Gym의 한계를 극복하는 데 기여한다. - 훈련된 MAI-Gym-9B 모델은 MobileWorld에서 78.4%, OSWorld-Verified에서 76.2%라는 인상적인 성능을 달성하며, 10B 미만의 오픈 GUI Agent 중
State-of-the-Art를 수립했다. 특히,Real-World Clone에서의 학습이 실제 앱으로 성공적으로Transfer되는 결과는 GUI Agent의Generalization및Practical Applicability에 대한 중요한 시사점을 제공한다. - MAI-Gym은 프레임워크, Synthesis Skill, Mocked Apps, 2,000개의 검증된 Task, 그리고 모델 Checkpoint를 오픈 소스로 공개함으로써 GUI Agent 연구 분야의 Reproducible Research와 발전을 크게 촉진할 것으로 기대된다.
Part 2: Important Figure Information
I will now find the image URLs and create the JSON for up to 3 figures.
Figure 1: Overview of MAI-Gym.
src="2610.20939v1/fig1_mai_gym_overview.png"
Full URL: https://arxiv.org/html/2610.20939v1/fig1_mai_gym_overview.png
Caption: MAI-Gym 전체 개요
Figure 2: Architecture of MAI-Gym.
src="2610.20939v1/fig2_mai_gym_architecture.png" (found by inspecting Figure 2's img tag)
Full URL: https://arxiv.org/html/2610.20939v1/fig2_mai_gym_architecture.png
Caption: MAI-Gym 시스템 아키텍처
Figure 5: World, task, and verifier synthesis.
src="2610.20939v1/images/generated/fig5_environment_synthesis.png" (found by inspecting Figure 5's img tag)
Full URL: https://arxiv.org/html/2610.20939v1/images/generated/fig5_environment_synthesis.png
Caption: 환경 및 Task Synthesis 흐름
These three figures represent the overall system, its architecture, and the synthesis process, which are core to the paper's contribution.저자: Panrong Tong, Quyu Kong, Pengxiang Li, Tianyu Xia, Hanzhang Zhou, Lei Wang, Chenglin Cai, Long Li, Long Chen, Jianan Zhang, Zhengwen Zeng, Xu Zhang, Gongjie Zhang, Yue Wang, Steven Hoi, et al.
Part 1: 요약 본문
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- GUI Agent: Graphical User Interface (GUI)를 통해 모바일, 컴퓨터, 웹 환경에서 사용자와 상호작용하며 Task를 수행하는 인공지능 에이전트.
- Online Reinforcement Learning (RL): Agent가 실제 환경과 상호작용하면서 얻은 경험(Rollout)을 실시간으로 활용하여 Policy를 지속적으로 업데이트하는 학습 방법론.
- Environment Manager: MAI-Gym Platform 내에서 다양한 GUI 환경 인스턴스(모바일 디바이스, 데스크톱 가상 머신, 브라우저 등)를 효율적으로 프로비저닝, 격리, 초기화 및 관리하는 핵심 시스템 컴포넌트.
- Mocked Apps: 실제 애플리케이션의 핵심 사용자 흐름을 재현하지만, Side-Effect 없이 Backend 상태를 Reset 가능한 시뮬레이션 애플리케이션으로,
Real-World Clones와Novel Apps두 가지 유형이 있다. - Cross-App World: 여러 애플리케이션 및 파일에 걸쳐 상호 연결된 정보와 기록을 포함하며, 일관된 사용자 Persona와 Scenario에 기반하여 구축되는 복합적인 초기 환경 상태.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Online Reinforcement Learning (RL)이 수학, 코딩, Tool-Use 분야에서 큰 발전을 이루었음에도 불구하고, GUI Agent 영역에서는 Scalability와 Realistic Training Task 부족으로 인해 어려움을 겪고 있음을 지적한다. 첫 번째 주요 Challenge는 GUI 환경이 확장에 Cost가 많이 들고 일관성을 유지하기 어렵다는 점이다. 각 Agent 시도는 격리된 환경 인스턴스를 필요로 하며, 대규모 Training Run은 수천 개의 인스턴스를 동시에 운영해야 하므로 높은 비용과 복잡성을 초래한다. 또한, 평가(Evaluation)와 훈련(Training)이 다른 Agent 구현체로 진행될 경우 Agent Harness의 차이로 인해 측정된 성능에 일관성이 저하될 수 있다.
두 번째 Challenge는 Realistic한 GUI 학습을 위해서는 일관되고 초기화 가능한 환경 상태에 기반한 다양한 Task가 요구된다는 점이다. 기존 Task Synthesis 방식은 주로 단일 파일 또는 공유 Sample Data에 의존하여 생성된 Task의 다양성과 현실성이 제한적이다. 예를 들어, 여러 애플리케이션에 분산된 정보를 통합해야 하는 실제 GUI Workflow를 효과적으로 학습하기 어렵다. 더 나아가, 실제 Transaction을 포함하는 애플리케이션은 Training에 비현실적이며, Agent의 익숙하지 않은 Interface 적응성을 연구하기 위한 완전히 새로운 애플리케이션의 필요성도 존재한다. 기존 GUI Gym들은 이러한 문제의 일부만 해결하거나, Scalable한 Infrastructure와 풍부한 Task 공급을 동시에 제공하지 못하는 한계가 있었다.
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 모바일, 컴퓨터, 웹 환경 전반에 걸쳐 GUI Agent 평가, 데이터 수집, 온라인 RL Training을 통합하는 All-in-One Open Platform인 MAI-Gym을 제안한다. MAI-Gym의 핵심 설계 원칙은 Shared Rollout Path이며, 동일한 Agent Harness를 사용하여 평가, 데이터 수집, 훈련 간의 일관된 Agent Behavior를 보장한다. 이는 Agent 코드의 변경 사항이 모든 Workflow에 즉시 반영되도록 하여, Evaluation과 Training 간의 불일치 문제를 해소한다. MAI-Gym은 20,000개의 병렬 환경 인스턴스로 확장 가능하며, MobileWorld, OSWorld-Verified를 포함한 10개의 기존 Benchmark를 지원한다. 플랫폼의 아키텍처는 Rollout Worker가 EnvClient를 통해 환경 인스턴스를 확보하고 Inference Engine에 질의하여 Rollout을 수행하며, Environment Manager가 인스턴스 프로비저닝, Reset, 복구 등을 담당한다.
Scalable한 Infrastructure 외에도, MAI-Gym은 Mocked Apps(Real-World Clones 및 Novel Apps)와 실행 검증된 Task Verifier를 포함하는 Cross-App World의 자동화된 Synthesis를 가능하게 한다. Window-wise history 관리 방식을 통해 KV Cache 재사용을 극대화하여 Multi-Turn Inference의 효율성을 높였으며, 이는 Prefix-cache Hit Rate를 85.9%까지 향상시키고 Training Input Token 수를 84.7% 감소시켜 Training Update Time을 62.6% 단축하는 데 기여했다. MAI-Gym은 또한 Agent-Driven Diagnosis 기능을 통해 실패한 Trajectory를 분석하여 Agent의 약점을 보완할 수 있는 새로운 Task를 생성한다.
MAI-Gym을 사용하여 Qwen3.5-9B 모델을 기반으로 MAI-Gym-9B라는 Unified 9B Agent를 훈련시켰으며, 이는 Mobile 및 Computer Task를 Joint Online RL 방식으로 단일 Run에서 학습한다. MAI-Gym-9B는 MobileWorld에서 78.4%, OSWorld-Verified에서 76.2%의 성공률을 달성하여, 10B 미만의 오픈 GUI Agent 중 State-of-the-Art 성능을 기록했다. 이는 UI-Venus-2-9B (75.2%/70.8%) 및 SCALECUA-Qwen3.5-9B (12.8%/68.7%)와 같은 Baseline 모델을 크게 앞선다. 특히, Train-Ticketing App의 Real-World Clone에서의 RL Training은 실제 물리적 Phone의 Real App에서 Task Success Rate를 28.8%에서 48.1%로 향상시키는 Sim-to-Real Transferability를 보여주었다. Novel Apps에서의 Training 또한 Held-out Task Success를 25.8%에서 45.2%로 개선시켰다. Joint RL은 개별 Domain Expert를 Merge하는 방식보다 두 Domain 모두에서 더 나은 성능을 보였다.
## 4. Conclusion & Impact (결론 및 시사점)
본 논문은 모바일, 컴퓨터, 웹 환경 전반에 걸쳐 GUI Agent 평가 및 온라인 RL을 위한 All-in-One Open Platform인 MAI-Gym을 성공적으로 제시했다. Shared Rollout Path와 Agent Harness를 통해 평가와 훈련 간의 일관성을 확보하고, 최대 20,000개의 병렬 환경 인스턴스를 지원하는 뛰어난 Scalability를 입증했다. 이 플랫폼은 복잡한 GUI 환경의 특성을 고려한 안정적인 Reset 메커니즘과 효율적인 Multi-Turn Inference를 위한 Window-wise History 관리 방식을 도입하여 Online RL의 실현 가능성을 높였다.
MAI-Gym이 제공하는 자동화된 Mocked Apps 및 Cross-App World Synthesis 기능은 Online RL에 필요한 다양하고 검증된 Task를 안정적으로 공급하여, 기존 GUI Gym의 한계를 극복하는 데 기여한다. 훈련된 MAI-Gym-9B 모델은 MobileWorld에서 78.4%, OSWorld-Verified에서 76.2%라는 인상적인 성능을 달성하며, 10B 미만의 오픈 GUI Agent 중 State-of-the-Art를 수립했다. 특히, Real-World Clone에서의 학습이 실제 앱으로 성공적으로 Transfer되는 결과는 GUI Agent의 Generalization 및 Practical Applicability에 대한 중요한 시사점을 제공한다.
MAI-Gym은 프레임워크, Synthesis Skill, Mocked Apps, 2,000개의 검증된 Task, 그리고 모델 Checkpoint를 오픈 소스로 공개함으로써 GUI Agent 연구 분야의 Reproducible Research와 발전을 크게 촉진할 것으로 기대된다. 이는 GUI Agent의 Foundation Model 개발 및 실제 환경에서의 응용 연구에 필수적인 토대를 제공하며, 향후 더욱 정교하고 범용적인 Agent 개발을 위한 기반이 될 것이다.
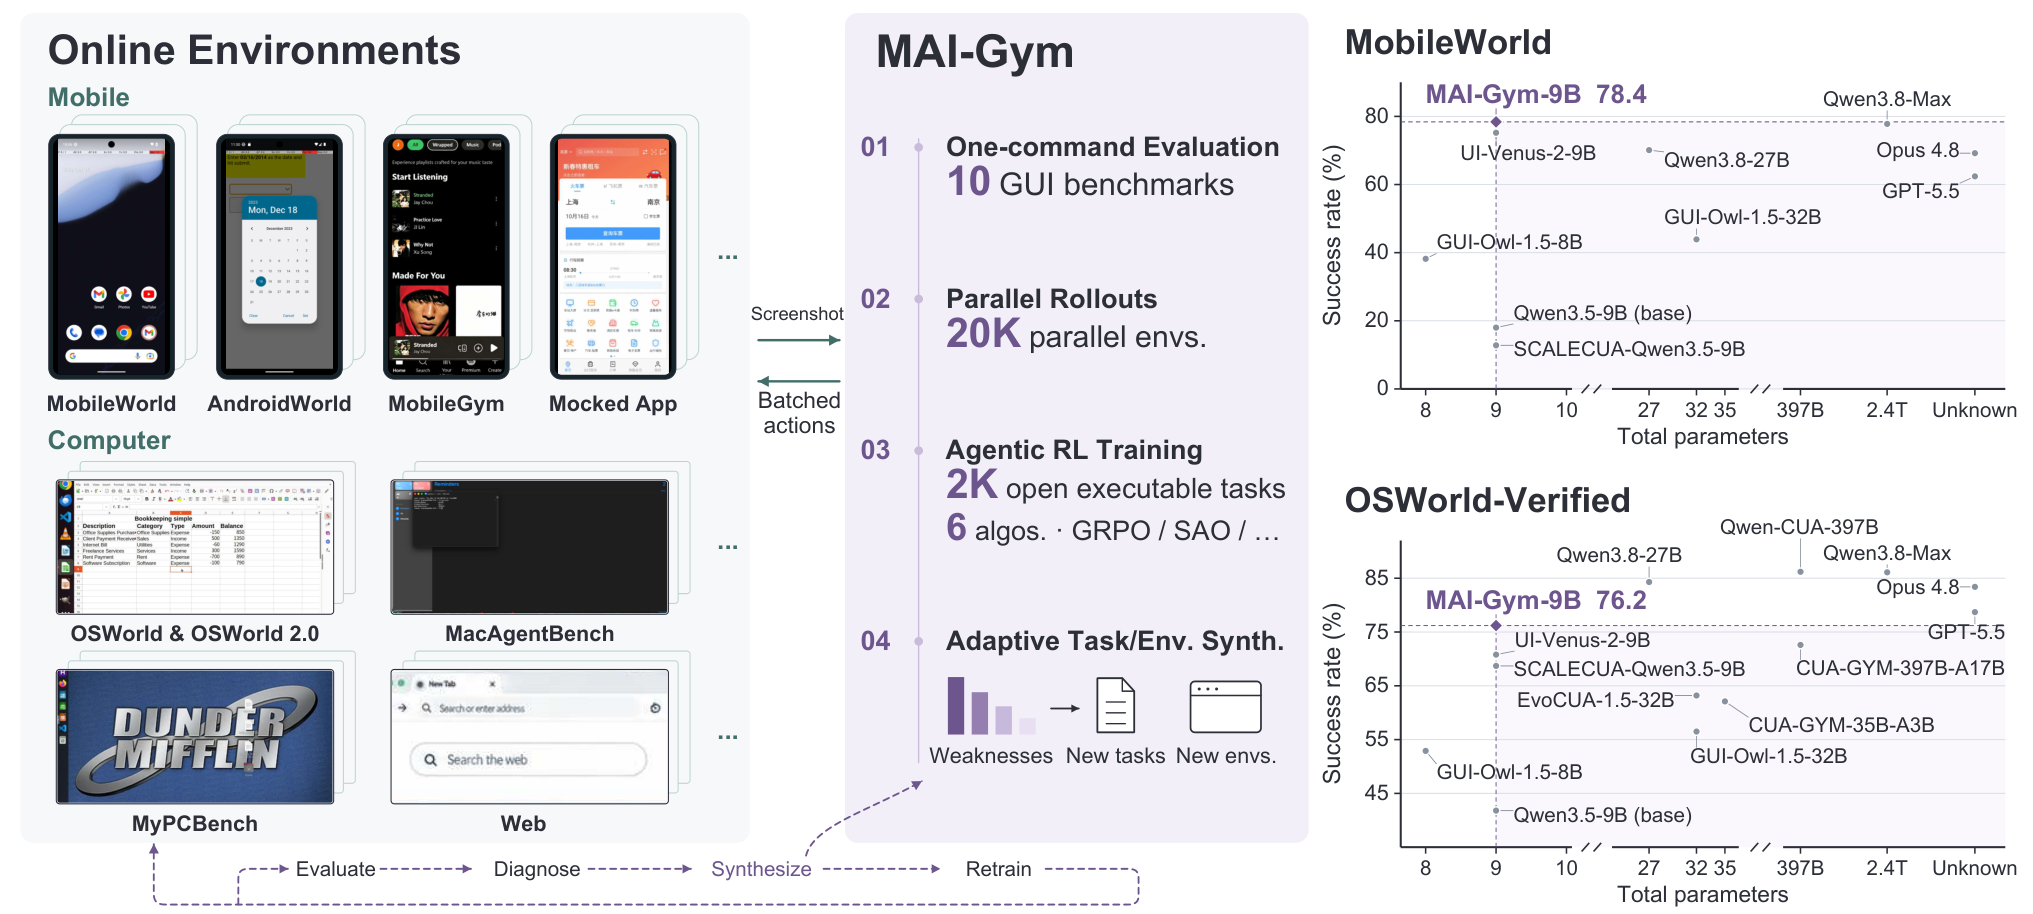
Figure 1 — MAI-Gym 전체 개요
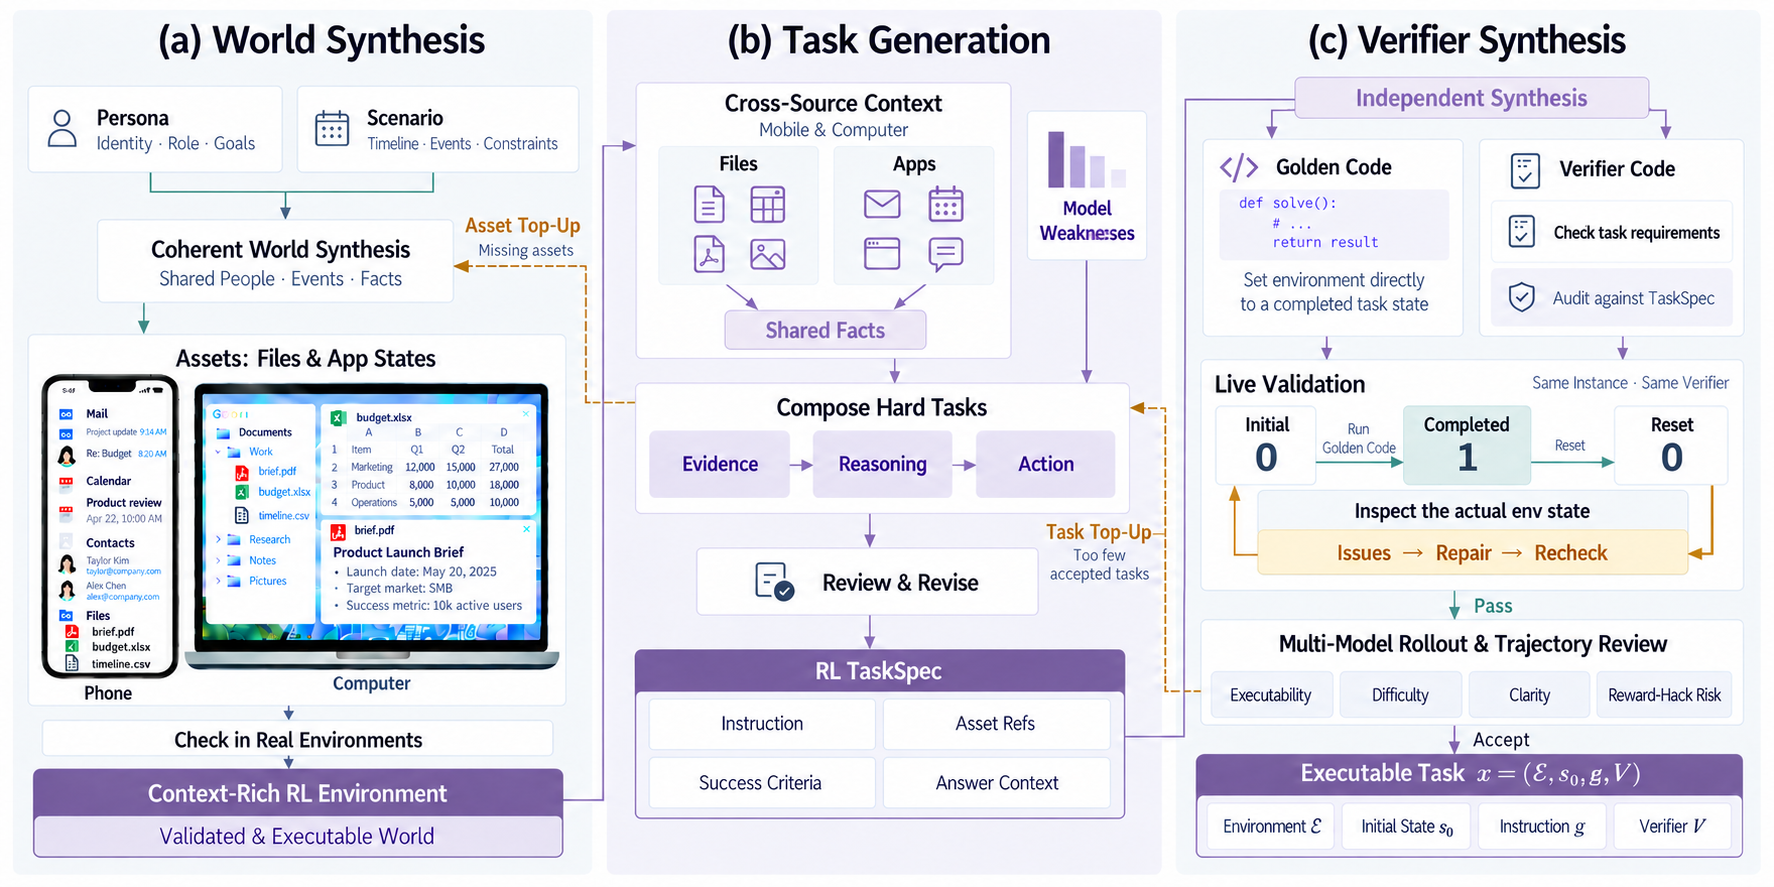
Figure 5 — 환경 및 Task Synthesis 흐름
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Computer-Using World Model
- [논문리뷰] Cowork-Gym: Synthesizing Interactive Work Environments at Scale
- [논문리뷰] GroundGUI: GUI Grounding by High-Quality Data and Distillation-to-Reinforcement Learning
- [논문리뷰] Tev: Scaling Long-Horizon Agentic Environments with Dense Progress Rewards
- [논문리뷰] Relevance Does Not Imply Applicability: Experience Activation for Personal GUI Agents
Review 의 다른글
- 이전글 [논문리뷰] Learning Where to Split: Dynamic Band Splitting for Audio Source Separation
- 현재글 : [논문리뷰] MAI-Gym: An Open All-in-One Platform for GUI Agent Evaluation and RL Training across Mobile and Computer Environments
- 다음글 [논문리뷰] MJev-Spatial: System One Spatial Intelligence via Native Attention Matching
댓글