[논문리뷰] Learning to Think and Explore in 3D World
링크: 논문 PDF로 바로 열기
저자: Yijiang Li, Bingyang Wang, Nuno Vasconcelos
키워: Vision-Language Models, 3D Reasoning, Active Exploration, Reinforcement Learning, Partial Observability, Embodied AI
1. Key Terms & Definitions
- Vision-Language Model (VLM): 텍스트와 이미지를 동시에 이해하고 처리하는 능력을 가진 모델로, 본 논문에서는 3D 공간 추론 작업에 활용됩니다.
- Partial Observability: 에이전트가 환경의 전체 상태를 직접 관찰할 수 없고, 오직 제한된 정보(예: 단일 egocentric view)만을 통해 환경을 추론해야 하는 상황을 의미합니다.
- Reinforcement Learning (RL): 에이전트가 환경과의 상호작용을 통해 행동 정책을 학습하는 기계 학습 패러다임으로, 본 연구에서는 최종 답변의 정확성에 기반한 보상을 통해 3D 탐색 정책을 최적화합니다.
- Trajectory-Supervised Fine-tuning (SFT): 모델이 3D 환경에서 기본적인 multi-step interaction 능력을 학습하도록 큐레이션된 행동 궤적(trajectories)을 사용하여 초기화하는 지도 학습 방식입니다.
- Group Relative Policy Optimization (GRPO): Policy gradient 기반의 RL 알고리즘으로, 여러 롤아웃 그룹 내에서 상대적인 보상을 사용하여 정책을 최적화하는 데 사용됩니다.
2. Motivation & Problem Statement
본 연구는 Vision-Language Models (VLMs)이 3D 공간에서 능동적으로 탐색하고 추론하는 방법을 학습할 수 있는지 탐구합니다. 기존 3D vision-language 모델 연구들은 주로 모델에 완전한 3D 표현(RGB-D scans, multi-view images, point clouds 등)을 사전에 제공하여 spatial reasoning을 수행하는 방식이었습니다. 그러나 실제 시나리오에서 VLM은 partial observability 상황에 직면하며, 단순히 현재 가용한 증거에 대한 추론을 넘어, 누락된 증거를 어떻게 능동적으로 획득할지 결정해야 하는 근본적인 문제가 존재합니다. 즉, 모델은 현재의 관찰만으로 답변에 필요한 정보를 모두 얻을 수 없는 상황에서, 어떤 시점에서 어떤 정보를 탐색해야 하는지 스스로 판단하고 행동해야 하는 한계에 직면합니다. 이러한 한계는 [Figure 1]에서 passive perception 방식과 active interaction 방식의 차이점으로 명확히 제시되며, 기존 방식으로는 VLM이 능동적인 정보 획득 전략을 학습하기 어렵습니다.
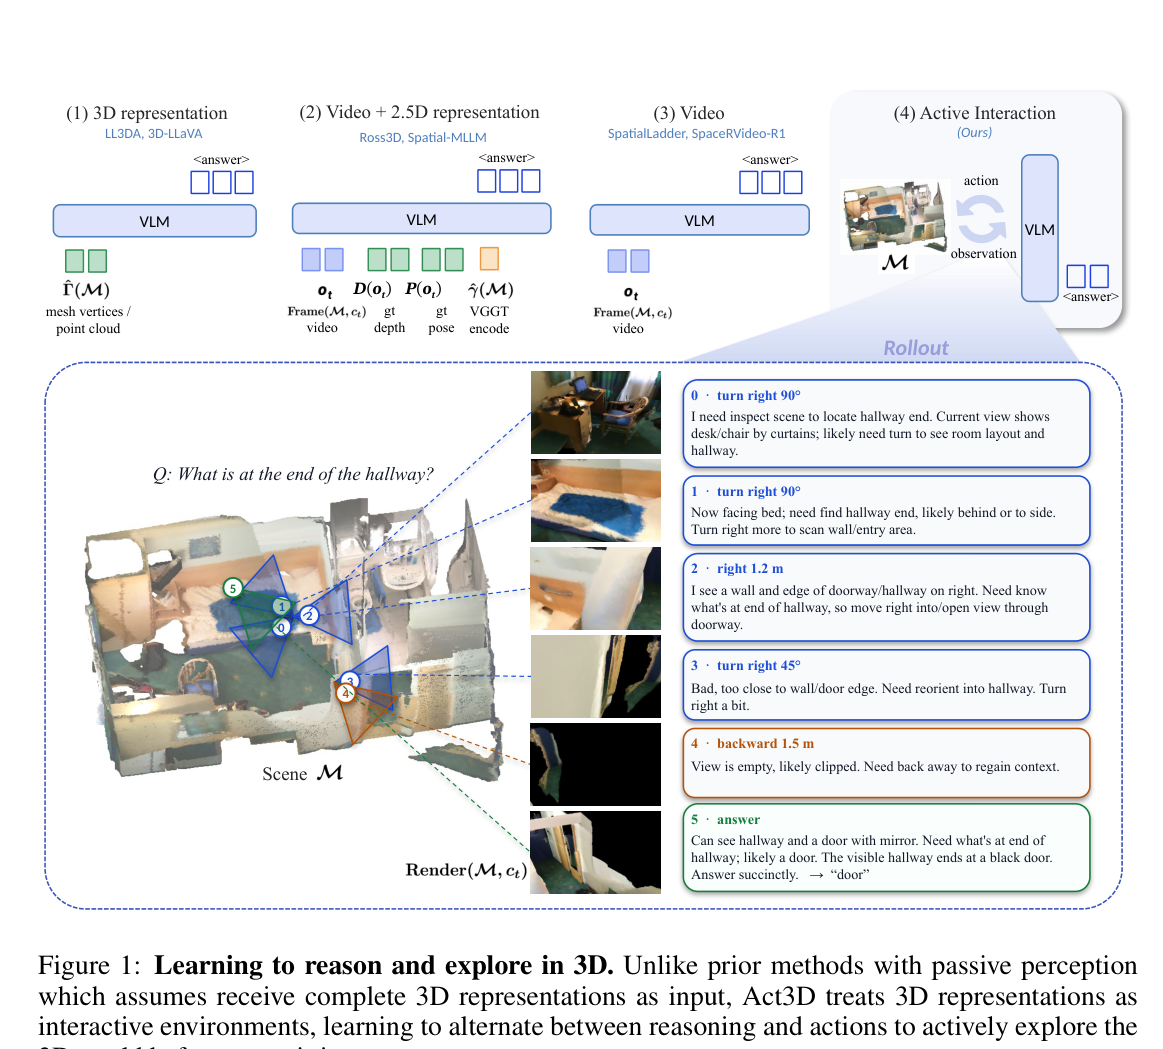
Figure 1 — 3D 환경에서 기존 passive perception 방식과 Act3D의 active interaction 방식을 비교하며 전체 프레임워크와 방법론을 시각적으로 설명하는 핵심 다이어그램.
3. Method & Key Results
본 논문은 3D reasoning을 partial observability 하의 interactive visual decision process로 공식화하고, Act3D라는 VLM 기반 모델을 제안합니다. Act3D는 3D scene을 VLM 외부의 interactive environment로 간주하며, 모델은 action (예: move left, turn right)과 observation (rendered images)을 통해 환경과 상호작용합니다. 학습은 두 단계로 이루어집니다. 첫째, trajectory-supervised fine-tuning (SFT)을 통해 기본적인 interaction protocol을 확립합니다. 둘째, reinforcement learning (RL)을 적용하여 전체 interactive policy를 최적화하며, 보상은 주로 최종 답변의 정확성(R_judge, R_EM)과 interaction reward(C(T))에 기반합니다. 특히, RL 과정에서는 중간 viewpoint나 action, exploration trajectory에 대한 직접적인 supervision 없이, 오직 task performance 개선 여부만을 통해 효과적인 exploration policy를 학습합니다. Act3D는 relative parameterization 방식의 action space를 채택하여, global reference frame 대신 camera의 local coordinate system에서 직관적인 움직임을 가능하게 합니다.
실험 결과, Act3D는 6개 3D 벤치마크(ScanQA, SQA3D, SPBench-MV, SPBench-SI, MP3D, ARKit)에서 평균 53.2%의 정확도를 달성하여, 평가된 모든 기존 방법론 및 베이스라인을 능가했습니다 [Table 1]. 이는 베이스 Qwen 모델 대비 22.0% 향상된 수치이며, Gemini 3.6 Flash보다도 1.0% 우수합니다. 특히 Act3D는 기존 open-source 3D 방법론보다 50-70% 더 적은 input frames와 낮은 해상도의 observation을 사용하면서도 더 나은 성능을 보였습니다. cross-domain generalization 측면에서도, 학습 도메인 외부의 4개 벤치마크에서 SFT 초기화 대비 평균 5.9%의 개선을 보였습니다. 또한, [Figure 5]에서 보듯이, 초기 시점에서 광범위한 exploration이 필요한 질문의 경우, Act3D의 성능 향상(SFT 대비 RL 추가 기여도)이 16.3%에 달해 adaptive하고 question-conditioned exploration 행동이 나타남을 확인했습니다. 이는 모델이 가려진 대상을 탐색하고, 불필요한 탐색을 피하며, 공간적 비교를 위해 보완적인 viewpoint를 획득하는 방법을 학습했음을 보여줍니다.
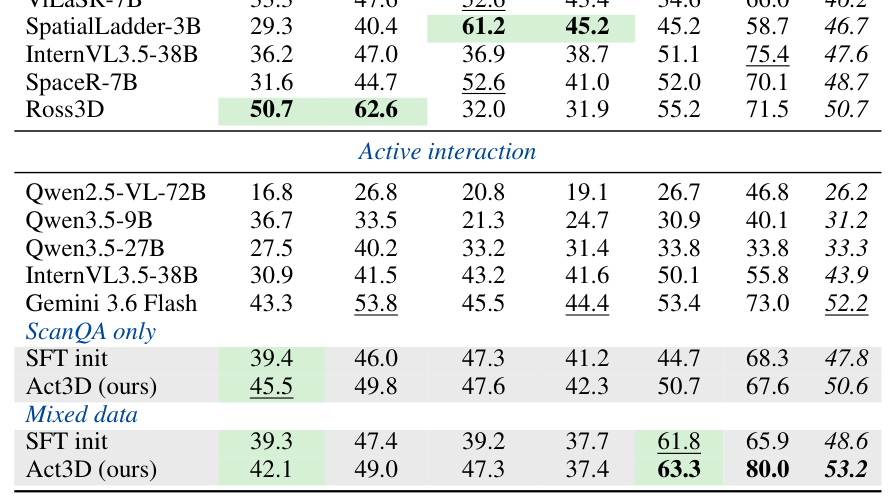
Table 1 — 제안된 Act3D 모델의 6가지 3D 벤치마크에서의 정량적 성능을 기존 active 및 passive 방법론들과 비교하여 핵심 결과를 보여주는 테이블.
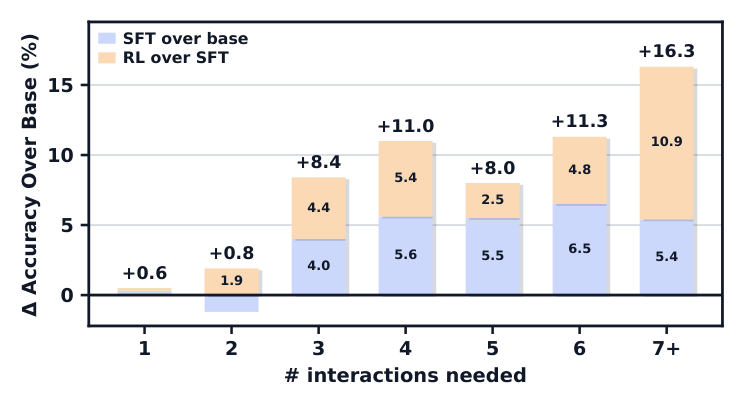
Figure 5 — 모델의 adaptive exploration behavior를 시각적으로 보여주는 그래프로, exploration 요구도가 높은 질문에서 SFT 대비 RL의 성능 향상이 두드러짐을 명확히 제시.
4. Conclusion & Impact
본 연구는 Act3D라는 framework를 통해 Vision-Language Models (VLMs)이 3D 환경에서 능동적으로 사고하고 탐색하여 시각적 증거를 획득하는 능력을 학습할 수 있음을 성공적으로 입증했습니다. 기존의 완전한 3D 입력에 의존하는 방식과 달리, Act3D는 단일 초기 관찰에서 시작하여 iterative reasoning과 action을 통해 필요한 증거를 자율적으로 수집합니다. supervised trajectory initialization과 outcome-based reinforcement learning의 결합은 exploration action이나 viewpoint에 대한 명시적 supervision 없이도 효과적인 exploration policy를 유도했습니다. 이러한 접근 방식은 VLM이 단순히 주어진 시각적 증거를 추론하는 것을 넘어, 3D reasoning에 필요한 증거를 언제, 어떻게 획득할지 학습할 수 있는 잠재력을 보여줍니다. 이는 embodied AI 및 interactive perception 분야에서 VLM의 역할과 능력을 확장하는 중요한 진전이며, 미래의 자율 에이전트 개발에 중요한 기반을 제공할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] Xiaomi-Lens-0 Technical Report
- [논문리뷰] Tree-Aware Posterior Distillation for Long-Horizon Agentic Reinforcement Learning
- [논문리뷰] Towards Looped Models Done Right, Part I: Topology, Input Injection, Recurrent-State Design
- [논문리뷰] Stuck on Shuffle: On Attribute-Object Binding in Vision-Language Models
Review 의 다른글
- 이전글 [논문리뷰] LEV: Thinking Fast and Deep with Looped Decision Models
- 현재글 : [논문리뷰] Learning to Think and Explore in 3D World
- 다음글 [논문리뷰] Lexical Reference Frames: Interpreting LM Residual Streams in Native Semantics
댓글