[논문리뷰] SpatialScout: Can VLM Agents Actively Explore and Map 3D Scenes?
링크: 논문 PDF로 바로 열기
저자: Zhaoxi Zhang, Hao Liang, Linxuan Wu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- VLM Agents: Vision-Language Model (VLM)을 기반으로 시각적 정보를 이해하고 언어적 지시에 따라 행동하는 인공지능 에이전트를 지칭합니다. 본 논문에서는 3D 환경에서 능동적으로 탐색하고 매핑하는 에이전트의 능력을 평가하는 데 중점을 둡니다.
- Active Object-level 3D Mapping: 에이전트가 3D 환경을 자율적으로 탐색하면서 시각적 증거를 수집하고, 환경 내 객체들의 3D 중심 위치를 정확하게 추정하여 일관된 맵을 구축하는 작업을 의미합니다.
- IoU (Intersection over Union): 객체 Localization 정확도를 평가하는 데 사용되는 지표입니다. 예측된 객체 바운딩 박스와 Ground-Truth 바운딩 박스 간의 Overlap 비율을 나타내며, 객체의 Scale을 고려한 정확도를 측정합니다.
- Metric Map: 3D 공간 내 객체들의 정확한 기하학적 위치와 상호 거리를 보존하는 공간 표현을 의미합니다. 이는 단순한 객체 인식이나 정성적 공간 이해를 넘어선 정량적이고 정밀한 공간 정보를 포함합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Vision-Language Model (VLM) Agents가 3D 환경을 능동적으로 탐색하고 Metric Map을 구성하는 Spatial Intelligence 역량을 정량적으로 평가하기 위한 SpatialScout 벤치마크를 제안합니다. 기존 연구(Baseline)들은 대부분 Image-based 또는 Video-based Question Answering (QA) 방식으로 공간 이해를 평가해왔으며, 이는 정답 예측에 국한되어 실제 3D 환경에서의 자율적인 증거 수집, 공간 표현 업데이트, 그리고 이를 통한 행동 유도와 같은 End-to-End 과정을 충분히 담아내지 못하는 한계가 있었습니다. 예를 들어, 제한된 정답 선택지는 모델이 추측이나 언어적 Prior에 의존하여 정답을 맞출 가능성을 열어두며, 이는 진정한 공간 이해를 반영하기 어렵습니다. 이러한 한계점들을 극복하고, 모델이 Local Observation을 정확하고 완전한 Metric Spatial Representation으로 변환할 수 있는지를 평가하기 위해, 저자들은 능동적인 상호작용을 통해 연속적인 3D 공간에서 객체 맵을 직접 구성하는 것을 평가 목표로 설정했습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 VLM Agents의 Active Object-level 3D Mapping 능력을 평가하기 위한 벤치마크인 SpatialScout를 제안합니다. 이 방법론은 에이전트가 주어진 객체 Inventory, RGB Observation, Camera Calibration 및 Pose 정보를 활용하여 카메라를 제어하고 3D Scene을 탐색하며, 공유된 Coordinate Frame 내에서 객체 중심 위치를 추정하는 방식으로 진행됩니다 [cite: 1, Figure 1, Figure 3]. 이 과정은 Viewpoint Selection, Cross-View Association, Geometric Estimation 및 Map Revision의 지속적인 조정을 요구하며, 제한된 Interaction Budget 내에서 이루어집니다. 벤치마크는 80개의 다양한 Indoor Scenes과 총 3,140개의 Target Objects로 구성되어 있습니다. 에이전트는 list_entities, get_camera_pose, set_camera_position, move_camera, rotate_camera, capture_image, triangulate_observations, submit_positions, finish_mapping과 같은 Shared Tool Interface를 사용하여 환경과 상호작용합니다.
평가는 Localization Accuracy와 Target Coverage를 공동으로 측정하며, Object-scale Overlap Score인 3D IoU를 사용하고 Missing Prediction에 대해 패널티를 부여합니다. 주요 정량적 결과는 다음과 같습니다 [cite: 1, Table 3]:
- 평가된 Frontier VLMs (GPT-6 Astra, Claude Opus 5.5 등) 중 가장 강력한 모델인 Claude Opus 5.5는 All-Target Mean IoU에서 41.71%를 달성했습니다. 이는 GPT-6 Astra의 33.16%보다 우수한 성능입니다 [cite: 1, Table 3].
- Localization Precision 측면에서, Claude Opus 5.5는 IoU 0.5 초과 Target 비율에서 47.23%, IoU 0.9 초과 Target 비율에서 3.25%를 기록했습니다 [cite: 1, Table 3]. 이는 Submit된 객체 중에서도 정밀한 Center Alignment가 여전히 어렵다는 것을 보여줍니다.
- Tool-calling Analysis 결과, Claude Opus 5.5는 가장 많은 Tool Call을 수행하며, 이는 더 많은 정보를 수집하고 통합하여 성능 향상에 기여한 것으로 분석됩니다. 반면, DeepSeek-V4.1-Flash와 Qwen3.8-Max는 카메라 이동에는 많은 시간을 할애하지만 Observation 및 Mapping에 상대적으로 적은 Tool Call을 사용하여 Informative Viewpoint 선택 및 시각적 Observation을 일관된 맵으로 변환하는 데 어려움을 겪는 것으로 나타났습니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 능동적인 객체 Level 3D 매핑을 통해 VLM Agents의 Spatial Intelligence를 평가하는 벤치마크인 SpatialScout를 도입했습니다. 실험 결과, 현재 Frontier VLMs는 Partial Scene Layout을 복구할 수 있지만, Comprehensive Coverage와 Precise Localization을 동시에 달성하는 데에는 상당한 한계가 있음을 명확히 보여줍니다. 특히, 최강 모델인 Claude Opus 5.5조차 Mean IoU 41.71%와 IoU 0.9 초과 Target 비율 3.25%에 그쳐, 시각적 Observation을 신뢰할 수 있는 Geometric Estimation으로 변환하는 과정의 어려움을 드러냈습니다 [cite: 1, Figure 4].
이 연구는 해당 분야에 다음과 같은 중요한 시사점을 제공합니다: 첫째, 기존의 QA 기반 평가 방식의 한계를 넘어선 End-to-End Active Perception 및 Spatial Representation Construction 평가의 필요성을 강조합니다. 둘째, SpatialScout는 VLM Agents가 3D 환경을 자율적으로 이해하고 재구성하는 능력을 개발하고 측정하기 위한 정량적인 Testbed를 제공합니다. 마지막으로, 이는 Active Perception, Cross-View Reasoning, 그리고 Persistent Spatial Memory와 같은 핵심 영역의 발전을 촉진하여, 궁극적으로 3D 환경에 대한 정확하고 완전한 Representation을 구축할 수 있는 Agents 개발에 기여할 것입니다.
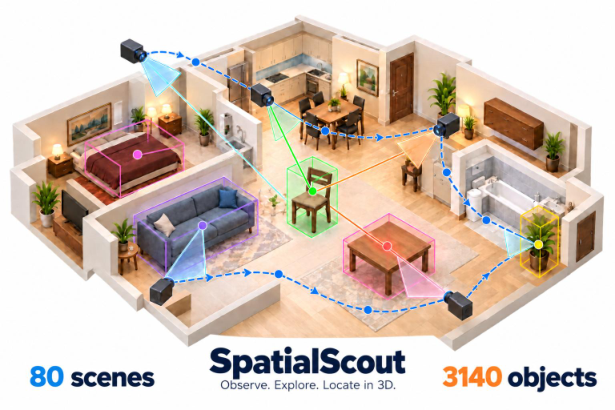
Figure 1 — SpatialScout 개요
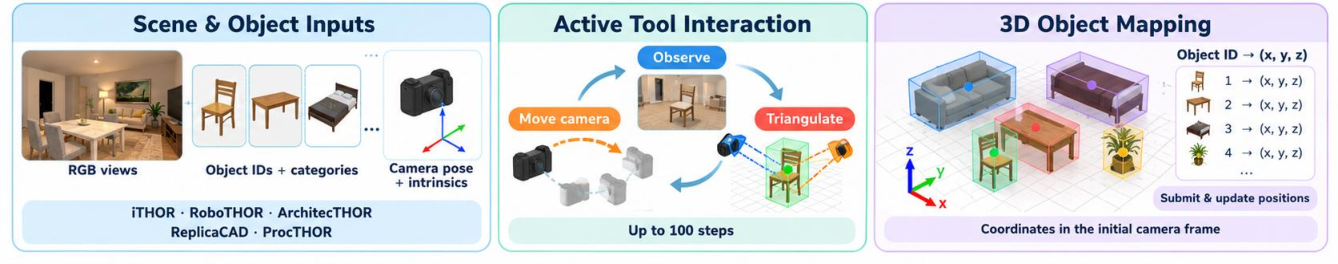
Figure 3 — VLM 에이전트 평가 과정
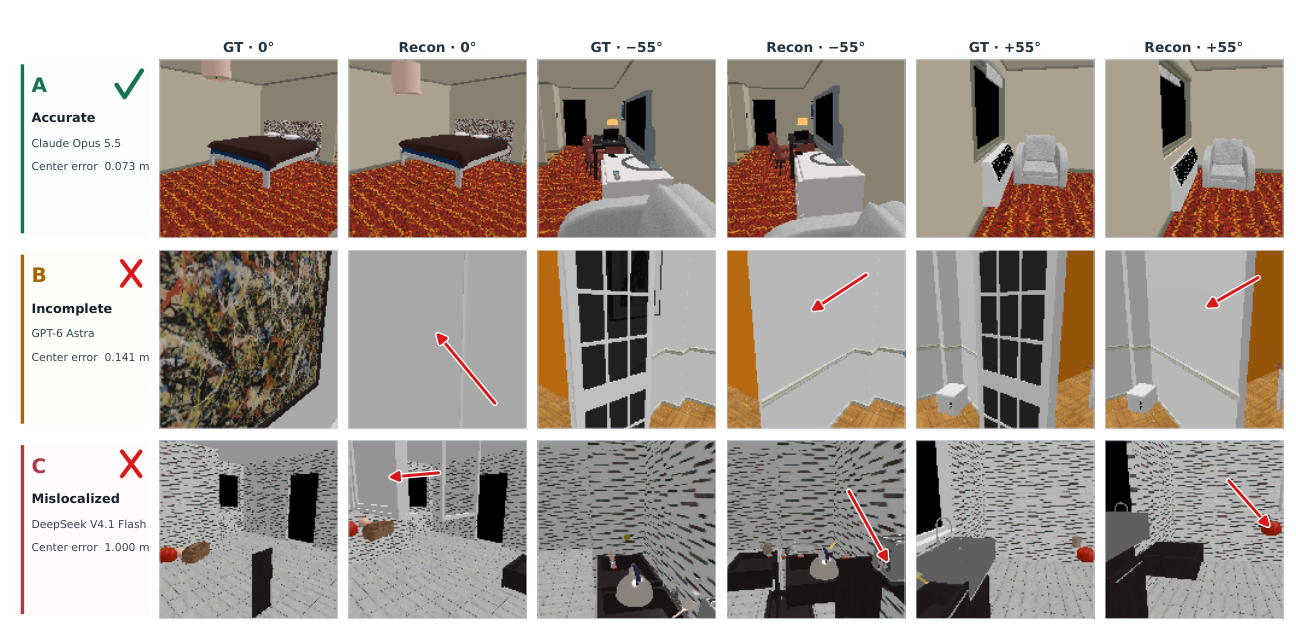
Figure 4 — 객체 맵 재구성 예시
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Where to Look: Can Foundation Models Reach a Target Viewpoint Through Active Exploration?
- [논문리뷰] WorldAuditBench: Interactive 3D World Auditing with Multimodal Agents
- [논문리뷰] VABench: Measuring Embodied Spatial Intelligence through Visual Demonstrations, Active Perception, and Metric Control
- [논문리뷰] RoboSPA: Can VLA Models Go Beyond Simple Scenes and Short-Horizon Tasks?
- [논문리뷰] Evaluating Multimodal LLMs as Generalist Vision-Language-Action Agents for Drone Control: Commanding, Approaching, Tracking and Searching
Review 의 다른글
- 이전글 [논문리뷰] SpatialBrain: Spatial Intelligence Growing from Experience
- 현재글 : [논문리뷰] SpatialScout: Can VLM Agents Actively Explore and Map 3D Scenes?
- 다음글 [논문리뷰] Spectral-Spatial Interpretation
댓글