[논문리뷰] Competing Learning in Hybrid Architectures
링크: 논문 PDF로 바로 열기
메타데이터
저자: Xingyu Shen, Yingfa Chen, Ziqing Qiao, Chaojun Xiao, Xu Han, Zhiyuan Liu
1. Key Terms & Definitions (핵심 용어 및 정의)
- Hybrid Architectures: Linear-time recurrence(예: SSM, Linear Attention)와 Softmax Attention을 결합하여 효율성과 표현력을 동시에 확보한 모델 구조.
- Competing Learning: 하이브리드 모델 학습 과정에서 특정 레이어가 retrieval 기능을 먼저 습득하면, 해당 레이어가 예측 오차를 감소시켜 다른 레이어의 학습 신호를 억제하는 현상.
- Better Layer Division (BLD): 학습 초기 단계에서 Recurrent 레이어의 가중치를 동결(Freezing)하여, Softmax Attention 레이어가 우선적으로 retrieval 기능을 학습하도록 유도하는 최적화 기법.
- Spaced Retrieval: 모델의 긴 문맥(long-context) 상에서 특정 정보를 정확히 인출(Retrieval)하는 능력을 평가하기 위해 고안된 합성 데이터 태스크.
- Kimi Delta Attention (KDA): 다양한 최신 LLM에서 사용하는 대표적인 RNN 기반의 선형 recurrence 구조.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 하이브리드 LLM 아키텍처에서 발생하는 최적화 불균형 문제를 해결하는 것을 목적으로 한다. 기존 연구들은 하이브리드 모델에서 Attention은 장거리 retrieval을, Recurrent 레이어는 단거리 믹싱을 담당하는 이상적인 '분업(Labor Division)'이 필요함을 시사했다. 그러나 저자들은 실제 pretraining 과정에서 Recurrent 레이어가 단거리 패턴에 대한 강력한 귀납적 편향(Inductive Bias)으로 인해 더 빠르게 retrieval 기능을 습득함을 발견했다. 이러한 현상은 Attention 레이어가 가져야 할 retrieval 기능까지 Recurrent 레이어가 조기에 점유하게 만들어 모델 전체의 성능을 저하시키는 결과를 초래한다 [Figure 1].
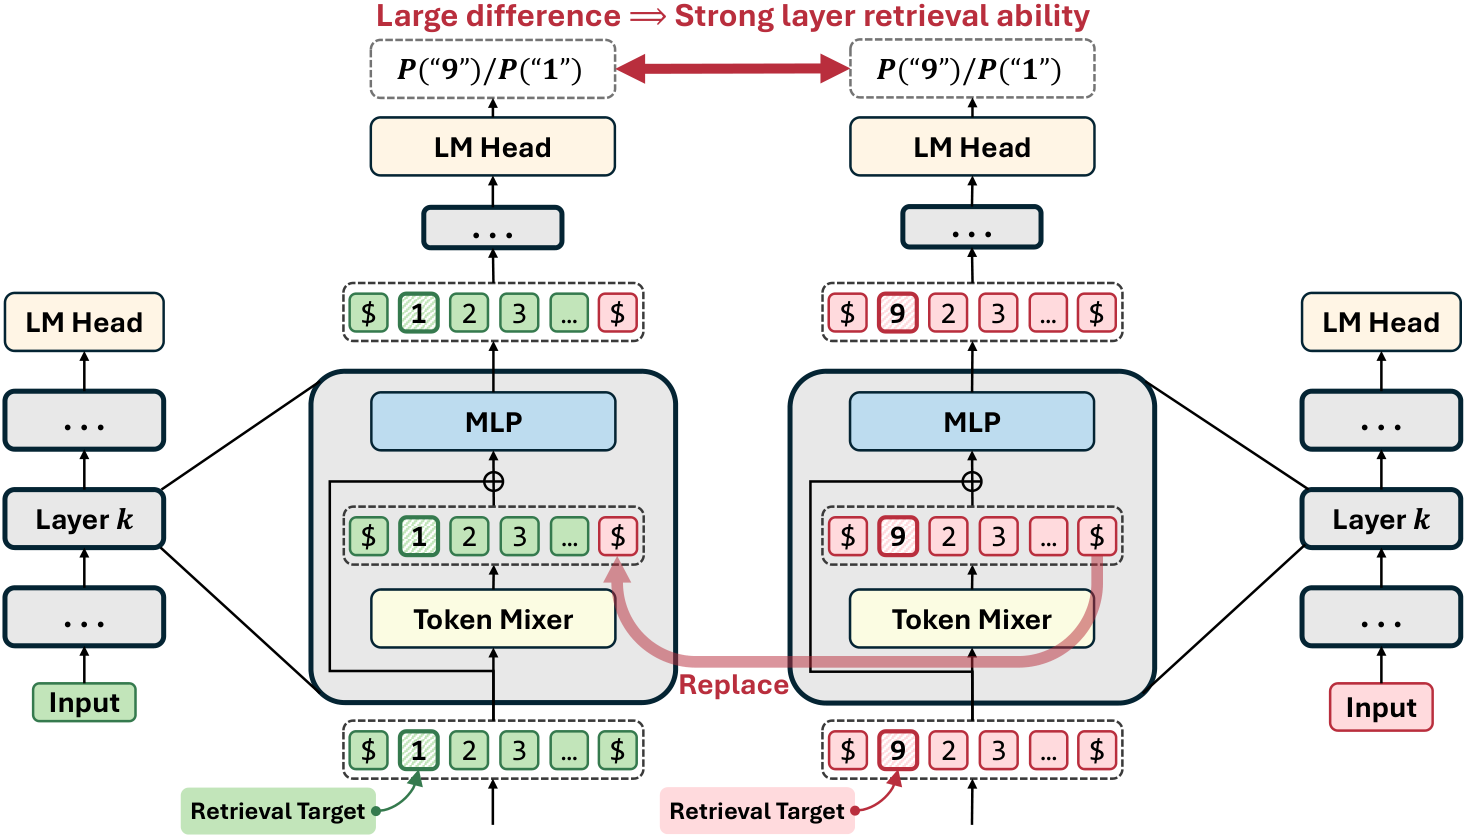
Figure 1 — 레이어별 retrieval 능력 평가 방법
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 하이브리드 모델 내에서 특정 레이어가 retrieval을 먼저 학습하면 타 레이어의 학습 신호를 차단하는 Competing Learning 현상을 체계적으로 입증했다. 이를 해결하기 위해 저자들은 BLD(Better Layer Division) 파이프라인을 제안하여, 학습 초기에 Recurrent 레이어를 강제로 동결함으로써 Attention 레이어가 retrieval 기능을 우선적으로 확보할 수 있는 '선점 효과(First-mover advantage)'를 제공한다. 180M에서 1B 파라미터 규모의 모델 실험 결과, BLD 기법을 적용한 모델은 vanilla 모델 대비 Language Modeling Loss를 일관되게 개선했다. 특히, Recall-intensive tasks와 RULER 벤치마크에서 큰 폭의 성능 향상을 보였으며, 이는 GDN이나 GLA와 같은 다른 Recurrent 아키텍처에도 동일하게 적용 가능함을 확인했다 [Table 1], [Table 2].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 하이브리드 LLM 학습 시 레이어 간 경쟁적 학습 메커니즘을 밝혀내고, 이를 제어하여 최적의 분업을 달성하는 BLD 전략을 정립했다. 이 방법론은 모델의 아키텍처를 변경하지 않고도 학습 과정의 조정만으로 긴 문맥 처리 능력과 추론 성능을 크게 향상시킬 수 있음을 입증했다. 향후 LLM pretraining 분야에서 하이브리드 아키텍처의 설계와 효율적인 학습 전략 수립에 중요한 이정표가 될 것으로 기대된다.
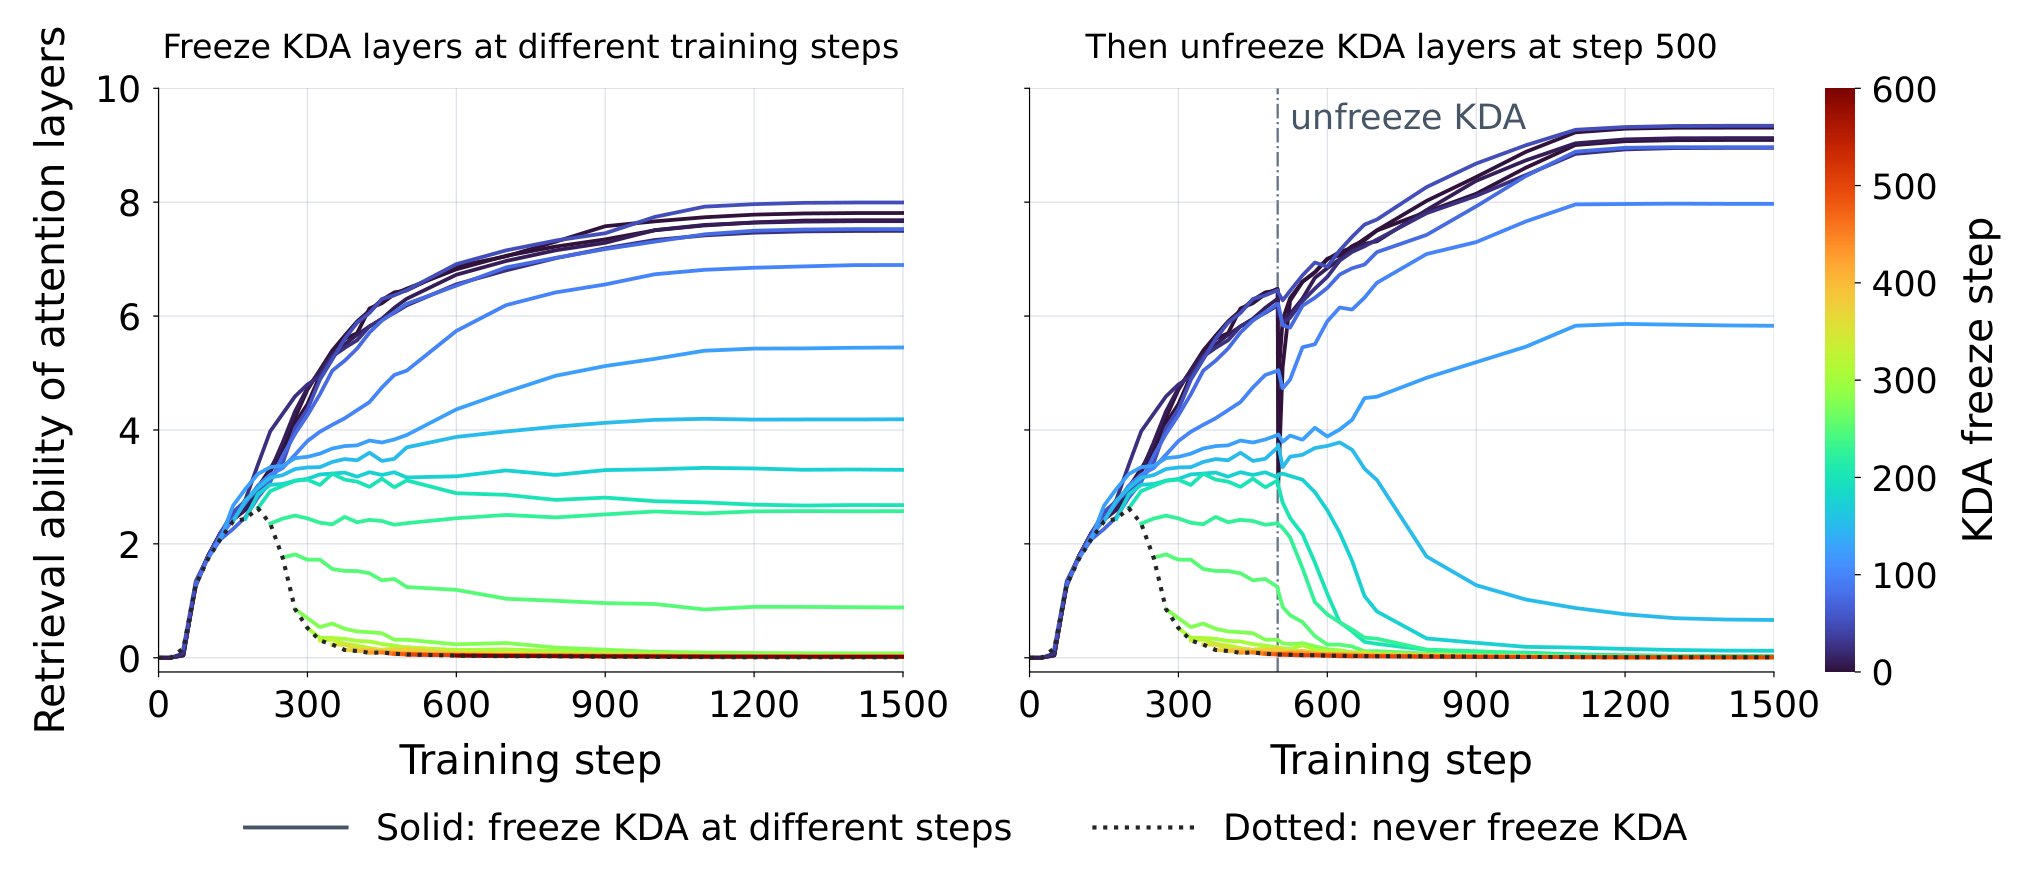
Figure 4 — Competing Learning 현상 시각화
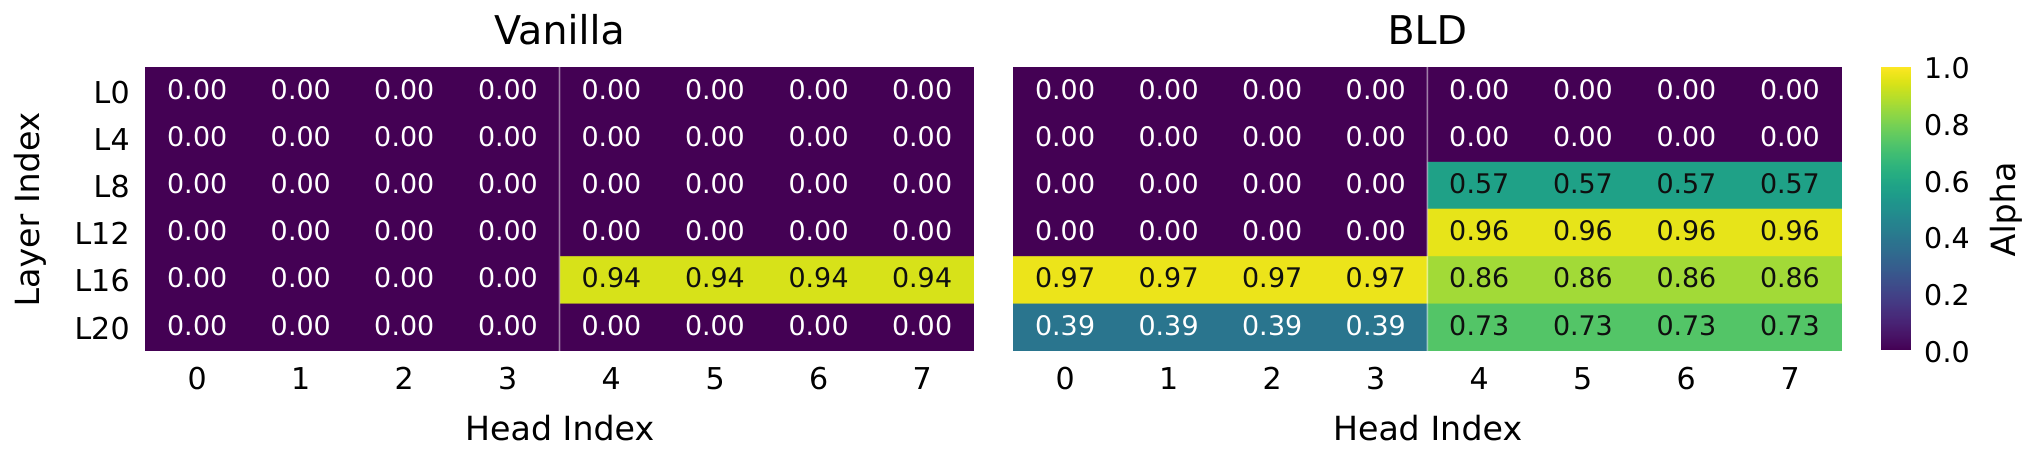
Figure 5 — Attention 레이어의 기울기 변화
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] V-CoLA: Vision Token Compression with Linear Attention
- [논문리뷰] Scaling Domain Data Repetition in LLM Pretraining
- [논문리뷰] OmniOpt: Taxonomy, Geometry, and Benchmarking of Modern Optimizers
- [논문리뷰] Rethinking Shrinkage Bias in LLM FP4 Pretraining: Geometric Origin, Systemic Impact, and UFP4 Recipe
- [논문리뷰] Agentic Discovery of Neural Architectures: AIRA-Compose and AIRA-Design
Review 의 다른글
- 이전글 [논문리뷰] Co-Evolving Acting and Forecasting for Language Agents
- 현재글 : [논문리뷰] Competing Learning in Hybrid Architectures
- 다음글 [논문리뷰] CoworkEnv: Synthesizing Training Environments for Long-Horizon Cowork Agents
댓글