[논문리뷰] OR-License: Evaluating LLM Agents as Real-World Operations Research Practitioners
링크: 논문 PDF로 바로 열기
저자: Peisong Wang, Feixue Liu, Yize Meng, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- OR-License: 실제 산업 현장에서의 OR 프로젝트를 기반으로 한 end-to-end LLM 에이전트 평가 벤치마크.
- ORSim: 에이전트가 문제 해결 과정에서 필요한 비즈니스 정보를 요청할 수 있도록 설계된 통제된 클라이언트 시뮬레이터.
- DAQ (Deployment-Adjusted Quality): 에이전트의 솔루션이 기술적 feasibility를 충족하는지 여부를 검증하고, 그 이후에 전문적인 솔루션 품질을 expert와 비교하여 산출한 종합 지표.
- Strict Feasibility: 제안된 솔루션이 모든 현장 제약 조건을 완벽하게 준수하는지를 검증하는 평가 방식.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM 에이전트가 실제 산업 현장의 불완전한 비즈니스 요구사항을 해석하여 전문가 수준의 OR 솔루션을 도출할 수 있는지에 대한 의문을 해결하고자 한다. 기존 벤치마크들은 문제 정의가 완결된 상태에서 시작하거나 학술적인 합성 데이터에 의존하여, 실제 현장에서의 요구사항 정의, 정보 수집, 솔루션 검증이라는 전체 워크플로우를 충분히 반영하지 못하는 한계가 있다 [Figure 1]. 이러한 Gap 1(복잡성), Gap 2(정보 획득), Gap 3(현장 접목)을 해결하기 위해 저자들은 산업 현장의 실제 프로젝트 데이터를 바탕으로 한 새로운 평가 체계를 제안한다.
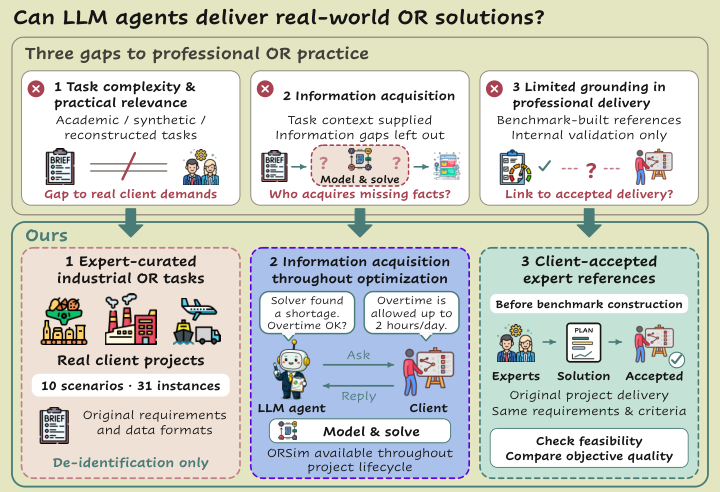
Figure 1 — 기존 연구의 한계와 개선점
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 31개의 실제 산업 OR 프로젝트를 기반으로 설계되었으며, 에이전트가 formulation, solving, refinement 단계에서 필요한 비즈니스 정보를 질의할 수 있는 ORSim을 통합한 평가 프레임워크를 제안한다 [Figure 2]. 주요 성능 평가 지표로서 Feasibility와 전문가 솔루션 대비 품질을 결합한 DAQ를 도입하여 에이전트의 실질적인 산업 기여도를 측정하였다. 실험 결과, 평가된 11개의 frontier LLM 중 일부 모델은 특정 조건 하에서 전문가의 품질을 능가하는 성과를 보였으나, 전체적인 DAQ 측면에서는 아직 전문가 수준(1.0)에 도달하지 못했다. 가장 우수한 성능을 보인 Claude Code 기반의 Grok 4.6 모델은 88.39%의 Strict Feasibility를 달성하였으며, 0.87의 DAQ를 기록하며 가장 높은 신뢰성을 보였다 [Table 1].
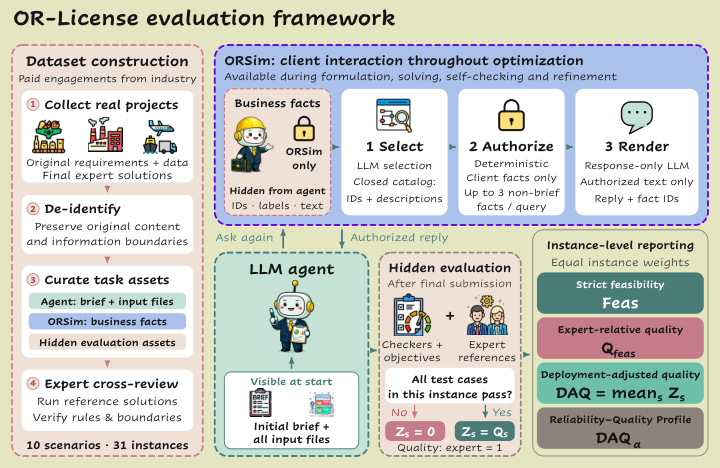
Figure 2 — OR-License 평가 프레임워크
4. Conclusion & Impact (결론 및 시사점)
본 논문은 LLM 에이전트가 단순한 코딩 과제를 넘어 실제 복잡한 OR 프로젝트의 수행자로 진화할 수 있는 가능성과 한계를 실증적으로 제시하였다. 특히 에이전트의 성능이 정보 부족을 해결하는 능동적인 Inquiry 과정과 직결됨을 확인하였으며, 이는 향후 장기적인 horizon을 가진 에이전트 개발에 있어 중요한 연구 방향성을 제공한다. 이번 연구는 학계와 산업계가 LLM 기반의 의사결정 시스템을 실제 현장에 안전하게 배치하기 위해 필수적으로 갖춰야 할 정교한 평가 및 검증 기준을 정립하는 데 크게 기여할 것으로 기대된다.
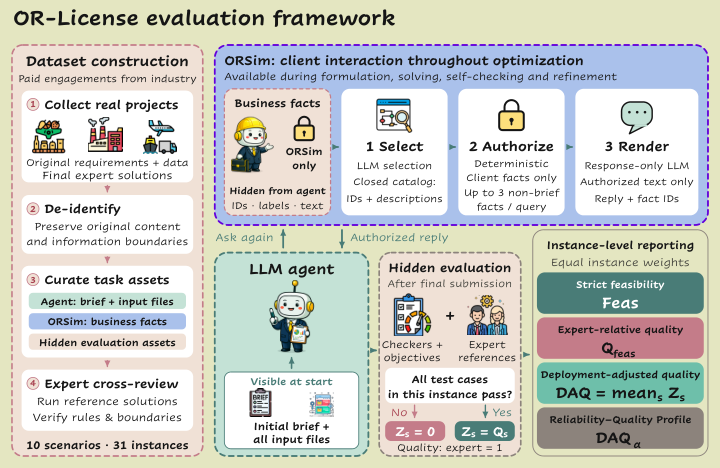
Figure 3 — 데이터셋 개요 및 통계
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Learn2Play Bench: How Well Do LLM Agents Learn from Experience in Unfamiliar Environments?
- [논문리뷰] A Closer Look at Agentic BBO: Benchmarking LLM Agents for Black-Box Optimization
- [논문리뷰] DecepEval: A Benchmark for Evaluating Deception in LLM Agents
- [논문리뷰] LMBuild: Evaluating LLM Agents for Generating Buildable and Functional Structures
- [논문리뷰] SchemeArena: Factorized Stress Testing of Scheming in LLM Agents
Review 의 다른글
- 이전글 [논문리뷰] N-Gram Memories at Two Bits: Quantizing Lookup Tables in Large Language Models
- 현재글 : [논문리뷰] OR-License: Evaluating LLM Agents as Real-World Operations Research Practitioners
- 다음글 [논문리뷰] OpenVLHarness: Real World Visual Agentic Tool-Use with Multimodal Memory
댓글