[논문리뷰] JockeyBench: Evaluating LLM Agents on Horse-Racing Decision-Making
링크: 논문 PDF로 바로 열기
메타데이터
저자: Zhongwei Xie, Xingsu Li, Jingqiao Yu, Zihao Wang, Hong ChiTat, Zhaowei Wang, Weizhi Du, Yuxuan Liu, Huihao Jing, Jiaxin Bai, Yangqiu Song
1. Key Terms & Definitions (핵심 용어 및 정의)
- JockeyBench: 과거 일본 경마 데이터를 기반으로 LLM 에이전트의 반복적인 이벤트 예측 및 의사결정 능력을 평가하기 위해 제안된 벤치마크 프로토콜입니다.
- Program (Workflow): LLM이 예측 로직을 코드로 작성하고, 결과를 관찰하며 이를 반복적으로 수정(Revision)하는 형태의 워크플로우입니다.
- Adaptive Acquisition (Workflow): 예측 모델을 직접 생성하는 대신, 매 경주마다 필요한 정보를 적응적으로 획득(Acquisition)한 후 LLM이 즉석에서 예측을 수행하는 방식입니다.
- Capped-Kelly (Settlement): 제시된 예측 확률과 실제 배당률(Odds)을 바탕으로 자본 성장을 최적화하되, 과도한 리스크를 방지하기 위해 배팅 비율을 제한하는 Retrospective 평가 지표입니다.
- Log Gain: 예측 모델이 제안한 확률 분포가 실제 결과 대비 얼마나 정보를 제공하는지를 나타내는 지표로, uniform 분포 대비 nats 단위로 측정됩니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM 에이전트가 노이즈가 많은 데이터에서 예측 신호를 추출하고, 이를 바탕으로 성공적인 의사결정을 내릴 수 있는지 평가하고자 합니다. 기존 연구들은 단순 예측 정확도에만 집중하거나 특정 도메인에 국한되어, 실제 금융 환경에서 요구되는 '예측-의사결정-비용' 간의 복합적인 상관관계를 충분히 반영하지 못했습니다. 저자들은 예측 품질, 정보 획득 비용, 그리고 실제 배팅에 따른 리스크가 서로 다른 결과를 초래할 수 있다는 점에 주목하며, 이를 정량적으로 측정할 수 있는 통합된 환경이 필요함을 강조합니다 [Figure 1].
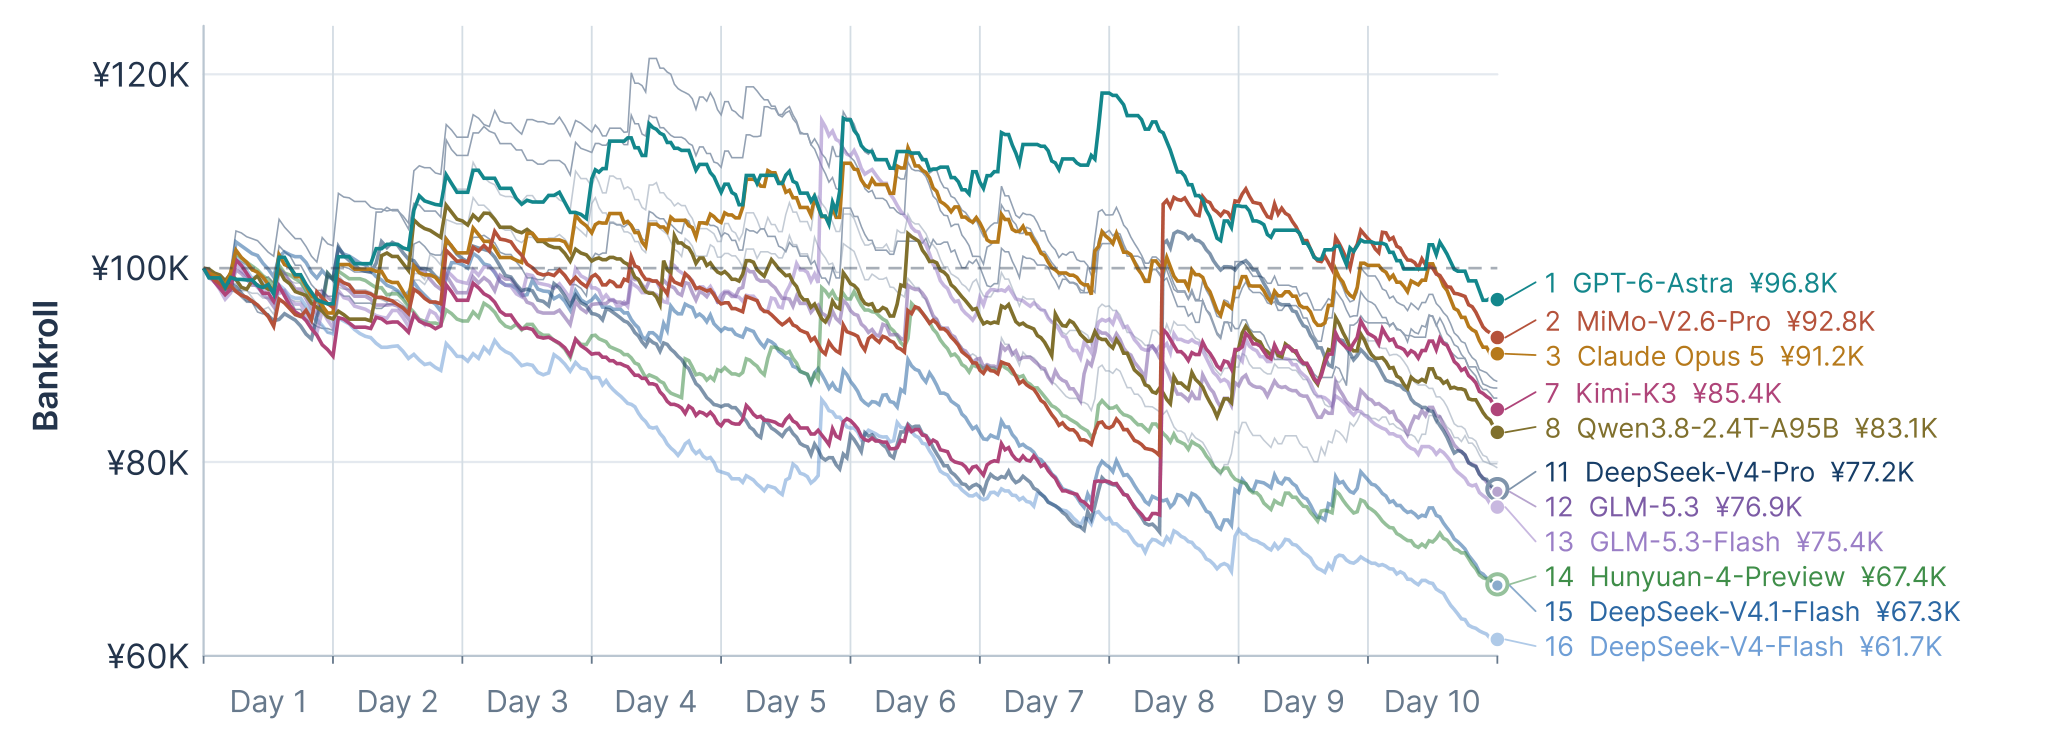
Figure 1 — Retrospective 배팅 수익률 분포
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 LLM 에이전트가 고정된 프로그램의 업데이트를 반복하는 Program 워크플로우와 매 이벤트마다 필요한 데이터를 능동적으로 수집하는 Adaptive Acquisition 워크플로우를 비교하는 프로토콜을 제안합니다. 실험 결과, 28개의 모델-스캐폴드 구성 중 통계적 보정을 거친 후에도 Program 방식에서 유의미한 Revision gain이 다수 관찰되었습니다. 정량적 성능 지표인 Log Gain과 Top-1 Win Rate 측면에서 에이전트들은 지속적인 개선을 보였으나, Capped-Kelly settlement를 적용했을 때 모든 구성에서 최종적으로는 음(-)의 평균 수익률을 기록했습니다. 특히 Program 워크플로우가 Adaptive Acquisition 대비 더 높은 평균 배팅 수익과 낮은 연구 비용(Research fees)을 달성함을 확인했습니다. 이는 모델의 예측 능력이 반드시 배팅의 상업적 성공을 보장하지 않으며, 연구 비용이 이익을 상쇄할 수 있음을 입증합니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 예측의 정확도, 적응적 정보 습득, 자원 활용 효율성, 그리고 의사결정 가치를 분리하여 평가하는 것이 반복적 이벤트 예측 에이전트 평가의 핵심임을 명시합니다. 에이전트가 높은 예측 품질을 확보하더라도 그것이 실제 경제적 가치로 직결되지 않을 수 있다는 점은 향후 LLM 기반 금융 에이전트 설계에 있어 비용 구조와 리스크 관리가 최우선 과제임을 시사합니다. JockeyBench는 앞으로 에이전트의 전략적 판단과 자원 사용의 최적화를 측정하는 중요한 벤치마크로 활용될 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research
- [논문리뷰] OR-License: Evaluating LLM Agents as Real-World Operations Research Practitioners
- [논문리뷰] Learn2Play Bench: How Well Do LLM Agents Learn from Experience in Unfamiliar Environments?
- [논문리뷰] A Closer Look at Agentic BBO: Benchmarking LLM Agents for Black-Box Optimization
- [논문리뷰] DecepEval: A Benchmark for Evaluating Deception in LLM Agents
Review 의 다른글
- 이전글 [논문리뷰] HoloBoxing: A Simple Recipe for Humanoid Boxing with 7 Minutes of Single-GPU Training
- 현재글 : [논문리뷰] JockeyBench: Evaluating LLM Agents on Horse-Racing Decision-Making
- 다음글 [논문리뷰] LoCA: Enabling Multi-Modality in Geospatial Location Encoders
댓글