[논문리뷰] RoboValue: A Fine-Grained Sim-and-Real Benchmark for Unified Evaluation of Robotic Value Models
링크: 논문 PDF로 바로 열기
저자: Shengbang Liu, Zhengye Du, Zhilong Wan, Honghao Su, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Value Models: 로봇의 시각적 관측과 명령을 바탕으로 작업의 진척도나 성공 가능성을 예측하여 정책 학습 및 모니터링에 feedback을 제공하는 모델입니다.
- Task-State Understanding (SA/TGA/SIA): 로봇의 현재 상태가 목표 달성에 부합하는지, 명령(Instruction)을 올바르게 이해했는지, 현재 수행 중인 subtask가 무엇인지 판단하는 능력입니다.
- Failure and Recovery Reasoning (FPL/TRR): 작업 중 오류(Failure)를 발생 시점에 정확히 국소화(Localization)하고, 이후 회복(Recovery) 시도가 성공적인지 혹은 실패했는지 구분하는 능력입니다.
- Value Consistency (VS/CSVC): 작업 진행 중 예측값이 안정적으로 유지되거나 정보를 제공하며, 작업 순서가 달라도 동일한 subtask에 대해 일관된 점수를 부여하는 능력입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
RoboValue는 기존의 로봇 가치 평가 지표들이 전체적인 결과(Outcome)나 전반적인 진척도(Forward-progress)의 상관관계에만 집중하여, 중간 과정에서의 미묘한 오류를 포착하지 못한다는 문제 의식에서 출발했습니다. 현재의 평가 방식은 모델이 잘못된 이유로 높은 점수를 받는 'shortcut' 현상을 걸러내지 못하며, 명령에 대한 세밀한 이해 부족이나 회복 능력 결여를 제대로 진단하지 못합니다. 따라서 본 연구는 이러한 평가의 공백을 메우기 위해 task-state, temporal progress, failure, consistency 등 4가지 차원을 다각도로 평가할 수 있는 통합된 벤치마크를 제안합니다. 이는 [Figure 1]에 제시된 바와 같이, 기존 평가가 놓치는 부분들을 포착하여 신뢰할 수 있는 가치 모델을 개발하는 데 기여하고자 합니다.
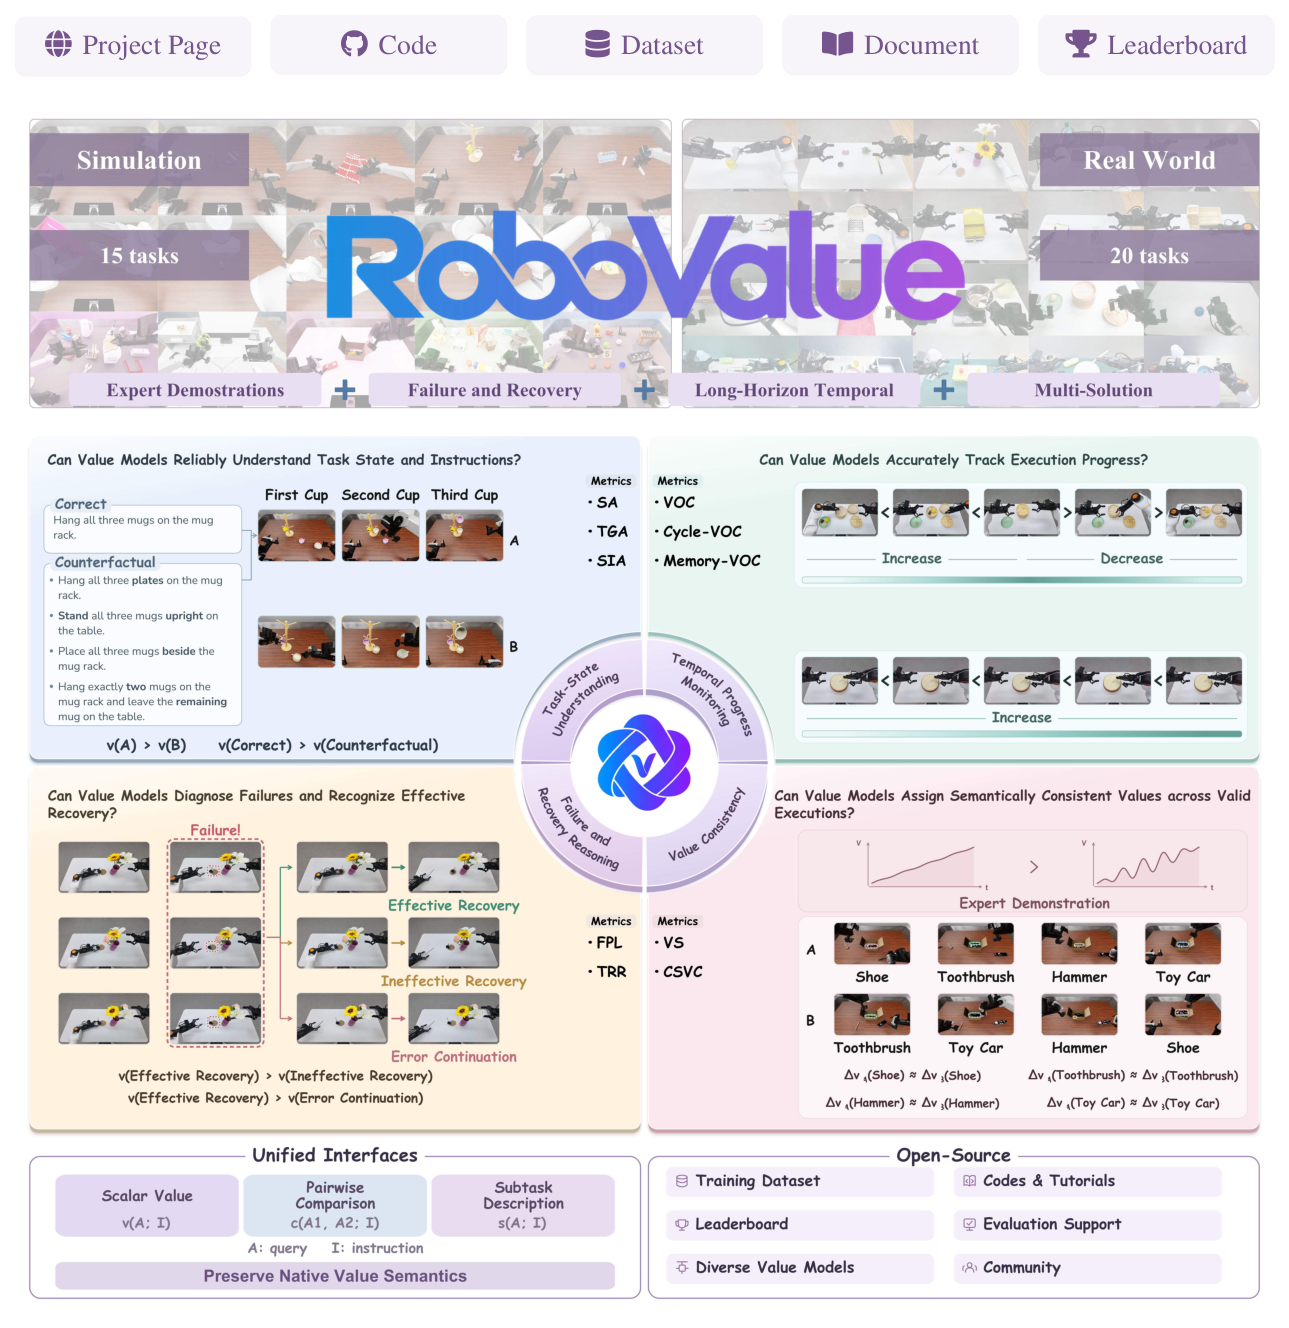
Figure 1 — RoboValue의 핵심 구성 요소와 평가 차원(task-state, progress, failure, consistency)을 도식화한 프레임워크 다이어그램
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 15개의 simulation 작업과 20개의 real-world 작업을 포함하는 RoboValue-Dataset을 구축하고, 4개의 능력 차원을 측정하기 위한 RoboValue-Benchmark 프레임워크를 설계하였습니다. 주요 실험 결과로 RoboMeter-4B가 zero-shot 평가에서 60.05의 종합 점수로 1위를 차지했으며, Robo-Dopamine 2.0-8B Preview가 one-shot 평가에서 58.33으로 우수한 성적을 기록했음을 확인하였습니다 [Table 2]. 연구 결과, 고성능 모델이라 하더라도 counterfactual 명령에 대한 세밀한 grounded understanding이 부족하거나, visually similar한 상태가 반복될 때 과거의 작업을 기억하지 못하는 한계가 드러났습니다. 또한, [Table 3]의 지표 분석을 통해 forward-progress 지표가 높더라도 Cycle-VOC가 낮은 모델은 시간적 역방향 추적에 취약함을 정량적으로 입증하였으며, 대부분의 모델이 여전히 failure localization 및 recovery reasoning에 어려움을 겪고 있음을 관찰하였습니다.
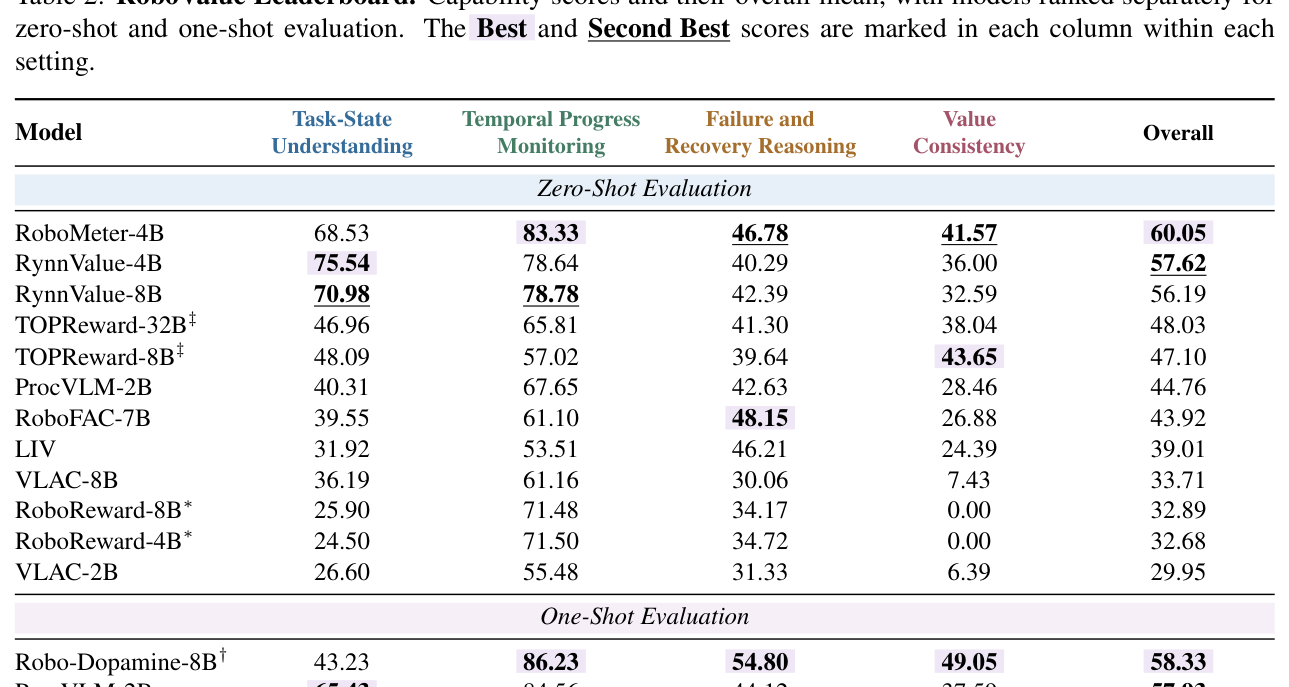
Table 2 — 다양한 모델의 Capability별 점수와 종합 성능을 나타내는 핵심 결과 테이블
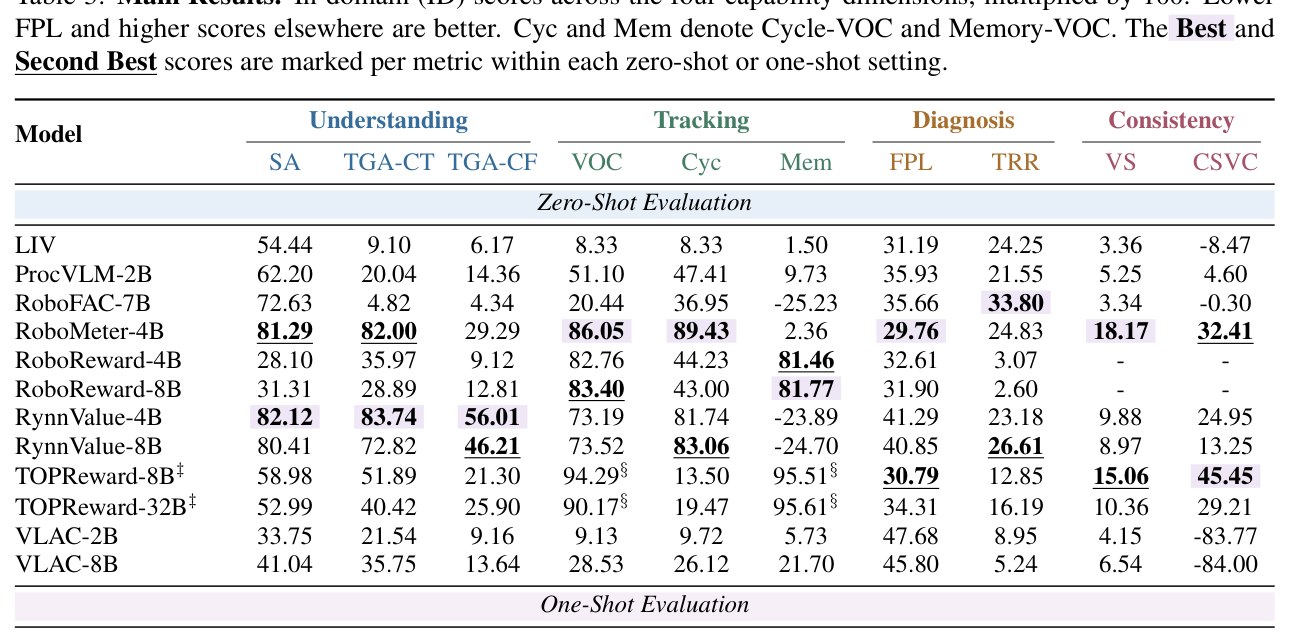
Table 3 — In-domain 데이터셋에 대한 모델들의 Fine-grained 능력 지표별 정량적 결과
## 4. Conclusion & Impact (결론 및 시사점) RoboValue는 robotic value model의 평가를 단순히 결과 중심에서 미세한 과정 중심의 진단으로 전환할 것을 제안합니다. 본 연구에서 분석된 4가지 핵심 차원은 향후 보다 안전하고 신뢰할 수 있는 로봇 정책 학습을 위한 supervision의 지향점을 제시하며, 공개된 leaderboard를 통해 관련 학계와 산업계의 지속적인 feedback 향상을 지원합니다. 이는 결과 점수만으로 알 수 없는 모델의 고질적인 결함을 해결하여, 궁극적으로 실세계 로봇의 신뢰성 향상과 하위 정책의 견고한 최적화를 가속화할 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RoboDojo: A Unified Sim-and-Real Benchmark for Comprehensive Evaluation of Generalist Robot Manipulation Policies
- [논문리뷰] Dream.exe: Can Video Generation Models Dream Executable Robot Manipulation?
- [논문리뷰] OR-License: Evaluating LLM Agents as Real-World Operations Research Practitioners
- [논문리뷰] HandsOn: A Large-Scale Simulation Benchmark for Generalizable Dexterous Manipulation
- [논문리뷰] BlenderWorld: Benchmarking Visual Agents for 3D Creation from Real-World References
Review 의 다른글
- 이전글 [논문리뷰] RoAR-VAE: Improving Latent Diffusability through Robust Prediction
- 현재글 : [논문리뷰] RoboValue: A Fine-Grained Sim-and-Real Benchmark for Unified Evaluation of Robotic Value Models
- 다음글 [논문리뷰] ScaleNav: Scalable Internet Video Pretraining for Language-Conditioned Local Navigation
댓글