[논문리뷰] Self-Evolving Coding Agents via Harness-Policy Optimization
링크: 논문 PDF로 바로 열기
저자: Zhepei Wei, Wenlin Yao, Baolin Peng, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- LLM Agent: Policy Model과 Harness로 구성되어 환경과 상호작용하며 복잡한 태스크를 수행하는 시스템입니다.
- Policy Model: 에이전트의 근본적인 추론 및 행동 결정 능력을 정의하는 대규모 언어 모델(LLM) 컴포넌트입니다.
- Harness: Policy Model이 환경과 상호작용하는 방식을 중재하는 외부 스캐폴드(scaffold)로, 모델의 관찰 내용, 행동 실행 방식, 피드백 수신 및 에피소드 종료 시점을 결정합니다.
- H-step (Harness Optimization Step): 현재 Policy Model의 실패 모드를 분석하고 이를 보완하기 위한 새로운 Harness 후보들을 제안 및 선택하는 단계입니다.
- P-step (Policy Optimization Step): 최적화된 Harness 하에서 Policy Model을 강화 학습(Reinforcement Learning, RL)을 통해 업데이트하는 단계입니다.
- Resolve Rate: 생성된 패치(patch)가 벤치마크 검증자를 통과하는 태스크의 백분율로, 에이전트 성능의 핵심 지표입니다.
- pass@k: 주어진 태스크에 대해 에이전트가 최대
k번의 시도 내에 성공할 수 있는 확률을 측정하는 지표입니다.pass@1은 신뢰성(reliability)을,pass@kk는 역량 한계(capability frontier)를 나타냅니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Large Language Model (LLM) 기반 코딩 에이전트의 Harness와 Policy가 상호 보강적임에도 불구하고, 기존 연구들이 한쪽 컴포넌트만 최적화하여 발생하는 성능 한계를 지적합니다. 기존 연구에서 Harness만 최적화할 경우 근본적인 모델 역량을 향상시킬 수 없으며, Policy만 최적화할 경우 고정된 Harness가 유도하는 제한적인 궤적(trajectories) 내에서만 학습이 이루어지는 문제가 있었습니다. 또한, 최근 시도된 Harness와 Policy의 동시 최적화 연구들은 외부 프러포저(proposer)에 의존하며, Policy와 그 실패 모드가 진화함에 따라 최적화 대상이 계속 변화하는 문제에 직면해 있었습니다. 이러한 문제들은 코딩 에이전트의 자율적인 자가 개선(self-driven evolution)을 어렵게 만들며, 변화하는 환경과 에이전트의 역량에 맞춰 Harness와 Policy가 유기적으로 발전할 수 있는 프레임워크의 필요성을 제기합니다. 본 연구는 이러한 한계들을 극복하고 에이전트의 지속적인 자가 진화를 가능하게 하는 새로운 접근 방식을 제안합니다 [Figure 2].
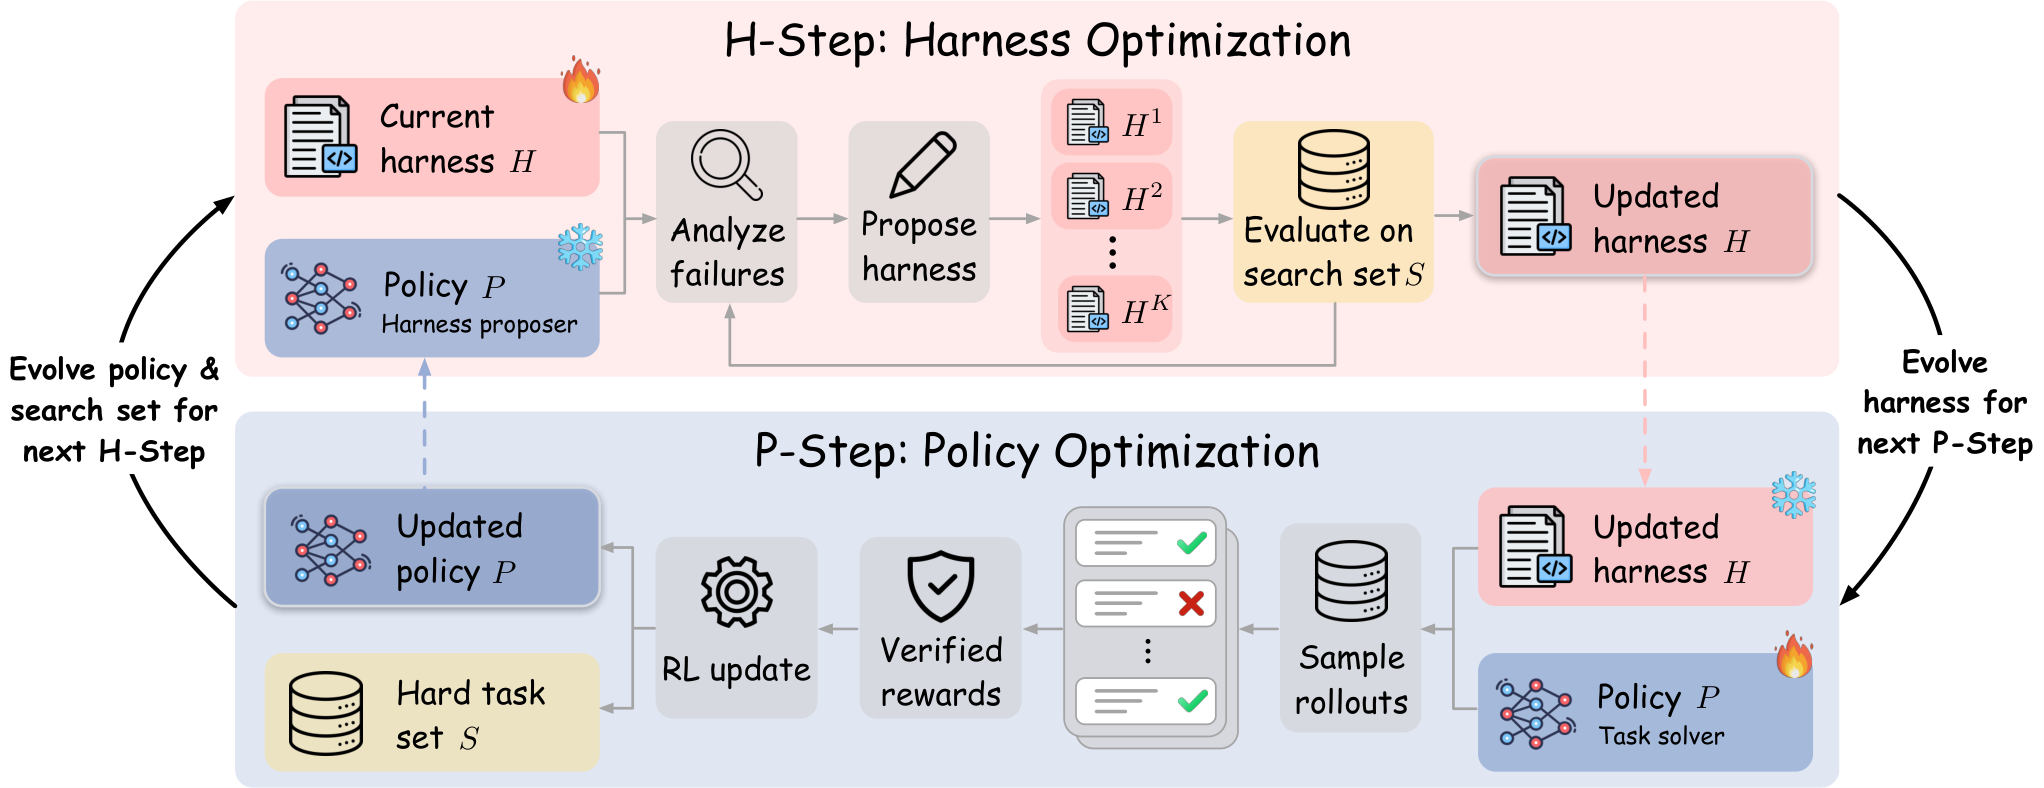
Figure 2 — Self-HPO 방법론 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Harness와 Policy의 동시적, 재귀적 자가 개선을 위한 Self-HPO (Self-Evolving via Harness-Policy Optimization) 프레임워크를 제안합니다. Self-HPO는 H-step (Harness Optimization)과 P-step (Policy Optimization)을 교대로 수행하며 에이전트 자체의 Policy를 Harness Proposer로 활용합니다. H-step에서는 현재 (고정된) Policy가 자신의 실패 궤적(failed trajectories)을 분석하여 새로운 Harness 후보들을 제안하고, 검색 세트(search set)에서의 성능을 기반으로 최적화된 Harness를 선택합니다. 이 검색 세트는 이전 P-step에서 식별된 "어려운 태스크(hard tasks)"로 구성되어, Harness 최적화가 Policy의 진화하는 실패 모드에 효과적으로 대응하도록 합니다. P-step에서는 새로 최적화된 Harness 하에서 Policy가 강화 학습(Reinforcement Learning, RL), 특히 GRPO(Group Relative Policy Optimization)와 BAR(Balanced Adaptive Rollout)를 사용하여 업데이트됩니다. 이때 학습 과정에서 해결되지 않은 태스크들이 다음 H-step의 새로운 검색 세트로 활용됩니다.
핵심 결과로, Self-HPO는 세 가지 코딩 벤치마크인 SWE-Bench Verified, SWE-Bench Multilingual, SWE-Bench Pro에서 Harness-only 및 Policy-only baseline들을 일관되게 능가하는 성능을 보였습니다. 특히, Qwen3.5-35B-A3B 모델을 기반으로 한 Self-HPO는 평균 Resolve Rate를 57.8%에서 64.8%로 향상시켰습니다. SWE-Bench Verified에서는 기본 Resolve Rate인 61.0%를 69.5%까지 높였으며, 이러한 성능 향상은 out-of-distribution 설정인 SWE-Bench Multilingual 및 SWE-Bench Pro에서도 각각 5.5% 및 6.9% 포인트의 개선을 보이며 일반화되는 것을 확인했습니다. 분석 결과, 최적화된 Harness와 Policy 각각이 개별적으로도 성능 향상에 기여하지만, 이들을 결합했을 때의 joint gain은 개별 개선 폭의 합을 초과하여 시너지 효과를 입증했습니다. 또한, Self-HPO는 pass@1(신뢰성)을 향상시키고 pass@kk(역량 한계)를 확장하는 효과를 보였으며, SWE-Bench Verified에서 pass@8이 80.0%에서 84.8%로 증가했습니다 [Figure 4]. 이는 학습 과정에서 zero-success rollout groups의 비율을 줄여 reward sparsity 문제를 완화했기 때문입니다. 이러한 결과는 Harness와 Policy의 상호 보완적인 최적화가 에이전트 성능 향상에 필수적임을 강력하게 지지합니다 [Figure 3].
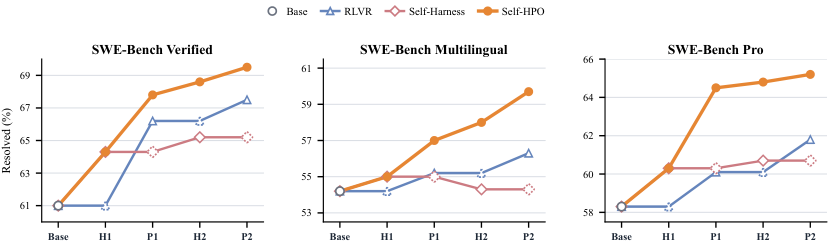
Figure 3 — 최적화 궤적 및 성능
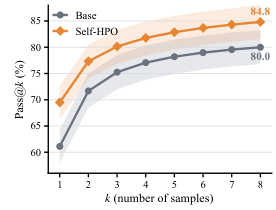
Figure 4a — Pass@kk 성능 곡선
4. Conclusion & Impact (결론 및 시사점)
본 논문은 코딩 에이전트의 Harness와 Policy를 재귀적으로 자가 개선하는 Self-HPO 프레임워크를 성공적으로 제안했습니다. 이 프레임워크는 진화하는 Policy를 Harness Proposer로 활용하고, RL을 통해 Policy를 업데이트하며, 이전 학습 단계에서 식별된 어려운 태스크를 다음 Harness 검색 세트로 제공함으로써 Harness 최적화가 Policy의 진화하는 실패 모드에 지속적으로 적응하도록 합니다. 실험 결과는 Self-HPO가 기존의 단일 컴포넌트 최적화 방식들을 일관되게 능가하며, Qwen3.5-35B-A3B의 평균 Resolve Rate를 57.8%에서 64.8%로 대폭 개선했음을 입증했습니다. 이러한 연구는 LLM 기반 에이전트가 복잡한 소프트웨어 엔지니어링 태스크에서 더욱 자율적이고 효과적으로 작동할 수 있는 중요한 가능성을 제시합니다. 학계와 산업계에 미치는 시사점은, 에이전트 시스템 설계 시 Harness와 Policy를 동적으로 상호 최적화하는 것이 지속적인 성능 향상과 새로운 역량 발현에 필수적이라는 점을 강조한다는 것입니다. 이는 궁극적으로 더욱 견고하고 적응력 있는 자율 코딩 에이전트의 개발을 가속화할 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] HarnessOpt-Bench: Evaluating LLMs at Harness Optimization
- [논문리뷰] Reinforcement Learning for Self-Improving Agent with Skill Library
- [논문리뷰] Bootstrapping Task Spaces for Self-Improvement
- [논문리뷰] VeriFine: Scaling Verification for Self-Improvement in Embodied Reasoning
- [논문리뷰] Understanding and Enhancing Backdoor Persistency in LLM Agent Post-Training
Review 의 다른글
- 이전글 [논문리뷰] Scaling Parameter-Efficient Fine-Tuning for Brain Encoding
- 현재글 : [논문리뷰] Self-Evolving Coding Agents via Harness-Policy Optimization
- 다음글 [논문리뷰] Sparse Feature Policy Unlearning Mitigates State Hallucination in Vision-Language-Action Models
댓글