[논문리뷰] TinyAstral: Transferring Self-Evolving Harnesses to Tiny Generalist Manipulation Agents
링크: 논문 PDF로 바로 열기
메타데이터
저자: Kehong Gong, Xiaoxu Zheng, Guanli Hou, Seunghun Lee, Mengqi Guo, Runjia Tan, Zhengyu Wen, Qi Wang, Xiaoyu He, Mingyuan Zhang, Michael Bi Mi
1. Key Terms & Definitions (핵심 용어 및 정의)
- Harness: 로봇 에이전트의 Planner 모델을 둘러싼 도구, 피드백 메커니즘, 작업 기억(Task Memory), 실패 복구 논리 등을 포괄하는 시스템 인터페이스를 지칭함.
- RSI (Recursive Self-Improvement): Frozen된 Planner의 Trajectory를 분석하여 Master LLM이 Harness를 단계적으로 개선하고, 통계적 검증을 통해 수정안을 채택하는 반복적 최적화 과정.
- Strict Success (SS): 에이전트가
done을 명시적으로 호출하고, 환경의 최종 상태가 벤치마크 성공 조건을 만족할 때만 인정되는 엄격한 성능 지표. - Recovery Branches: 성공한 에피소드 중간에 고의적인 방해(Perturbation)를 삽입하여 에이전트가 오류를 스스로 극복하고 다시 목표를 달성하도록 유도하는 학습 데이터 구성 기법.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 대규모 VLM(Vision-Language Model) 기반 로봇 에이전트의 성능을 저비용 모델로 이전하는 문제를 해결하기 위해 TinyAstral 프레임워크를 제안한다. 기존 연구들은 대형 모델의 높은 추론 비용으로 인해 실제 배포에 한계가 있으며, Harness의 설계가 에이전트 성능에 결정적임에도 불구하고 이를 체계적으로 개선하고 전이하는 방법론이 부족했다. 저자들은 Harness의 개선이 Planner와 무관하게 이루어질 수 있다는 점에 착안하여, Harness 진화(Evolution)와 에이전트 증류(Distillation)를 결합한 새로운 파이프라인을 구축하고자 한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
TinyAstral은 Frozen된 대형 Teacher 모델의 Harness를 RSI를 통해 고도화한 후, 해당 Harness를 고정하고 Teacher의 추론 및 복구 Trajectory를 Small 모델로 증류하는 2단계 접근 방식을 취한다 [Figure 2]. 1단계에서는 Master LLM이 Teacher의 실패 사례를 분석하여 통계적 가설 검증(Paired Statistical Test)을 통과한 Harness Edits만을 반영한다. 2단계에서는 최적화된 Harness 환경에서 수집된 고품질 데이터를 사용하여 Qwen3.5-4B와 같은 경량화 모델을 학습시킨다 [Figure 2].
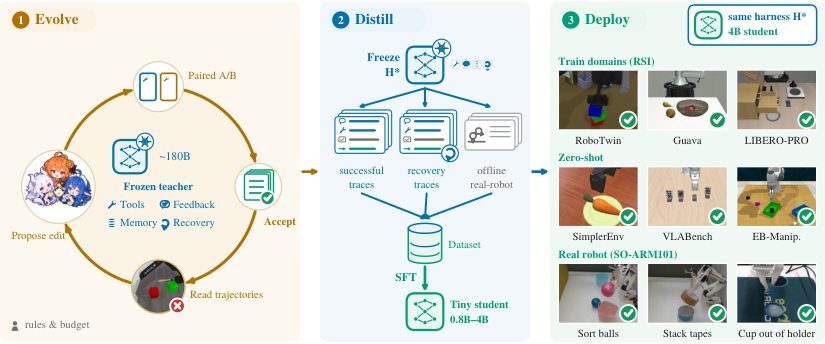
Figure 2 — TinyAstral 전체 프레임워크 개요
주요 실험 결과, Harness 진화를 통해 Teacher의 RoboTwin 성공률은 33.4%에서 63.6%로 향상되었으며, 이를 증류받은 4B 학생 모델은 62.8%의 높은 성공률을 기록하였다 [Table 1]. 또한, TinyAstral-4B 모델은 벤치마크 에피소드에서 Teacher 모델 대비 약 1/5 수준의 가속기(Accelerator) 시간만을 사용하면서도, 기존의 대형 모델들보다 우수한 성능을 보였다 [Table 2]. 특히, 학습 데이터에 포함되지 않은 미지의 벤치마크(SimplerEnv, VLABench 등)에서도 552B 규모의 Planner와 대등한 성능을 보여 일반화 능력을 입증하였다 [Table 2].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 고도화된 Harness가 대형 모델의 판단 능력을 소형 모델로 성공적으로 전달할 수 있음을 증명하였다. TinyAstral은 모델 증류와 시스템 엔지니어링(Harness Evolution)의 결합을 통해 계산 효율성과 성능 간의 트레이드오프를 획기적으로 개선하였다. 이는 복잡한 로봇 제어 시스템에서 대규모 파라미터 없이도 고성능 에이전트를 구축할 수 있는 실용적인 경로를 제시하며, 향후 Edge 컴퓨팅 기반 로봇 생태계에 중요한 기술적 이정표가 될 것으로 기대된다.
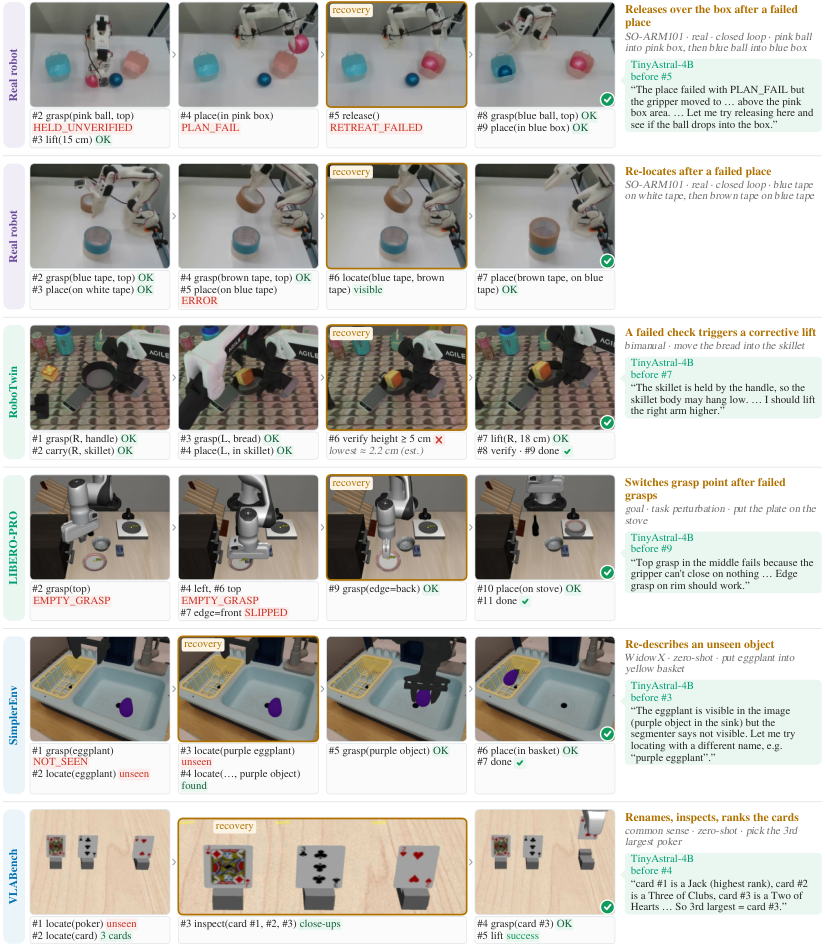
Figure 3 — 에이전트의 실패 복구 정성적 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] CaPtain: A Pipeline for Post-Training Code-as-Policy Robot Agents
- [논문리뷰] Show-Harness: Just a VLM Agent Can Play Robots
- [논문리뷰] GEM: Generative Supervision Helps Embodied Intelligence
- [논문리뷰] Unified Reinforcement and Imitation Learning for Vision-Language Models
- [논문리뷰] Where Do Vision Language Models Fail at 3D Reasoning?
Review 의 다른글
- 이전글 [논문리뷰] TaoMate-FVSR:Audio-Guided Facial Video Restoration
- 현재글 : [논문리뷰] TinyAstral: Transferring Self-Evolving Harnesses to Tiny Generalist Manipulation Agents
- 다음글 [논문리뷰] Video Generation Meets Agent Harness: Agentic Video Generation, Agentic World Modeling and Recursive Self-Improvement
댓글