[논문리뷰] TaoMate-FVSR:Audio-Guided Facial Video Restoration
링크: 논문 PDF로 바로 열기
메타데이터
저자: Xinyang Li, Zeran Xu, Qijun Gan, Chenwei Zhang, Meiguang Jin, Junfeng Ma
1. Key Terms & Definitions (핵심 용어 및 정의)
- Source-Noise Mixing: 입력된 저해상도 비디오의 정보를 보존하면서도, 오디오 지시에 따라 입 모양 등을 새롭게 생성하기 위해 원본 Latent와 Gaussian Noise를 혼합하는 초기화 기법입니다.
- Structured Reference Injection: 참조 이미지(Reference Frame)와 최근 생성된 비디오 히스토리를 독립적인 Temporal Slot에 주입하여, 출력 영상이 참조 프레임의 고정된 입 모양을 그대로 복제하지 않도록 하면서도 외형 일관성을 유지하게 하는 기법입니다.
- Audio-Guided Lip Correction: 오디오와 영상 간의 동기화를 강화하기 위해, 서로 다른 발화 내용을 가진 더빙 소스(Dubbed Source)를 사용하여 모델이 입력 립 모션을 복사하는 대신 타겟 오디오를 따르도록 학습시키는 프로세스입니다.
- Visual Dubbing: 원본 오디오가 아닌 교체된 오디오에 맞추어 얼굴의 립 싱크와 턱 움직임을 실시간으로 수정하는 기술입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 AIGC로 생성된 비디오에서 얼굴 부위가 저해상도로 표현되거나, 복원된 입 모양이 실제 발화 오디오와 일치하지 않는 문제를 해결하고자 합니다. 기존의 단순한 Video Super-Resolution 기법은 외형을 선명하게 만들 수는 있으나, 발화 내용과 구강 구조 간의 상관관계를 고려하지 않아 시각적 불일치를 초래합니다 [Figure 1]. 이러한 한계를 극복하기 위해 저자들은 오디오 가이드를 복원 프로세스에 직접 통합하여, 저해상도 입력 데이터의 신뢰성이 낮더라도 오디오에 최적화된 자연스러운 얼굴 움직임을 생성하는 새로운 프레임워크를 제안합니다.
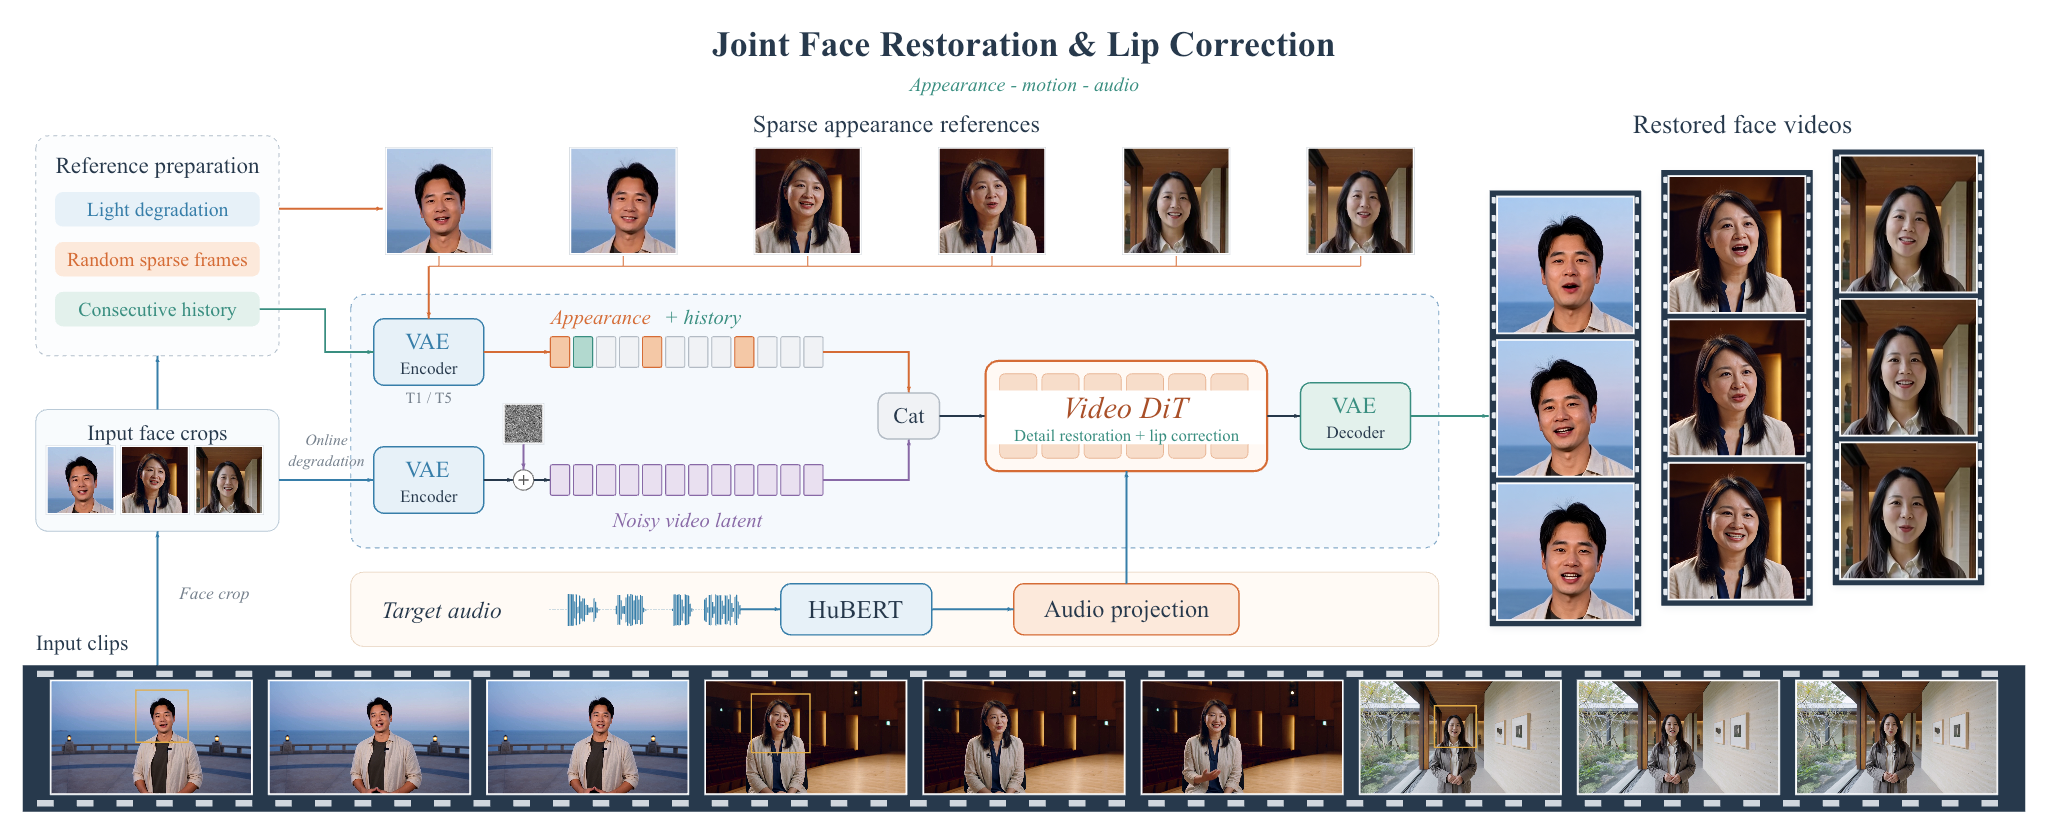
Figure 1 — 오디오 가이드 기반 얼굴 복원 개념도
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들이 제안하는 TaoMate-FVSR은 Video Flow Model을 기반으로 하며, 학습은 시각적 복원과 오디오 기반 립 교정(Lip Correction)의 2단계로 진행됩니다 [Figure 2]. Source-Noise Mixing을 통해 입력의 구조를 보존하면서도 확산 기반의 유연한 복원을 수행하며, Structured Reference Injection을 통해 참조 프레임의 외형 정보와 최근 모션 컨텍스트를 분리하여 주입함으로써 안정적인 영상 품질을 확보합니다. 150개의 비디오 벤치마크 평가 결과, TaoMate-FVSR은 기존 SOTA 복원 모델 대비 LPIPS(0.0793)와 DISTS(0.0858)에서 가장 우수한 성능을 보이며 Perceptual Similarity를 크게 향상시켰습니다 [Table 1]. 또한, 교체 오디오를 활용한 Visual Dubbing 테스트에서도 동기화 지표인 Sync-C(8.175)와 Sync-D(7.083)에서 기존 파이프라인(SR 후 Dubbing 모델)을 압도하며 가장 높은 시각적 품질을 달성하였습니다 [Table 2].
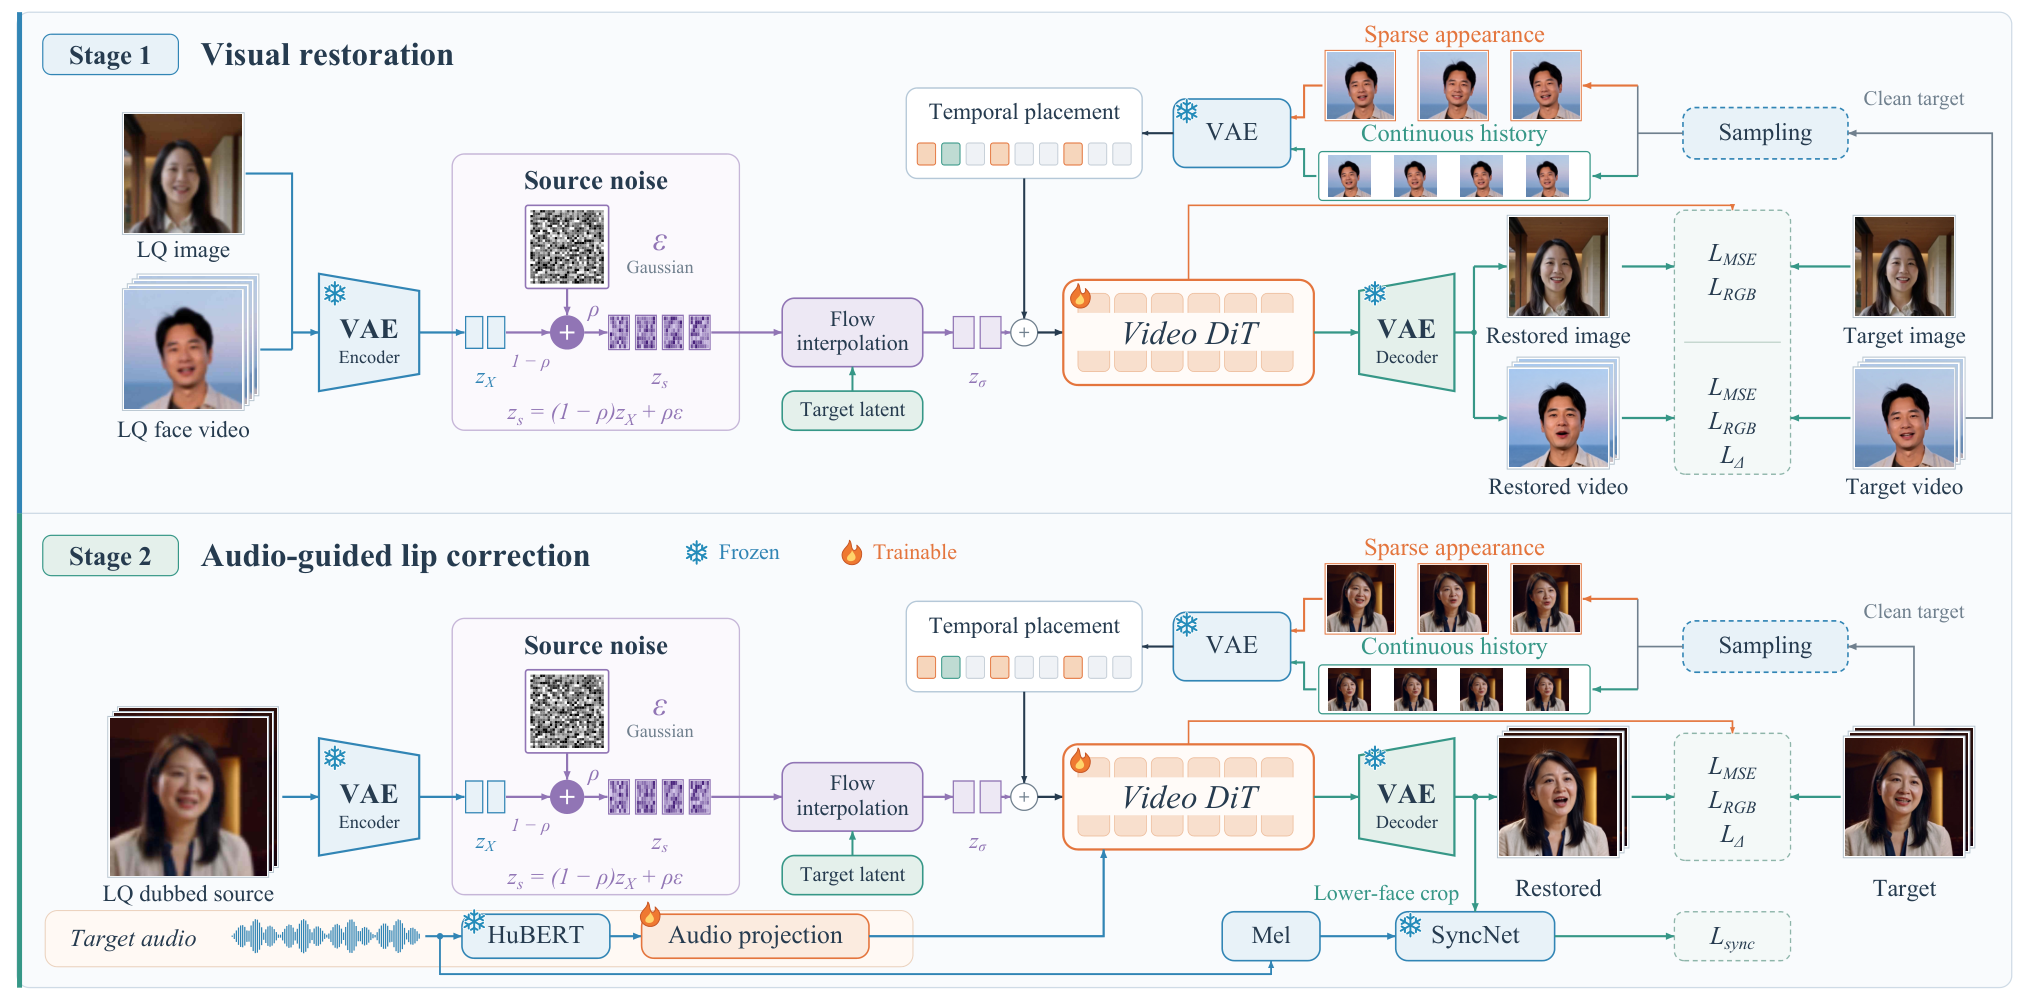
Figure 2 — TaoMate-FVSR 전체 모델 아키텍처
4. Conclusion & Impact (결론 및 시사점)
본 연구는 타겟 오디오를 복원 과정에 직접 참여시킴으로써 기존의 시각적 복원 방식이 가진 모호성을 해결하고 동기화 성능을 크게 향상시켰습니다. 제안된 프레임워크는 단순히 저해상도 영상을 선명하게 하는 수준을 넘어, 오디오 기반의 립 싱크 수정과 같은 고도화된 영상 편집 기능을 단일 파이프라인에서 통합적으로 제공한다는 점에서 차별성을 갖습니다. 이 연구는 고품질의 AIGC 콘텐츠 생산을 필요로 하는 미디어 및 제작 산업에 중요한 기술적 기반을 제공할 것으로 기대됩니다. 다만, 오디오 기반의 얼굴 수정 기술이 악용될 가능성을 고려하여 적절한 권한 및 고지 절차의 필요성 또한 강조하고 있습니다.
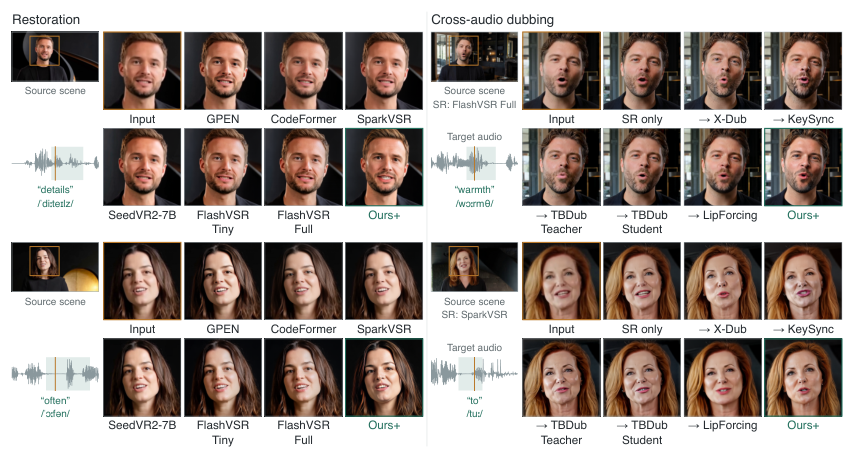
Figure 3 — AIGC 영상 대상 복원 정성적 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] ProgramDistill: From Interactive Web Apps to Verifiable Reference-Guided SWE Tasks
- [논문리뷰] The Consistency Critic: Correcting Inconsistencies in Generated Images via Reference-Guided Attentive Alignment
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] GSFixer: Improving 3D Gaussian Splatting with Reference-Guided Video Diffusion Priors
- [논문리뷰] WorldFlow: Joint Video and 3D Motion Prediction via Large-Scale Pretraining
Review 의 다른글
- 이전글 [논문리뷰] Self-Improvement with Auxiliary Rewards: Learning from Verified Traces and Evaluating Transfer
- 현재글 : [논문리뷰] TaoMate-FVSR:Audio-Guided Facial Video Restoration
- 다음글 [논문리뷰] TinyAstral: Transferring Self-Evolving Harnesses to Tiny Generalist Manipulation Agents
댓글