[논문리뷰] WorldFlow: Joint Video and 3D Motion Prediction via Large-Scale Pretraining
링크: 논문 PDF로 바로 열기
저자: Yuhao Lu, Jiongxu Chen, Hexiang Wei, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- WorldFlow: 미래의 시각적 영상(Video)과 3D 궤적(Trajectory)을 동시에 예측하도록 설계된 생성적 세계 모델(Generative World Model)입니다.
- MoT (Mixture-of-Transformers): 시각 데이터와 3D 흐름(Flow) 정보를 공유된 어텐션 메커니즘을 통해 처리하여 두 모달리티를 통합적으로 학습하는 아키텍처입니다.
- Rectified-Flow Objective: 노이즈로부터 비디오와 3D 모션 토큰을 점진적으로 복원(Denoising)하는 학습 목표 함수입니다.
- ADE/FDE: 각각 Average Displacement Error와 Final Displacement Error를 지칭하며, 예측된 모션 궤적의 물리적 정확도를 평가하는 핵심 정량 지표입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 비디오 세계 모델이 3D 동역학을 암시적으로만 처리하고, 액션 기반 모델은 특정 로봇 설정에 종속적이라는 문제를 해결하고자 합니다. 기존의 독립적인 3D 모션 예측 모델은 단순한 흐름(Flow) 데이터에만 의존하여 물리적 상식 학습에 한계가 있었습니다. 이를 극복하기 위해 저자들은 시각적 진화와 명시적인 3D 기하학적 모션을 결합하여 물리적 상식을 통합적으로 학습하는 모델을 제안합니다 [Figure 1].
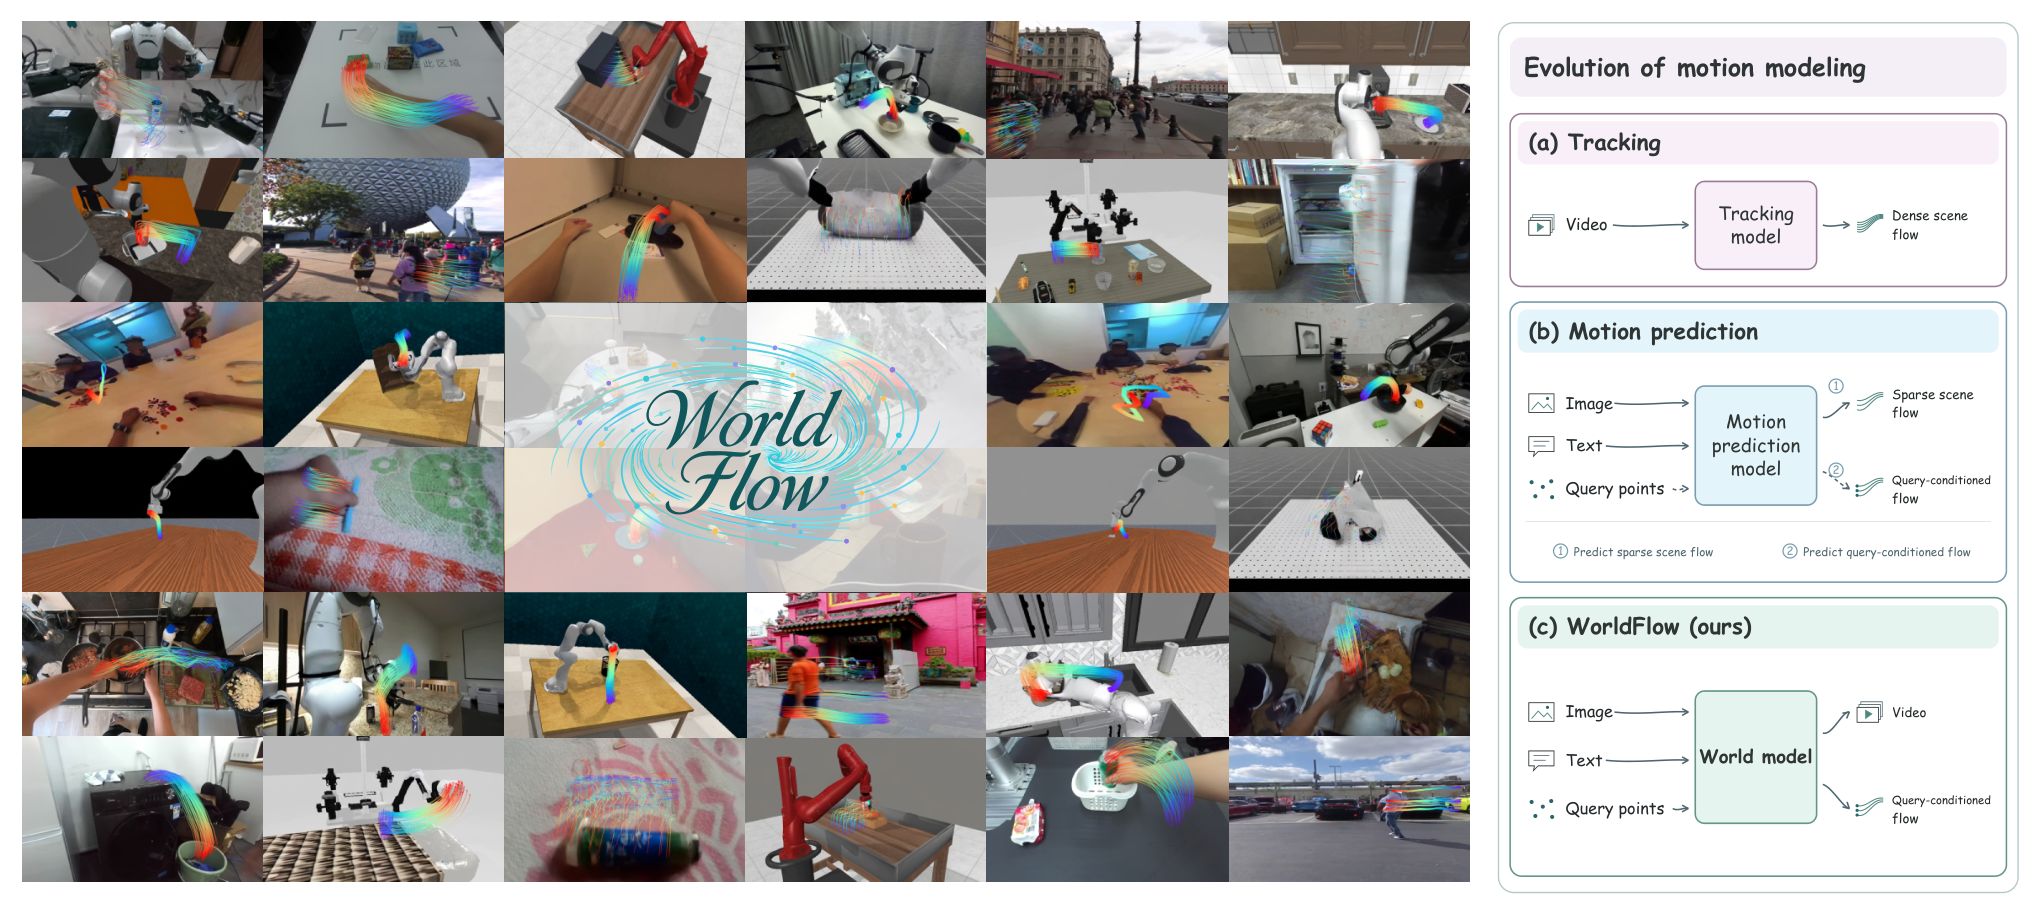
Figure 1 — WorldFlow의 모션 모델링 개념
3. Method & Key Results (제안 방법론 및 핵심 결과)
WorldFlow는 언어 지시어, 초기 이미지 프레임, 그리고 3D 쿼리 포인트(Query Points)를 입력받아 비디오와 3D 흐름을 동시에 예측하는 통합 프레임워크를 제공합니다 [Figure 2]. 3D 모션은 연속적인 변위 토큰(Displacement Tokens)으로 파라미터화되어 비디오 토큰과 공간적으로 정렬되며, 동일한 MoT 백본을 통해 생성됩니다. 실험 결과, WorldFlow는 SpatialCog 데이터셋에서 기존 대비 ADE를 54.2% 감소시켰으며, 흐름 전용(Flow-only) 모델 대비 FDE를 68.5% 개선하는 성능을 보였습니다 [Table 1]. 또한, 실제 로봇 조작 태스크에서 WorldFlow는 μ0 대비 97.2%의 흐름 예측 성공률을 기록하며 높은 정밀도를 입증했습니다 [Table 2]. 정성적 비교에서 기존 방식들보다 더 정확한 궤적 예측을 수행하는 것을 확인했습니다 [Figure 3].
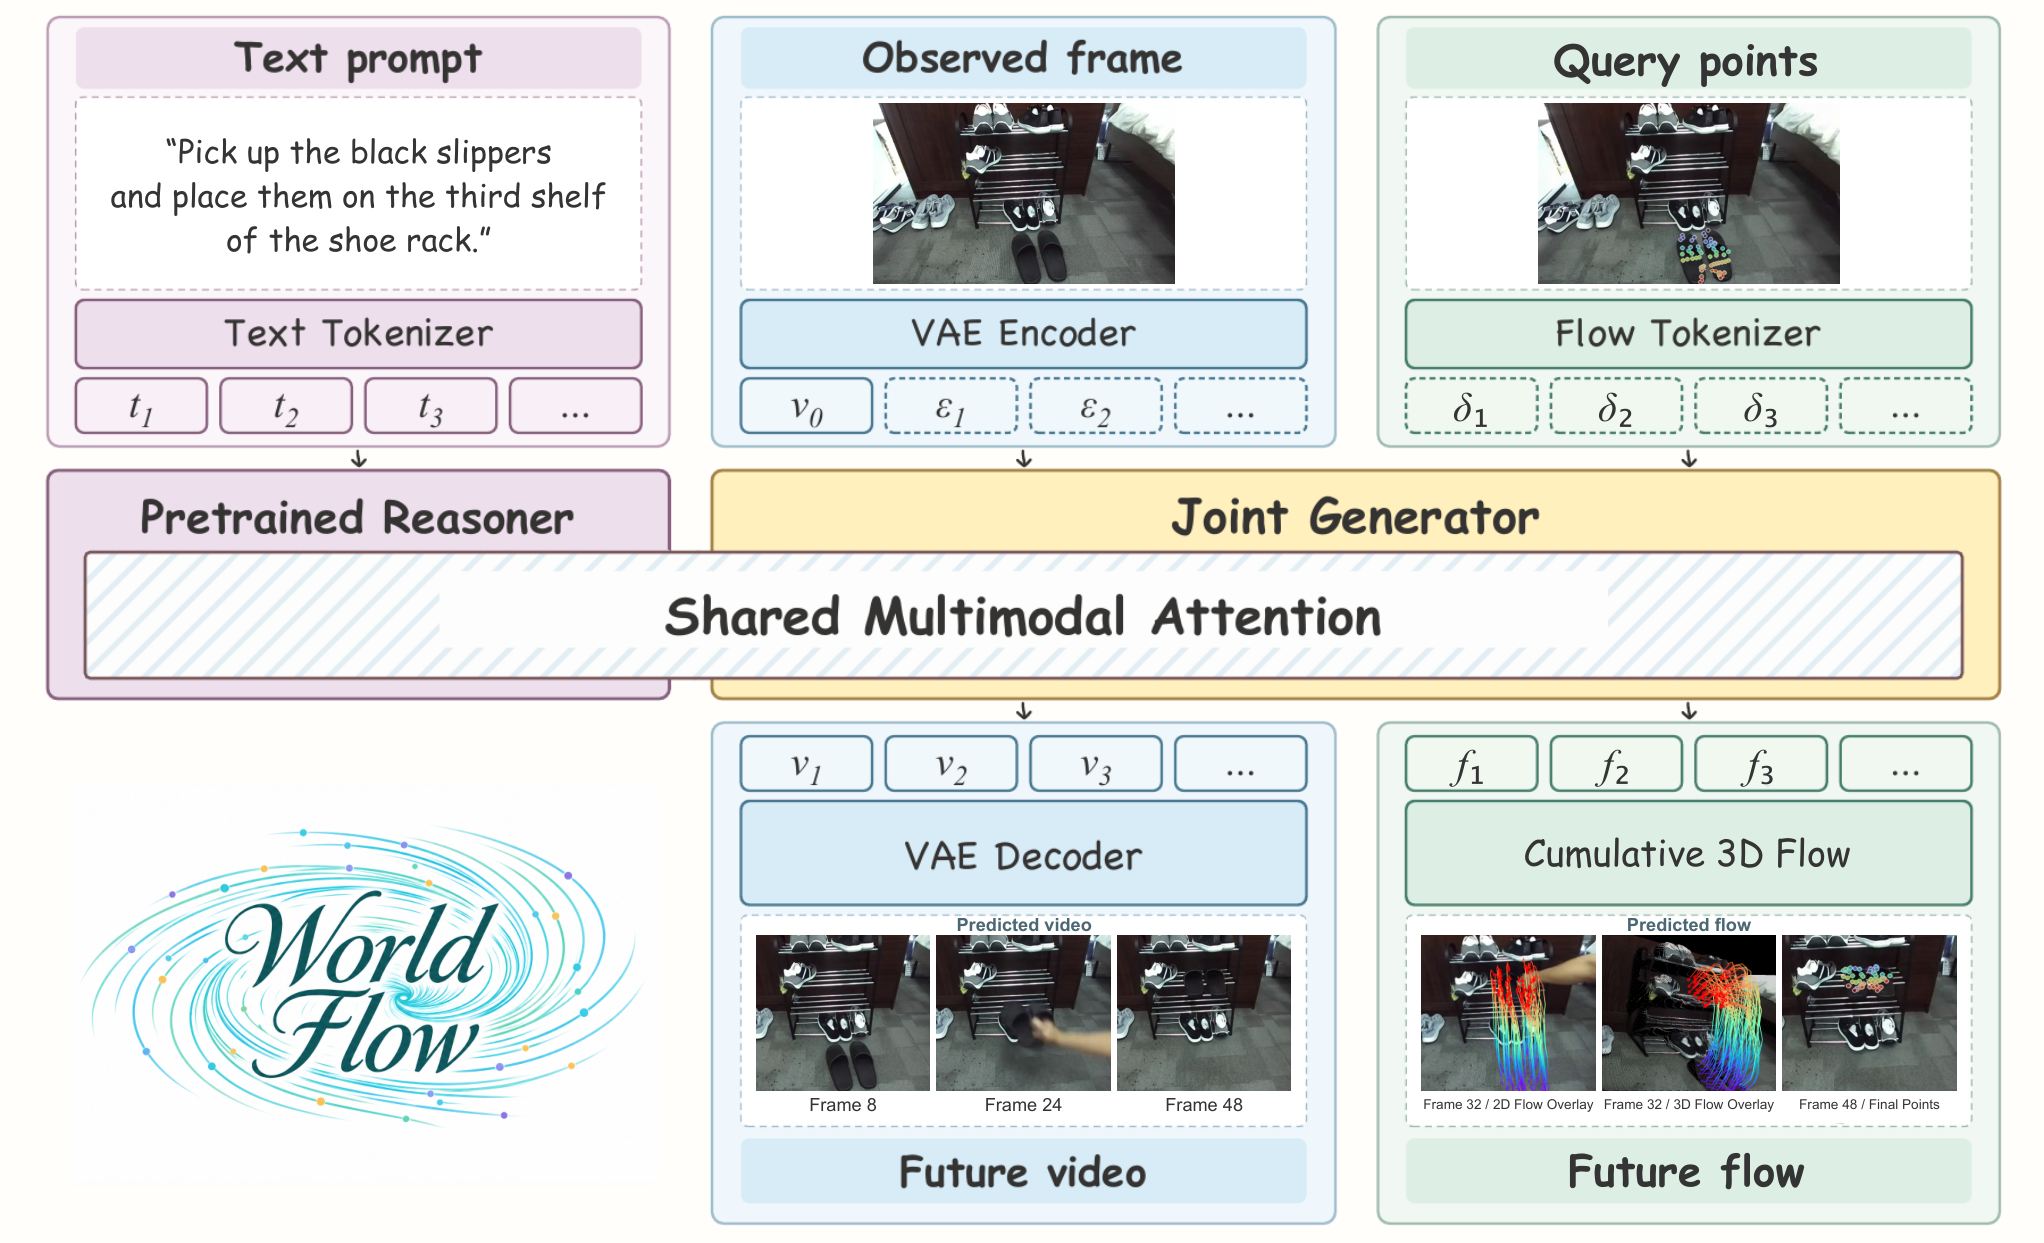
Figure 2 — WorldFlow 전체 아키텍처
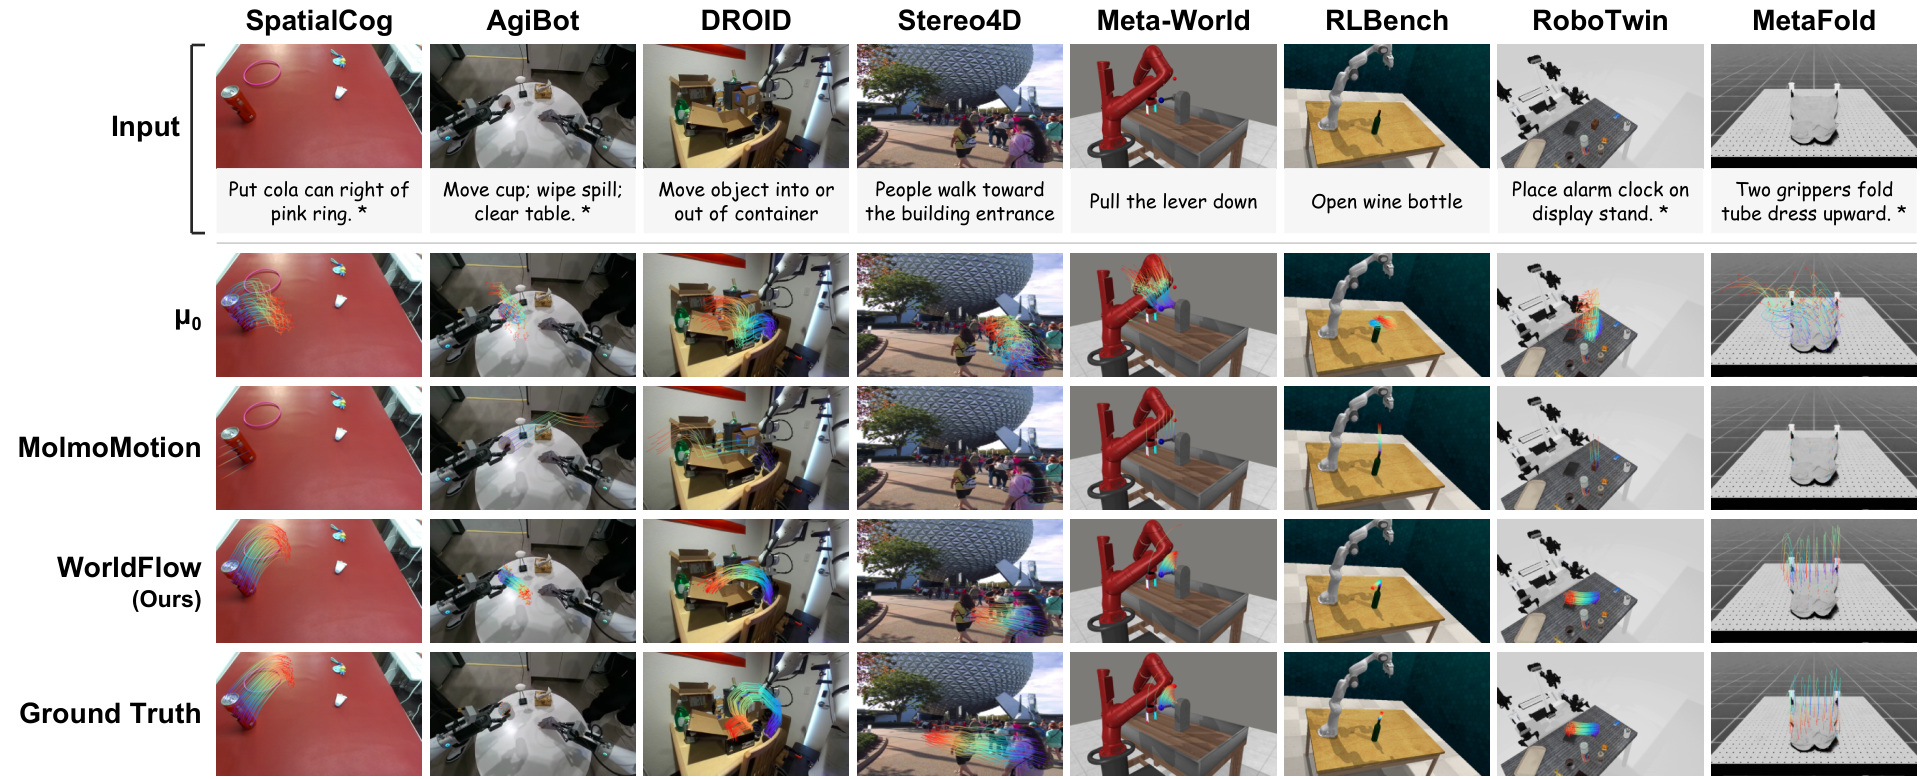
Figure 3 — 정성적 비교 결과
4. Conclusion & Impact (결론 및 시사점)
본 연구는 영상과 3D 모션을 통합적으로 생성하는 것이 물리적 추론의 정확도를 크게 향상시킨다는 점을 입증했습니다. WorldFlow는 향후 로봇 공학에서 요구되는 고차원적 물리 상식과 시각적 예측 능력을 결합한 모델링의 새로운 기준을 제시합니다. 이러한 접근 방식은 로봇이 복잡한 환경에서 보다 정밀하고 지능적인 상호작용을 수행하는 데 크게 기여할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] World Embedding Benchmark
- [논문리뷰] SmartMage: Dynamic Modality Orchestration for 3D Scene Understanding
- [논문리뷰] PhysisForcing: Physics Reinforced World Simulator for Robotic Manipulation
- [논문리뷰] Chain of World: World Model Thinking in Latent Motion
- [논문리뷰] Unified Diffusion VLA: Vision-Language-Action Model via Joint Discrete Denoising Diffusion Process
Review 의 다른글
- 이전글 [논문리뷰] Where Do Vision Language Models Fail at 3D Reasoning?
- 현재글 : [논문리뷰] WorldFlow: Joint Video and 3D Motion Prediction via Large-Scale Pretraining
- 다음글 없음
댓글