[논문리뷰] World Embedding Benchmark
링크: 논문 PDF로 바로 열기
저자: Yiqi Liu, Ruifeng Yuan, Yang Wang, et al.
Part 1: 요약 본문
1. Key Terms & Definitions (핵심 용어 및 정의)
- World Embedding Benchmark: 비디오 임베딩이 물리적 정보를 얼마나 잘 인코딩하고 정렬하는지 평가하기 위해 제안된 포괄적인 벤치마크. Fluid Mechanics, Solid Mechanics, Dynamics, Optics & Electromagnetism의 4가지 물리 분야에 걸쳐 80개 패밀리의 8,000개 시뮬레이션 케이스로 구성된다.
- Physical Fidelity: 생성된 비디오가 시각적 사실성뿐만 아니라 물리적 상식 및 시스템의 동작을 얼마나 정확하게 따르는지에 대한 척도이다.
- Text-Video Retrieval: 물리적 설명과 시뮬레이션 비디오 간의 Cross-Modal Matching 성능을 측정하는 작업이다.
- Physical-Property Regression: Freeze된 비디오 임베딩에서 연속적인 물리적 양(Continuous Physical Quantities)을 경량화된 Regression 모델로 회복(Recover)할 수 있는지 측정하는 작업이다.
- Pair Classification: 모델이 후보 중에서 올바른 비디오-설명 쌍을 구별할 수 있는지 평가하는 작업이다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
비디오 생성 모델을 World Model로 활용하려는 노력에 있어 Physical Fidelity는 핵심적인 요소이다. 현재 비디오 생성 모델은 시각적으로는 그럴듯한 장면을 생성하지만, 물리적 상식(Physical Commonsense) 준수 측면에서는 상당한 격차가 존재한다. 이처럼 물리적 Fidelity에 대한 관심이 증가하면서, 비디오 임베딩(Video Embeddings)에 물리 세계에 대한 어떤 정보가 보존되며, 그 정보가 얼마나 접근 가능한지에 대한 근본적인 질문이 제기된다. 기존 연구들은 주로 물리적 Dynamics 학습을 위한 Scientific Simulation Benchmark를 제공하지만, Multimodal Embeddings 평가에는 통제된 환경 내에서 Video-Language 관측 및 정량적 물리적 Target이 필요하다. 본 논문은 이러한 한계점을 해결하고, Cross-Modal Alignment와 물리 정보의 Recoverability를 동시에 측정할 수 있는 벤치마크의 필요성에서 출발한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 비디오 임베딩 내 물리적 정보를 평가하기 위한 World Embedding Benchmark를 제안한다 [Figure 1]. 이 벤치마크는 Fluid Mechanics, Solid Mechanics, Dynamics, Optics & Electromagnetism 분야의 80개 물리 패밀리에 걸쳐 8,000개의 제어된 시뮬레이션 케이스로 구성된다. 각 케이스는 렌더링된 비디오와 시뮬레이션에서 파생된 물리적 Annotation을 쌍으로 포함하며, Text-Video Retrieval, Physical-Property Regression, Pair Classification의 세 가지 상호보완적인 Task를 지원한다. 시뮬레이션 생성에는 OpenFOAM, FEniCSx/DOLFINx, Project Chrono, HCIPy, Mitsuba 3, MEEP FDTD 등의 검증된 시뮬레이션 엔진이 활용되었다.
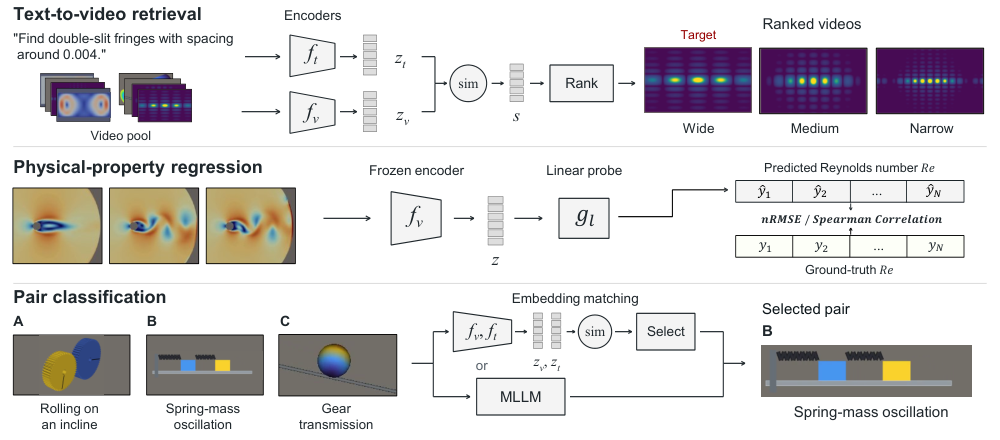
Figure 1 — 세 가지 평가 Task 개요
실험 결과, 기존의 Pre-trained Omnimodal Embedding Model들은 물리 인지 Cross-Modal Alignment에서 약한 성능을 보였다. Text-Video Retrieval 성능은 모든 4개 물리 분야에서 낮았고, Within-Family Pair Classification은 거의 Random Chance 수준에 머물렀다. 반면, Lightweight Regression Probe는 Freeze된 비디오 Representation에서 유용한 물리적 정보를 Recover하는 것으로 나타났다. 이는 임베딩이 물리적 속성을 예측할 수 있는 신호(Signals)를 유지하지만, 이 신호들이 Cross-Modal Similarity를 통해 쉽게 접근되지 않음을 시사한다.
Physics-specific Video-Text Pairs를 사용한 Continual Contrastive Training은 Retrieval 및 Pair Classification 성능을 향상시켰으나, Physical-Property Regression 성능은 저하시켰다. 예를 들어, LCO-Embedding-7B 모델은 Physics Adaptation 후 Retrieval Recall@10이 17.9%에서 21.0%로 향상되었지만, Regression nRMSE는 2.02에서 2.89로 악화되었다 [cite: 1, Table 2]. 이는 Cross-Modal Matching을 위한 임베딩 재구성(Reorganization)이 정량적 물리 정보의 Recoverability를 저해할 수 있음을 나타낸다. 마지막으로, 본 연구는 MiniMax-H3 모델을 활용한 Retrieval-Augmented Video Generation에서 물리 인지 임베딩의 유용성을 입증했다. Physics-adapted LCO-Embedding-3B 모델을 Retriever로 사용했을 때, PhyGenBench Average Score가 0.63에서 0.66으로 개선되었으며, 강력한 Retrieval 모델이 생성된 비디오의 Physical Fidelity를 더욱 향상시키는 것으로 나타났다 [cite: 1, Table 3]. 이러한 결과는 물리적 Representation 개선이 Physical Scene의 보다 충실한 생성을 지원하는 실용적인 경로를 제공함을 보여준다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 World Embedding Benchmark를 통해 비디오 Representation이 물리적 정보를 포착하고 정렬하는 방식을 체계적으로 평가했다. 연구 결과는 Pre-trained Omnimodal Embeddings가 Recover 가능한 물리적 신호(Physical Signals)를 보존하지만, Cross-Modal 물리적 Alignment는 약하다는 점을 밝혀냈다. Physics-specific Contrastive Adaptation은 Retrieval 및 Pair Classification을 개선하는 반면, Physical-Property Regression은 저하시켜 Alignment와 정량적 정보 Recoverability 사이에 Trade-off가 존재함을 보여주었다. 이러한 결과는 Physically Grounded World Model을 위한 Representation 개발 시 Physical Alignment와 정보 Recoverability를 함께 평가하는 것의 중요성을 강조한다. 이 연구는 물리 기반 Representation이 물리 시스템 이해와 생성적 World Model 개선 사이의 유용한 다리 역할을 할 수 있음을 시사한다.
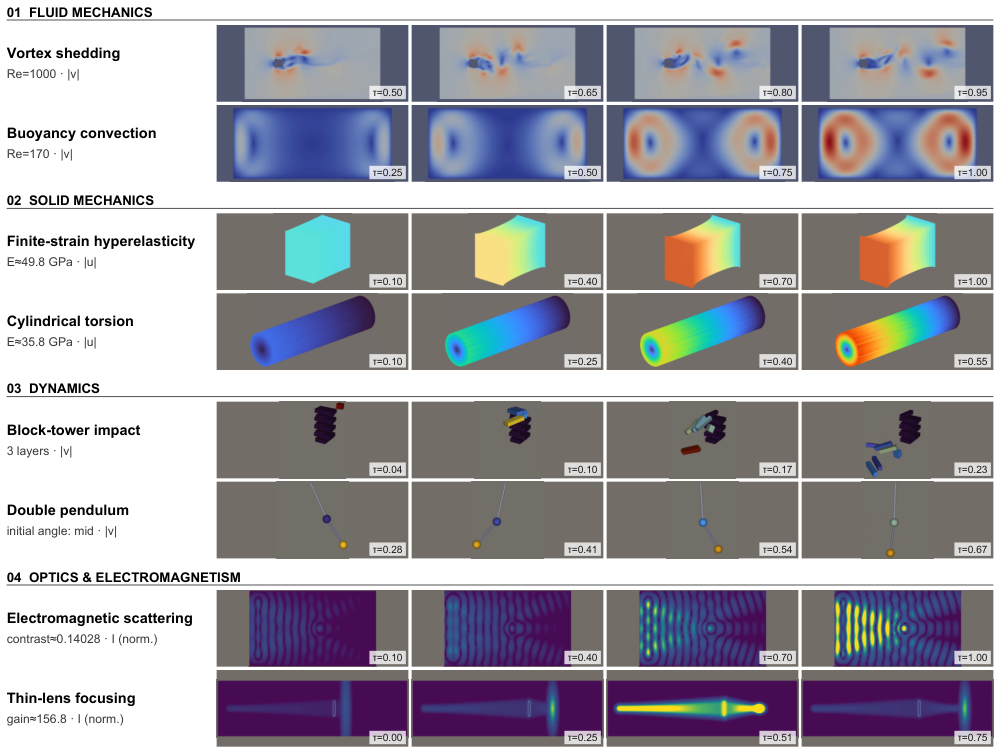
Figure 2 — 4가지 물리 분야 시뮬레이션 예시
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] World Models' Last Exam in Physics
- [논문리뷰] Spatial Memory Intelligence: Endowing World Models with Understanding-Driven Long-Term Memory
- [논문리뷰] World in World: Explore the World with World Models
- [논문리뷰] H3-World: Turning Language Understanding into World Control
- [논문리뷰] HarnessEval-W: Agentifying the Evaluation of Visual Worlds
Review 의 다른글
- 이전글 [논문리뷰] World Action Modeling with Progressive Visual Planning
- 현재글 : [논문리뷰] World Embedding Benchmark
- 다음글 [논문리뷰] ASCENT: Online Test-Time Training of Long-Horizon Agents via Self-Distillation of Verified Experience
댓글