[논문리뷰] World Action Modeling with Progressive Visual Planning
링크: 논문 PDF로 바로 열기
저자: Fei Zhang, Zhaochong An, Duncan Frost, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- World Action Models (WAMs): 초기 관측 및 지시로부터 미래의 Visual Dynamics와 Actions를 함께 예측하여 Robotic Control을 위한 유망한 패러다임으로 부상한 모델.
- Progressive Sub-goal Imagination: Long-Horizon 미래를 정규화된 Task Progress에 따라 인덱싱된 Sparse Visual Sub-goals의 정렬된 시퀀스로 표현하는 새로운 Visual Planning 패러다임.
- Mixture-of-Transformers (MoT): Video Generation Expert와 Lightweight Diffusion-based Action Expert로 구성되어 Policy Generation을 수행하는 ProWAM의 핵심 Architecture.
- Progress Coordinate (r): 현재 관측(
r=0)부터 Trajectory Endpoint(r=1)까지 남은 Demonstration Trajectory를 따라 상대적인 시간적 위치로 정의되는 정규화된 진행도. - Out-of-Distribution (OOD) Robustness: 모델이 학습 데이터와 현저하게 다른 데이터에 대해 우수한 성능을 보이는 능력.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존 World Action Models (WAMs)는 Dense Video Rollouts 생성의 비효율성으로 인해 Long-Horizon Prediction에 어려움을 겪고 있다. 일부 최신 WAMs는 전체 비디오를 생성하지 않고 단일 미래 프레임만 예측하지만, 이는 Goal을 향해 "How to Progress"하는 방법에 대한 Guidance를 제공하지 못한다. 이러한 디자인은 Dense Visual Rollouts가 High Computational Cost로 Short-Horizon Dynamics를 제공하는 반면, 다른 효율적인 대안들은 전체 Task에 걸친 Explicit Intermediate-Progress Guidance가 부족하다는 근본적인 Trade-off를 드러낸다. 본 연구는 이러한 Trade-off를 해결하고 Long-Horizon Robotic Control의 효율성과 Generalization 능력을 향상시키기 위해 Progressive Sub-goal Imagination 패러다임을 제안한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 단일 Fixed-State Prediction을 Progressive Sequence of Sparse Visual Sub-goals로 확장하는 Progressive World Action Model인 ProWAM을 제안한다. ProWAM은 각 Sub-goal이 현재 상태에 대한 정규화된 Progress Coordinate r로 인덱싱되어 Task Execution 전반에 걸쳐 Action Generation을 Anchor하는 Explicit Visual Guidance를 제공한다 [cite: 1, Figure 1]. ProWAM은 Video Generation Expert와 Lightweight Diffusion-based Action Expert로 구성된 Mixture-of-Transformers (MoT) Architecture를 채택한다 [cite: 1, Figure 2]. Video Expert는 Near-Term Future Transitions와 Progress-Conditioned Sub-goals를 공동으로 예측하며, Action Expert는 Current Observations와 Sub-goals에 Attends하여 Low-Level Action Chunks를 생성한다 [cite: 1, Figure 2]. 특히, Asymmetric Attention 메커니즘을 통해 Action 정보가 Visual Prediction Pathway를 변경하지 않도록 하여 Video Expert의 Generative Prior를 보존한다.
ProWAM의 Training은 Two-Stage로 이루어진다: Stage 1에서는 Video-Only Pretraining을 통해 Large-Scale Action-Free Videos에서 Visual Dynamics와 Progressive Sub-goal Prediction을 학습한다 [cite: 1, Figure 2]. Stage 2에서는 Robot Demonstrations에서 Video 및 Action Experts를 Joint Fine-tuning하여 Visual Planning을 Action Generation과 결합한다 [cite: 1, Figure 2]. Inference 시에는 단일 Video-Backbone Forward Pass를 통해 Sparse Sub-goal Features를 Cache하고 이를 Action Denoising 동안 재사용함으로써 반복적인 Full-Video Generation을 제거하여 효율적인 Closed-Loop Control을 가능하게 한다 [cite: 1, Figure 2]. 이러한 Sub-goal Caching 전략은 Video Expert Forward Passes를 T에서 1로 약 10배 감소시킨다.
광범위한 실험 결과, ProWAM은 뛰어난 Out-of-Distribution Robustness를 달성했다. Simulation Benchmark에서 LIBERO-Plus에서 85.8%의 성공률을 기록하여 새로운 State-of-the-Art (SOTA)를 달성했으며, 이는 가장 강력한 Baseline 대비 최대 +35.9%의 상대적 성능 향상이다. 또한, Randomize된 RoboTwin에서는 75.7%의 성공률을 기록하며 이전 WAM 대비 +20.0의 절대 성능 향상을 보였다. Challenging한 RoboCasa365 벤치마크에서는 Overall Success Rate 48.1%를 달성하여 Overall 4위를 기록했으며, 특히 Challenging한 Composite-Unseen Split에서 18.2%의 성공률을 보였다. Zero-shot Real-World Experiment에서는 Novel Scenes에서 70.0%의 성공률을 달성하여 가장 강력한 Baseline 대비 +15.0 (절대 마진)의 성능 향상을 입증했다. k=4 Sub-goals를 사용할 때 75.7% OOD 성공률로 효율성과 성능 간에 가장 유리한 Trade-off를 보였다 [cite: 1, Figure 4].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Progressive Visual Planning을 통해 Visual Planning과 Physical Control을 통합한 World Action Model인 ProWAM을 소개한다. ProWAM은 별도의 High-Level Planner 없이도 Long-Horizon Task를 Intermediate Sub-goal States로 분해하는 Hierarchical Policies에서 영감을 받아 Progressive Visual Sub-goal Prediction을 World-Modeling Process에 직접 통합한다. ProWAM의 Unified Architecture는 Large-Scale Action-Free Videos를 사용한 Pretraining 후 Joint Vision-Action Fine-tuning을 지원하여, Action Label 없이 학습된 Visual Dynamics가 Downstream Action Generation에 활용될 수 있도록 한다. 이러한 연구 결과는 Simulation Benchmark 및 Real-World Manipulation Task 전반에서 In-Domain, Randomized, Held-Out Long-Horizon Settings에 걸쳐 강력한 성능을 보여준다. 궁극적으로, Progressive Visual Prediction이 Visual Imagination과 Robotic Control 사이의 효과적인 Interface 역할을 하며, 복잡한 Robotic Manipulation Task의 Long-Horizon Control 및 Generalization을 위한 새로운 접근 방식을 제시한다.
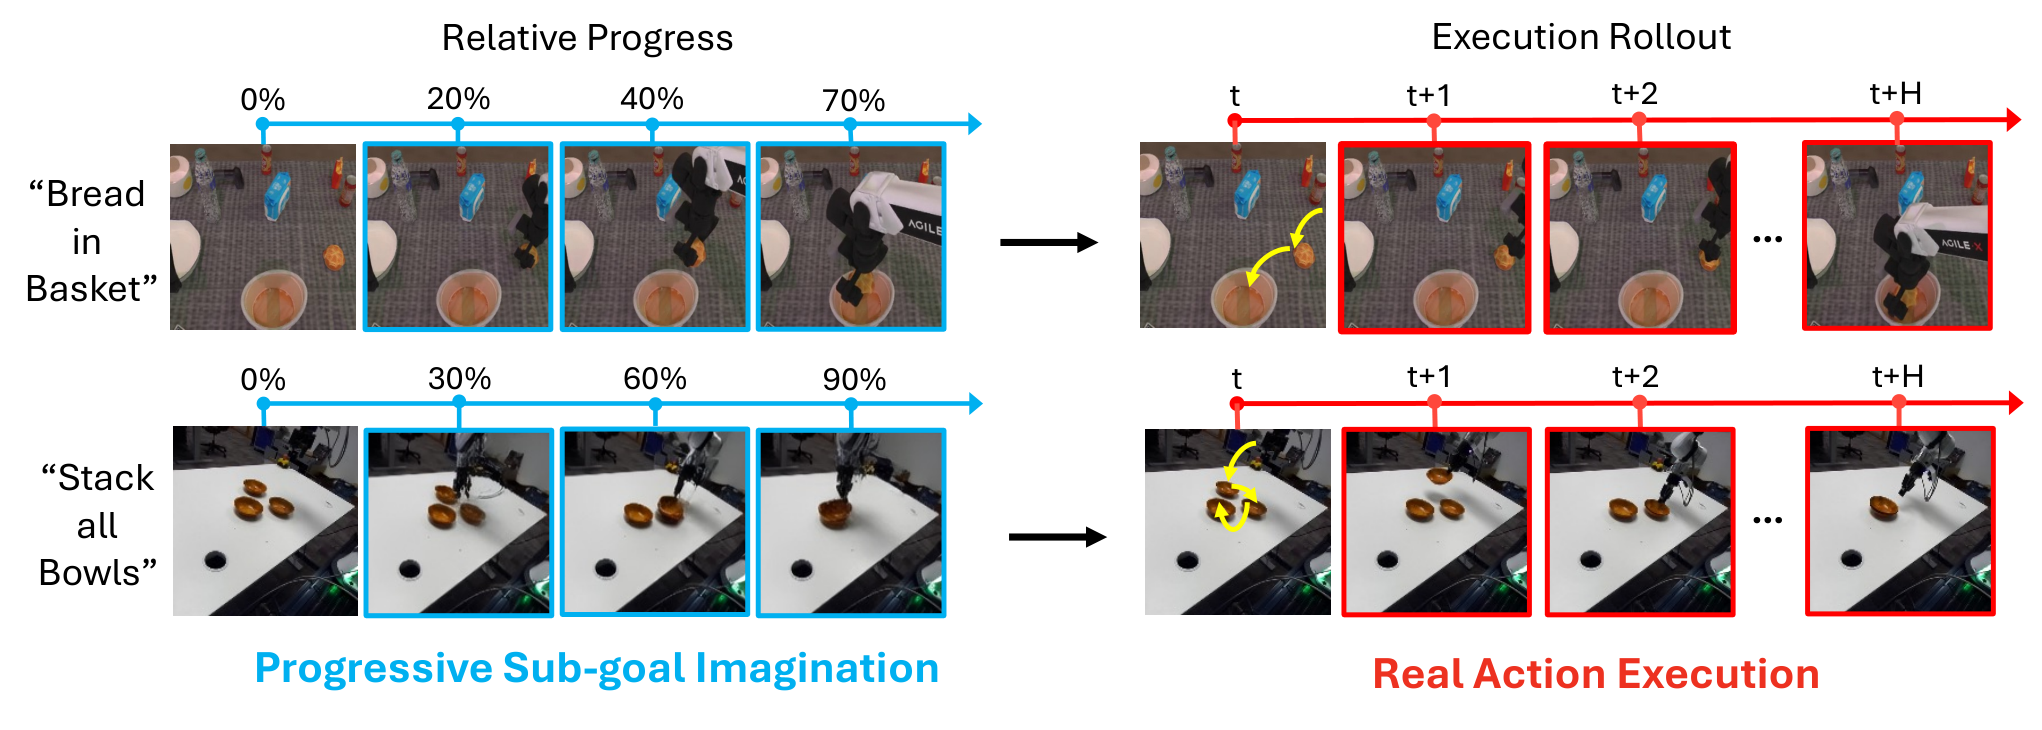
Figure 1 — 제안 모델의 핵심 개념
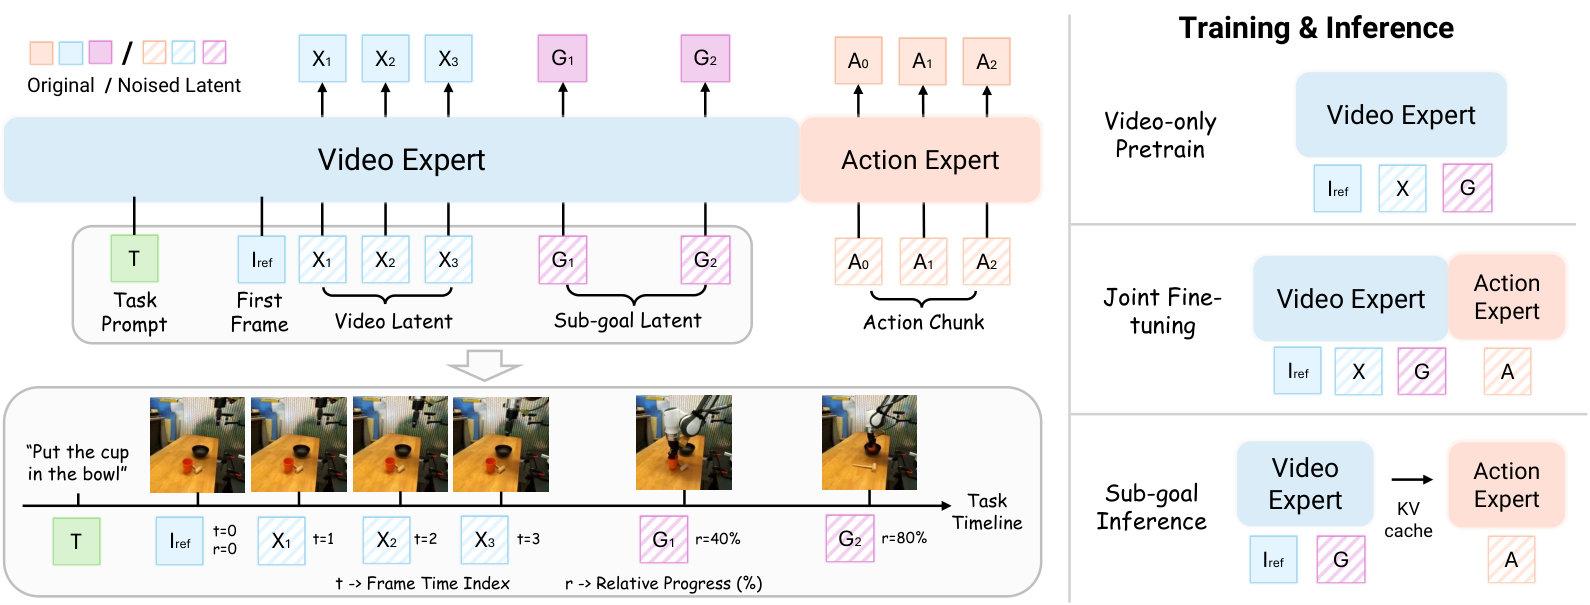
Figure 2 — ProWAM 전체 아키텍처
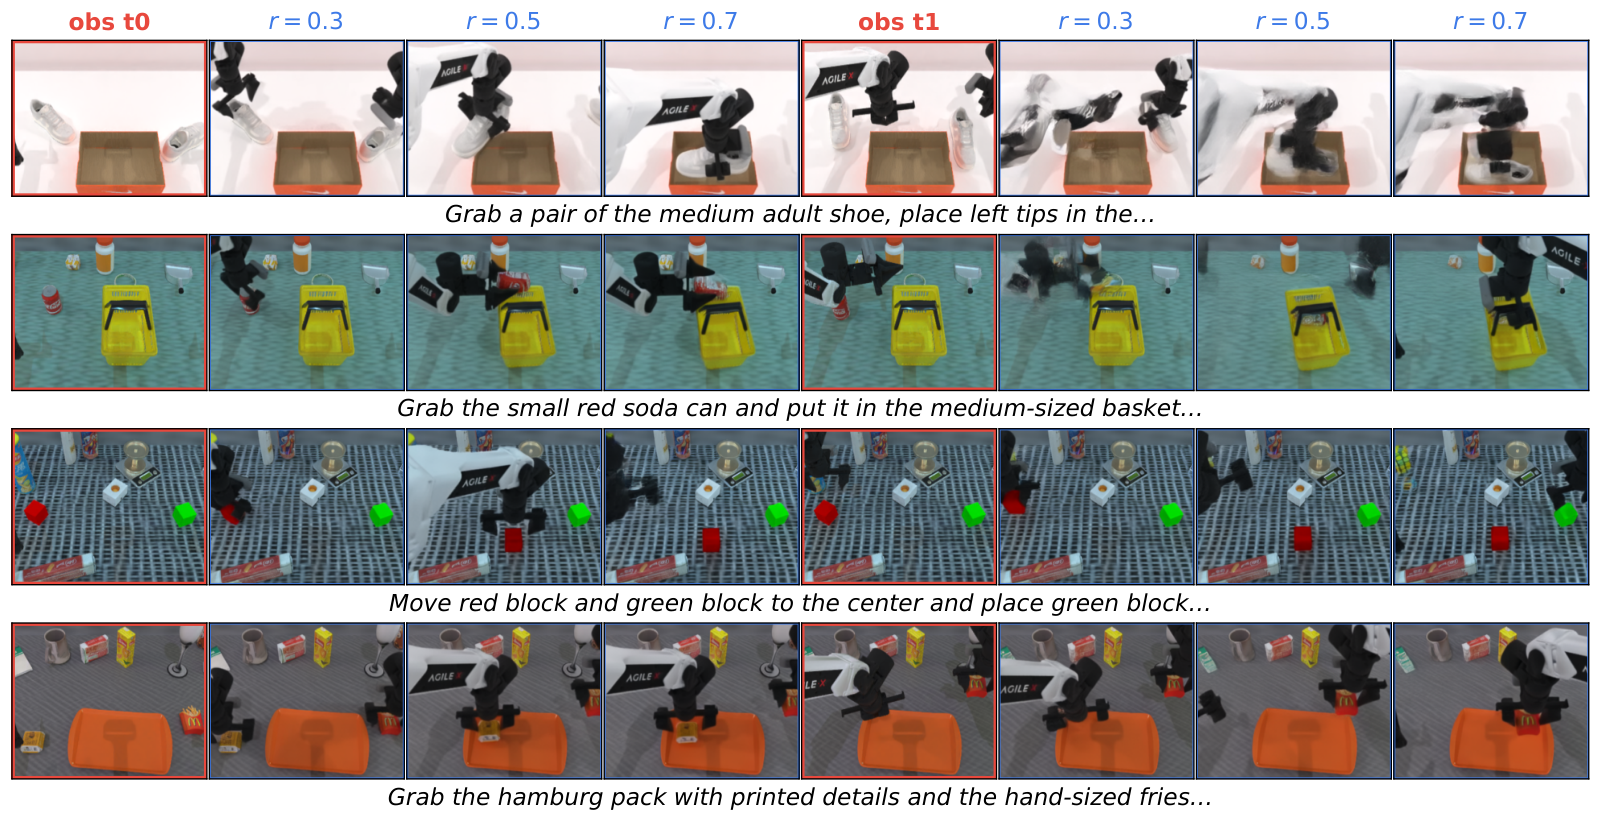
Figure 4 — 효율성 및 Ablation 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] ProgAgent: Learning Tool Orchestration through Programmatic Training
- [논문리뷰] Acting Through Registers
- [논문리뷰] Scaling Agentic Data for Long-Horizon Terminal Intelligence
- [논문리뷰] TextReg: Mitigating Prompt Distributional Overfitting via Regularized Text-Space Optimization
- [논문리뷰] ASCENT: Online Test-Time Training of Long-Horizon Agents via Self-Distillation of Verified Experience
Review 의 다른글
- 이전글 [논문리뷰] Where Does Retrieval-Based Open-Ended Evaluation Fail? Automatic Taxonomy Induction from Long-Form Medical Answer Factuality Verification
- 현재글 : [논문리뷰] World Action Modeling with Progressive Visual Planning
- 다음글 [논문리뷰] World Embedding Benchmark
댓글