[논문리뷰] Where Do Vision Language Models Fail at 3D Reasoning?
링크: 논문 PDF로 바로 열기
메타데이터
저자: Khai Le-Duc, Nguyen Kim Hai Bui, An Ngo, Nam D. Hoang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- BedBench: 저자들이 제안한 13가지의 절차적 생성(procedurally generated) 3D 공간 추론 과제 세트로, 개별적인 판단부터 구조적 추론까지 포괄적으로 평가함.
- Individual Judgment: 모델이 객체의 특정 속성(예: 전체 블록 수, 특정 색상 개수)에 대해 단일 답변을 생성하는 판단 작업.
- Exact Answer: 모든 수치, 속성, 그리고 그들 간의 연관성이 정확하게 일치해야만 정답으로 간주되는 구조화된 답변.
- Consistent Use: 모델이 특정 속성에 대해 내린 판단(예: 색상별 개수)과 해당 정보에 기반한 후속 질문(예: 가장 많은 색상)이 논리적으로 일치하는지 여부.
- Visual-Feature Probe: 모델의 내부 시각적 표현(Visual representation)에 특정 정보(예: 정확한 개수)가 포함되어 있는지 확인하기 위해 설계된 선형 탐지기(Linear probe).
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Vision Language Models(VLMs)가 개별적인 공간 정보 판단은 수행할 수 있으나, 3D 객체의 속성을 정확하게 복원하고 이를 일관되게 활용하는 데 실패하는 문제를 해결하고자 한다. 기존 연구들은 단순히 모델의 최종 점수(Accuracy)를 측정하는 데 그쳐, 모델이 시각적 증거에 기반하여 추론하는지 혹은 단순한 언어적 편향(Language priors)이나 프롬프트 구조에 의존하는지 구분하지 못한다는 한계가 있다. 저자들은 개별 점수가 높은 모델이 실제 3D 구조를 완전히 이해하고 있는지 확인하기 위해, 정밀한 ground truth를 제공하는 BedBench를 도입하였다 [Figure 1]. 이를 통해 시각적 증거의 유무가 답변의 정확도에 미치는 영향을 제어하고, 모델이 시각적 정보를 획득하고도 이를 적절히 사용하지 못하는 근본적인 원인을 규명하고자 한다.
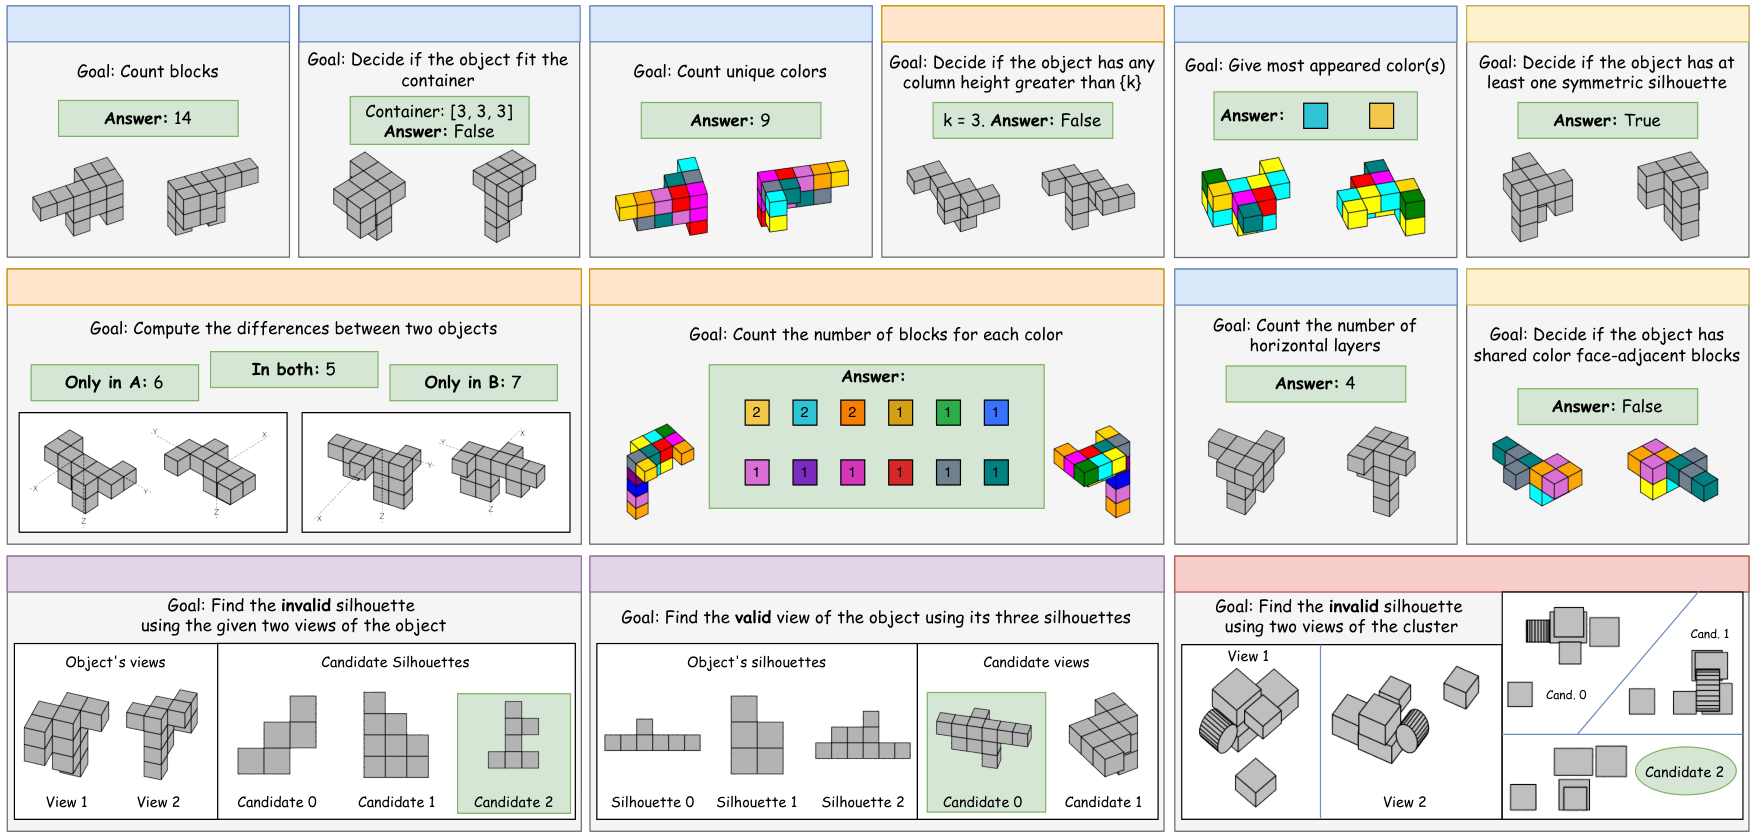
Figure 1 — BedBench의 13가지 3D 추론 과제
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 12개의 open-weight 모델과 4개의 frontier 모델을 대상으로 BedBench 내 13개 과제를 평가하고, 시각적 표현의 활용 여부를 확인하기 위해 Frozen feature 기반의 probe를 설계하였다. 실험 결과, 3D 객체의 per-color counting 과제에서 인간은 93.3%의 정확도를 보인 반면, 최고 성능의 VLM은 7.2%에 그쳐 현격한 격차를 드러냈다. 특정 모델에 대한 Targeted fine-tuning을 수행하여 해당 과제 정확도를 68.6%까지 향상시켰으나, 모델이 스스로 계산한 색상별 개수와 가장 많은 색상을 묻는 질문 간의 불일치가 지속되는 것을 확인하였다. 또한, Qwen3.5-27B 모델을 대상으로 한 probing 분석 결과, 언어 모델 입력 단에서 실제 색상 개수는 65.0%의 정확도로 복원 가능함에도 불구하고, 모델의 최종 답변 정확도는 3.0%에 머물렀다. 이는 모델이 필요한 시각적 정보를 시각적 front-end에서 이미 보유하고 있음에도 불구하고, 추론 과정에서 이를 적절히 통합하거나 일관되게 사용하는 데 실패함을 시사한다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 VLM이 개별적인 정보 획득 능력과 실제 3D 구조를 활용한 추론 능력 사이에서 심각한 괴리를 보이고 있음을 입증하였다. 실험 결과, 모델의 크기 확장(Scaling), 추가적인 추론 시간 제공(Thinking budget), 혹은 보조적인 시각적 큐(Visual cues)를 활용하는 방식으로는 복잡한 3D 공간 추론의 불확실성을 완벽히 해소할 수 없었다. 따라서 저자들은 단순히 전체적인 Accuracy를 측정하는 것에서 벗어나, 정확한 구조적 답변의 신뢰성, 논리적 일관성, 그리고 이미지에 대한 실제 의존성을 종합적으로 평가해야 한다고 강조한다. 이 연구는 차세대 VLM의 시각적 추론 성능을 향상시키기 위해 모델의 구조적 이해와 시각적 데이터 활용 능력을 개선해야 한다는 중요한 방향성을 제시한다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] JigShape: Evaluating Visual-Geometric Reasoning in VLMs through Jigsaw Puzzles
- [논문리뷰] Thinking with Visual Grounding
- [논문리뷰] Humans in Space: Can MLLMs Construct Human-Centric Spatial Understanding via Active Exocentric Exploration?
- [논문리뷰] Holi-World: Building Holistic World Intelligence from Human-Ego Experience
- [논문리뷰] BlenderWorld: Benchmarking Visual Agents for 3D Creation from Real-World References
Review 의 다른글
- 이전글 [논문리뷰] When Morphs Look Better: Face Image Quality as a Training-Free Signal for Morphing Attack Detection
- 현재글 : [논문리뷰] Where Do Vision Language Models Fail at 3D Reasoning?
- 다음글 [논문리뷰] WorldFlow: Joint Video and 3D Motion Prediction via Large-Scale Pretraining
댓글